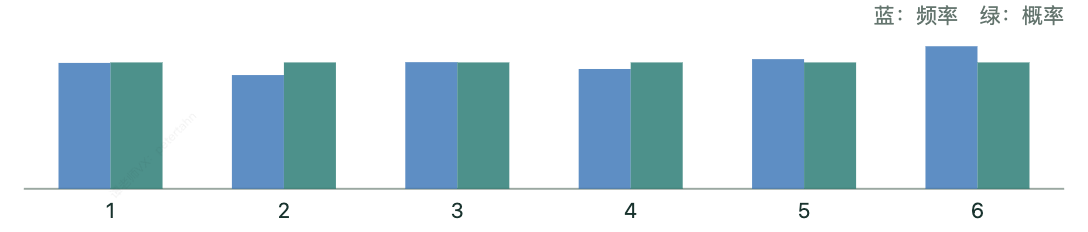前言

前言

本讲义是“概率与数理统计”专题知识课的配套文字版,内容与课堂上使用的交互课件一一对应,共 4 章、18 个专题,覆盖条件概率、全概率与贝叶斯、随机变量及其分布、统计与回归、独立性检验,以及大学数理统计初步。

每个专题怎么读

每个专题自成一节,大体按课堂的节奏展开:

  1. 看见:先从图形或具体数据出发,看清现象;
  2. 推导:把观察到的规律严格写出来,每一步后面的楷体小字说明“为什么这样做”;
  3. 方法与易错:总结什么时候想到它、怎么用、容易错在哪里;
  4. 例题:选自高考真题与优质模拟题,给出完整解答,部分题目给出多种解法;
  5. 课堂小测:几道概念辨析小题,答案与解析附在题目后面,建议先做再看。

版式约定

思路与要点

浅紫色框:解题思路、关键观察、规律总结。

注意

浅黄色框:需要特别留意的条件和细节。

易错

浅红色框:常见错误与辨析。

结论卡

白底紫框:需要记住的公式与二级结论。

标有提高压轴的内容难度较高,可按自己的目标选读。书中插图取自课堂交互课件中的动态图形,是某一时刻的静态画面,图注说明了图中各部分的含义。

专题 01

条件概率:在“新世界”里重新数一遍

知道 $B$ 已经发生,就等于把样本空间缩小成 $B$。$P(A\mid B)$ 问的是:在 $B$ 里面,$A$ 占多大比例?

看见:缩小样本空间

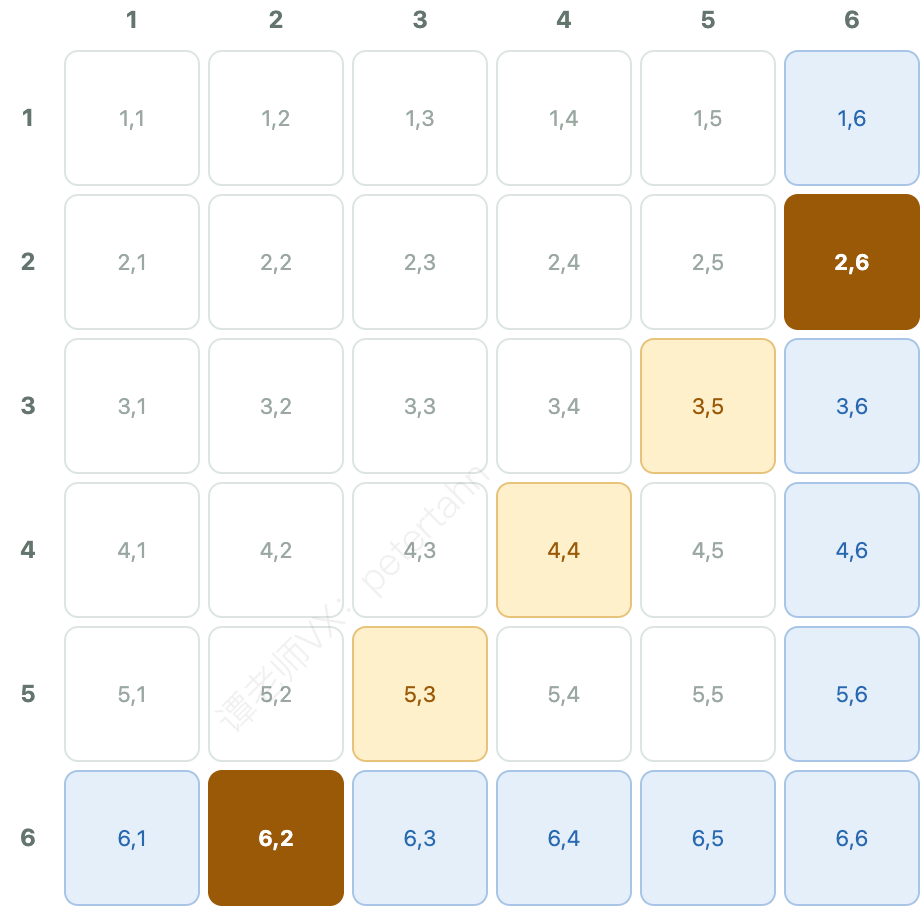
掷两颗骰子:36 个等可能的结果

掷两颗骰子,记第一颗点数为 $a$、第二颗点数为 $b$,共 36 个等可能的结果 $(a,b)$。取事件

  • $A$:点数和为 8;
  • $B$:至少一颗是 6。
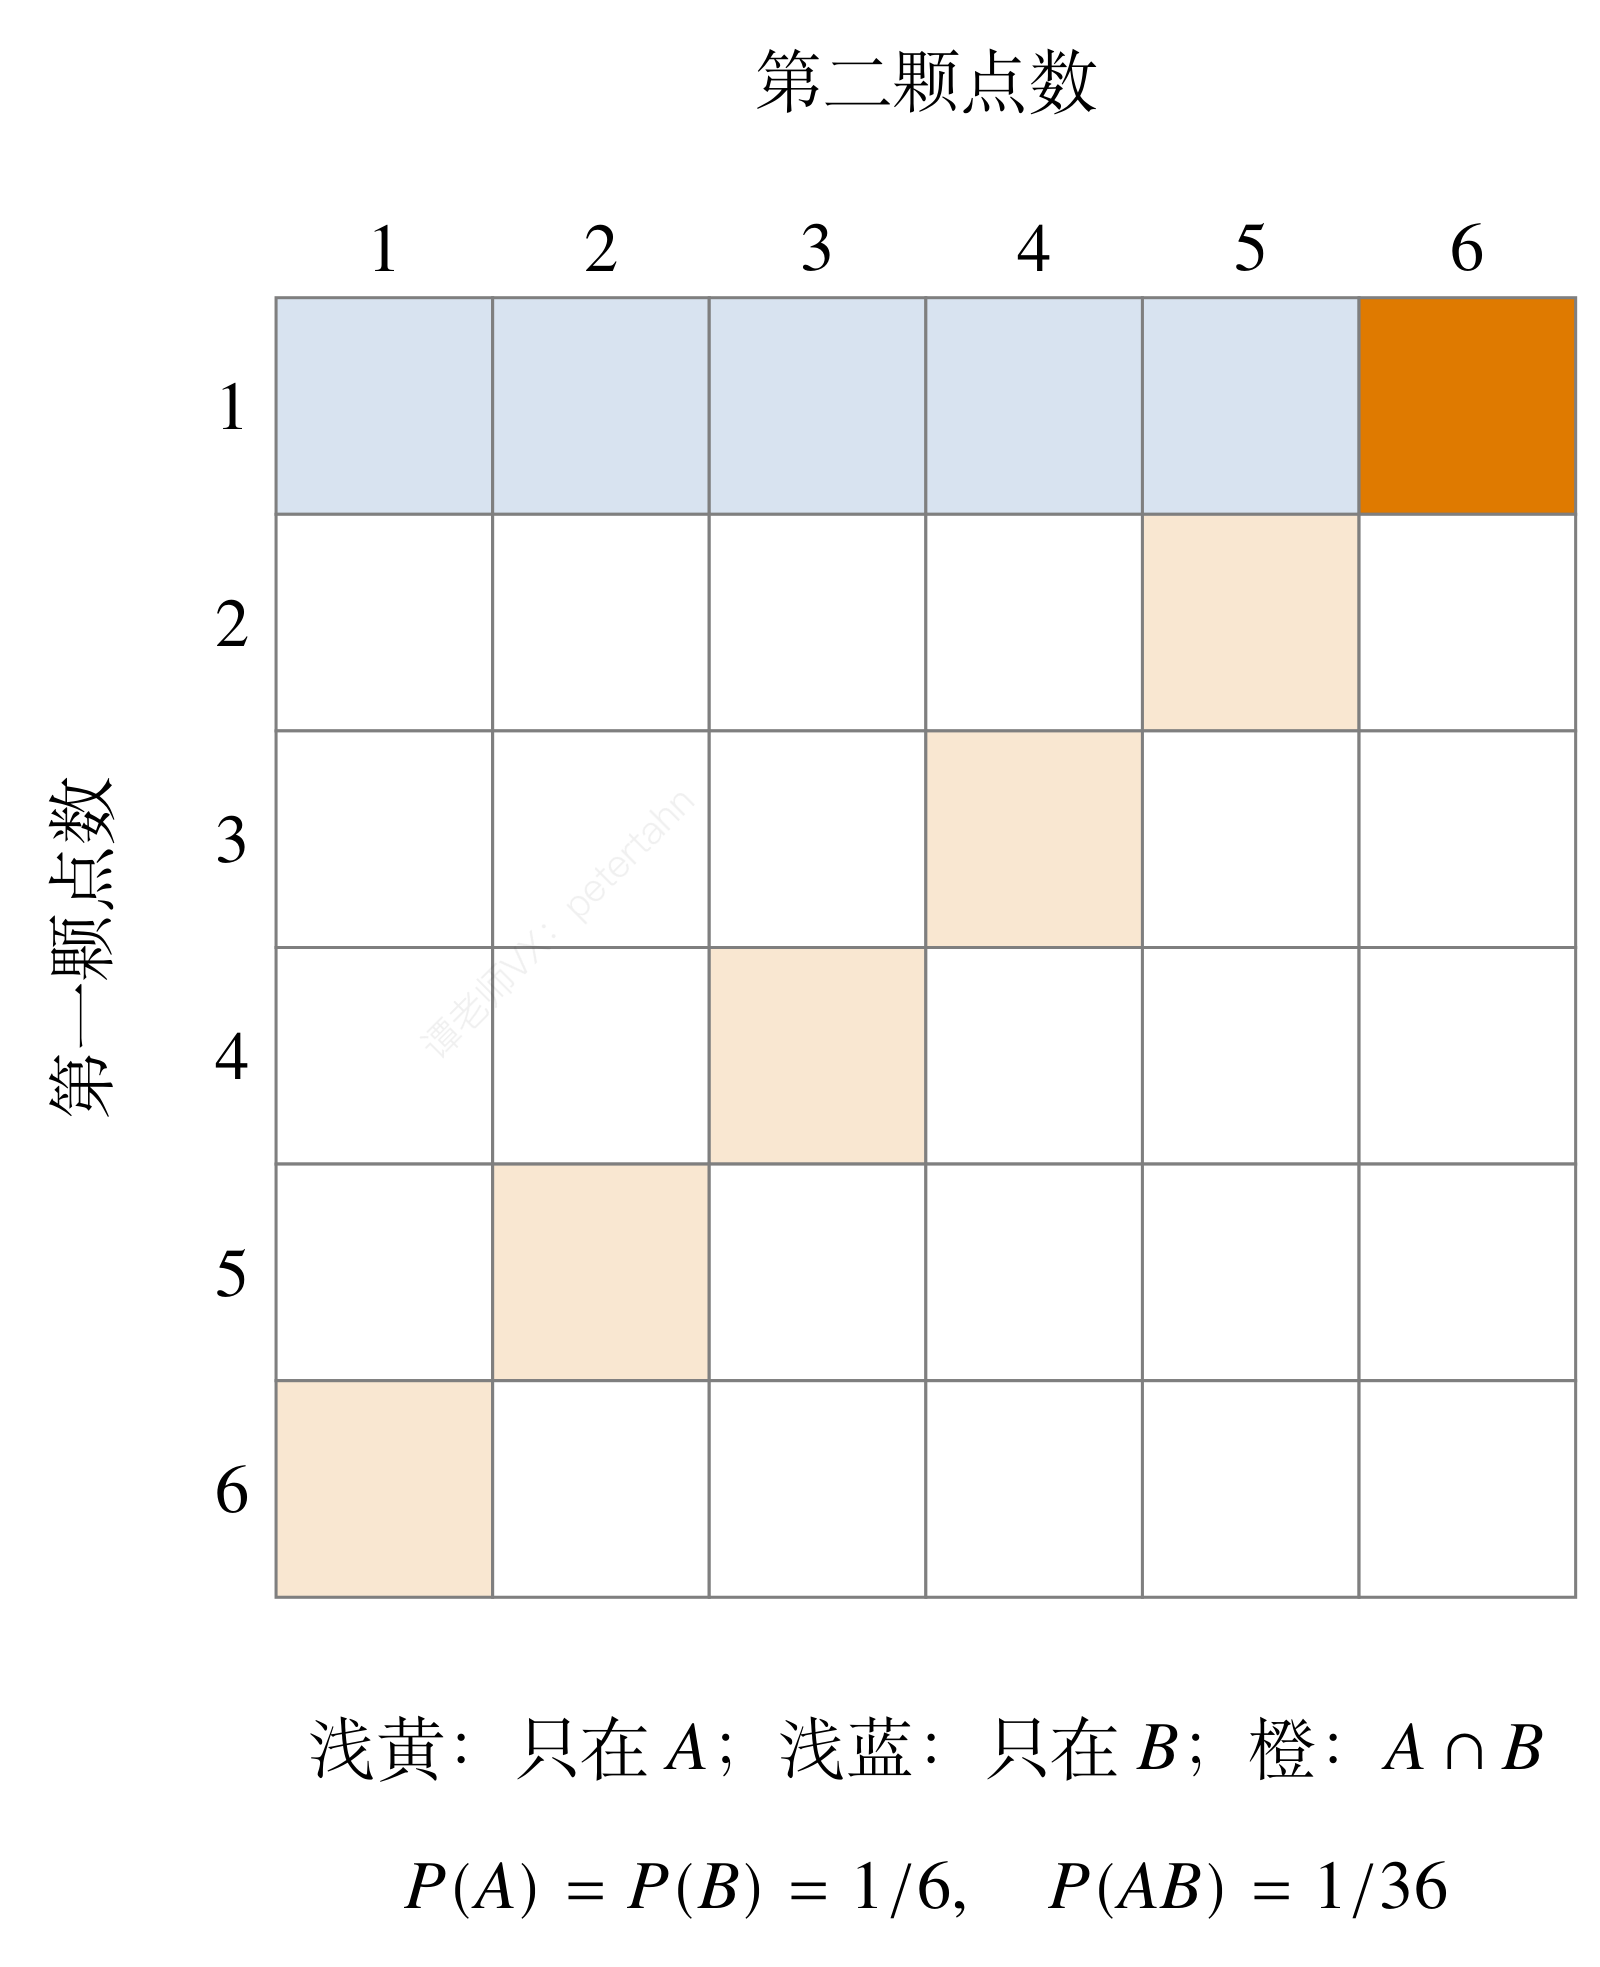
掷两颗骰子的 36 个结果(行为第一颗点数,列为第二颗点数)。浅蓝格只在 B 中(至少一颗是 6),浅黄格只在 A 中(点数和为 8),深橙格 (2,6)、(6,2) 是 A\cap B。已知 B 发生,就把浅蓝和深橙以外的格子全部划去,剩下的 11 格就是“新世界”
图 1掷两颗骰子的 36 个结果(行为第一颗点数,列为第二颗点数)。浅蓝格只在 $B$ 中(至少一颗是 6),浅黄格只在 $A$ 中(点数和为 8),深橙格 $(2,6)$、$(6,2)$ 是 $A\cap B$。已知 $B$ 发生,就把浅蓝和深橙以外的格子全部划去,剩下的 11 格就是“新世界”

两种数法,同一个答案

$$ \begin{aligned} P(A\mid B)&=\frac{n(AB)}{n(B)}=\frac{2}{11}\\ &=\frac{P(AB)}{P(B)}=\frac{2/36}{11/36} \end{aligned} $$

把三个概率放在一起比较:

  • 在全世界里:$P(A)=\dfrac{5}{36}$;
  • 在 $B$ 里:$P(A\mid B)=\dfrac{2}{11}$;
  • 在 $A$ 里:$P(B\mid A)=\dfrac{2}{5}$。
思路

$P(A\mid B)>P(A)$:知道 $B$ 发生后,$A$ 变得更可能了。

注意 $P(A\mid B)\ne P(B\mid A)$:分母不同(一个是 $n(B)$,一个是 $n(A)$)。

关键动作

分母从 36 换成了 $n(B)$。条件概率不是新理论,只是换了一个样本空间重新做古典概型。

换几组事件再数一数

同样的数法用于其他事件。下面两张表中,最后一列比较 $P(A\mid B)$ 与 $P(A)$:“$>$”表示知道 $B$ 发生后 $A$ 变得更可能,“$<$”表示变得更不可能。

表 1 固定 $B$:至少一颗是 6($n(B)=11$),换事件 $A$。

事件 $A$ $n(A)$ $n(AB)$ $P(A)$ $P(A\mid B)$ $P(B\mid A)$ 比较
点数和为 8 5 2 $\frac{5}{36}$ $\frac{2}{11}$ $\frac25$ $>$
点数和 $\ge 9$ 10 7 $\frac{5}{18}$ $\frac{7}{11}$ $\frac{7}{10}$ $>$
第一颗是 6 6 6 $\frac16$ $\frac{6}{11}$ $1$ $>$
至少一颗是 6 11 11 $\frac{11}{36}$ $1$ $1$ $>$
第一颗是奇数 18 3 $\frac12$ $\frac{3}{11}$ $\frac16$ $<$
两颗点数相同 6 1 $\frac16$ $\frac{1}{11}$ $\frac16$ $<$
点数和为偶数 18 5 $\frac12$ $\frac{5}{11}$ $\frac{5}{18}$ $<$
点数差 $\ge 3$ 12 6 $\frac13$ $\frac{6}{11}$ $\frac12$ $>$

表 2 固定 $A$:点数和为 8($n(A)=5$,$P(A)=\frac{5}{36}$),换事件 $B$。

事件 $B$ $n(B)$ $n(AB)$ $P(A\mid B)$ $P(B\mid A)$ 比较
至少一颗是 6 11 2 $\frac{2}{11}$ $\frac25$ $>$
点数和为 8 5 5 $1$ $1$ $>$
点数和 $\ge 9$ 10 0 $0$ $0$ $<$
第一颗是 6 6 1 $\frac16$ $\frac15$ $>$
第一颗是奇数 18 2 $\frac19$ $\frac25$ $<$
两颗点数相同 6 1 $\frac16$ $\frac15$ $>$
点数和为偶数 18 5 $\frac{5}{18}$ $1$ $>$
点数差 $\ge 3$ 12 2 $\frac16$ $\frac25$ $>$

推导:定义与乘法公式

从古典概型推出一般定义

  1. 古典概型中,已知 $B$ 发生,样本空间缩成 $B$,$A$ 发生当且仅当结果落在 $A\cap B$:

    $$P(A\mid B)=\frac{n(AB)}{n(B)}$$

    在“新世界” $B$ 里数格子

  2. 分子分母同除以 $n(\Omega)$:

    $$P(A\mid B)=\frac{n(AB)/n(\Omega)}{n(B)/n(\Omega)}=\frac{P(AB)}{P(B)}$$

    这一步把“数格子”变成“比面积”,从而不再依赖等可能

  3. 定义(一般情形):设 $P(B)>0$,

    $$P(A\mid B)\overset{\text{def}}{=}\frac{P(AB)}{P(B)}$$

    $P(B)=0$ 时无定义——“不可能发生的条件”没有意义

  4. 乘法公式:把定义反过来写

    $$ \begin{aligned} P(AB)&=P(B)\,P(A\mid B)\\ &=P(A)\,P(B\mid A) \end{aligned} $$

    “先 $B$ 后 $A$”与“先 $A$ 后 $B$”两条路,都走到同一个 $AB$

  5. 推广到多个事件(链式法则):

    $$ \begin{aligned} P(A_1A_2\cdots A_n)=\ &P(A_1)P(A_2\mid A_1)P(A_3\mid A_1A_2)\\ &\cdots P(A_n\mid A_1\cdots A_{n-1}) \end{aligned} $$

    树状图上沿一条路径把分支概率连乘

  6. $P(\,\cdot\mid B)$ 本身满足概率的全部公理,所以普通概率公式都能“加上 $\mid B$”照用:

    $$ \begin{aligned} &P(\bar A\mid B)=1-P(A\mid B)\\ &P(A_1\cup A_2\mid B)\\ &\quad=P(A_1\mid B)+P(A_2\mid B)-P(A_1A_2\mid B) \end{aligned} $$

    条件概率就是一个新的概率测度

  7. 独立性的自然由来:若知道 $B$ 不改变 $A$ 的概率,即 $P(A\mid B)=P(A)$,代入定义得

    $$P(AB)=P(A)P(B)$$

    这就是独立的定义;它对称,且 $P(B)=0$ 时也能用

条件概率与乘法公式

设 $P(B)>0$,

$$P(A\mid B)=\frac{P(AB)}{P(B)}$$

乘法公式:

$$P(AB)=P(B)\,P(A\mid B)=P(A)\,P(B\mid A)$$

面积模型:看比例

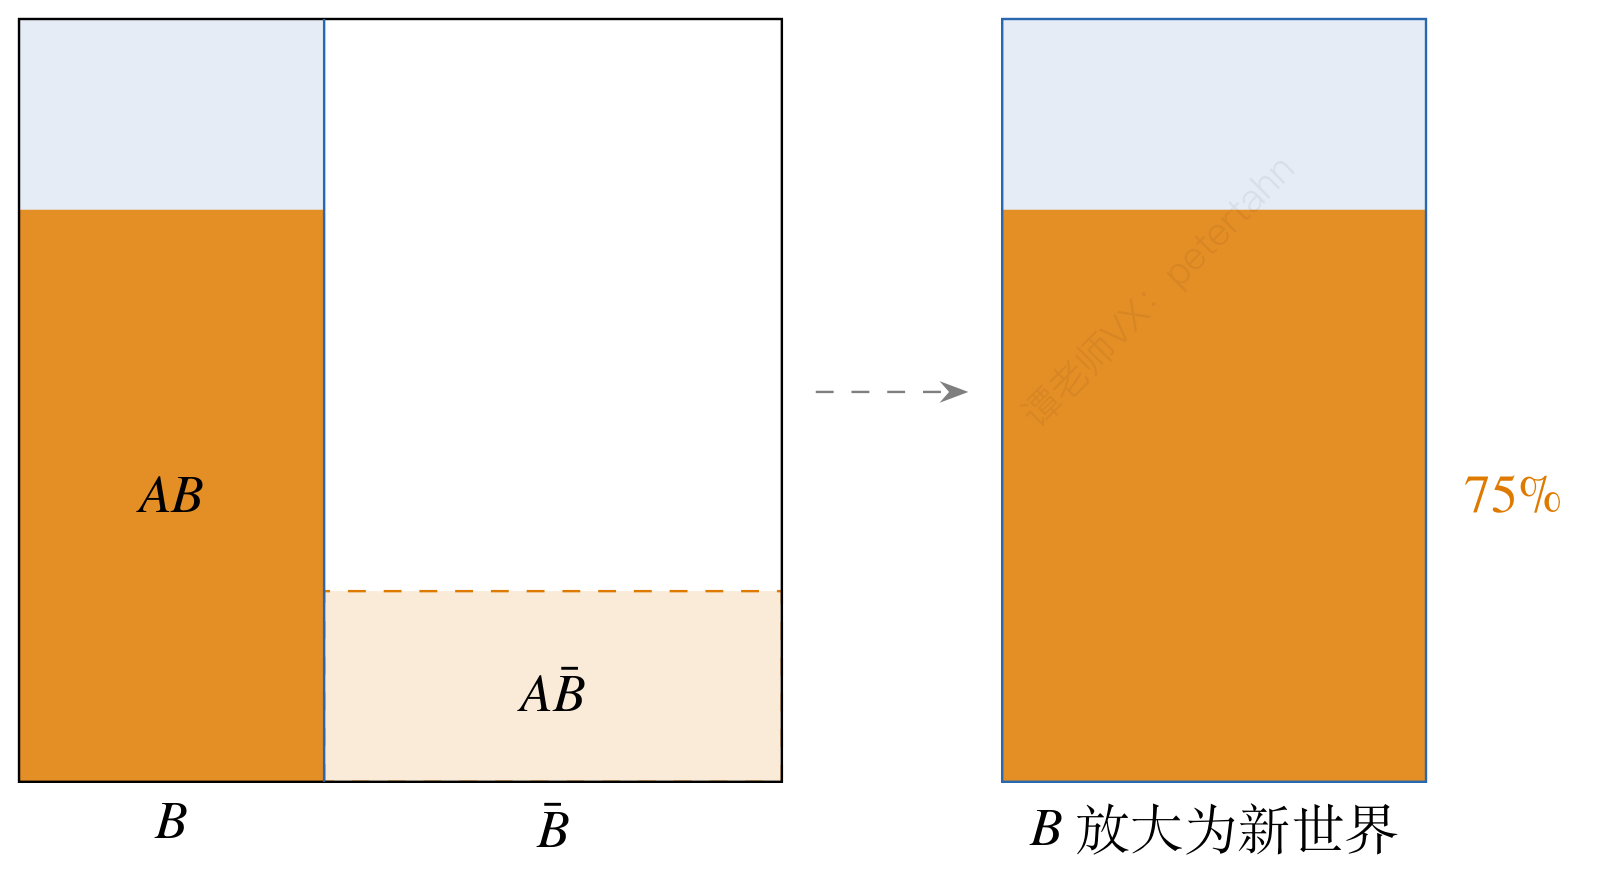
单位正方形面积 $=1$。蓝色竖条是 $B$,橙色是 $A$ 落在 $B$ 内外的部分。图中取 $P(B)=0.40$,$P(A\mid B)=0.75$,$P(A\mid\bar B)=0.25$。

条件概率面积模型:B 宽为 0.40,AB 占 B 的 75\%;右图把 B 放大为新世界。
图 2条件概率面积模型:$B$ 宽为 $0.40$,$AB$ 占 $B$ 的 $75\%$;右图把 $B$ 放大为新世界。

$$ \begin{aligned} P(AB)&=P(B)P(A\mid B)=0.40\times0.75=0.30\\ P(A)&=P(AB)+P(A\bar B)\\ &=0.30+0.15=0.45\\ P(B\mid A)&=\frac{P(AB)}{P(A)}\approx0.6667 \end{aligned} $$

频率:模拟验证

频率视角:只统计 B 发生的那些试验

$$\text{条件频率}=\frac{A\text{、}B\text{ 同时发生的次数}}{B\text{ 发生的次数}}$$

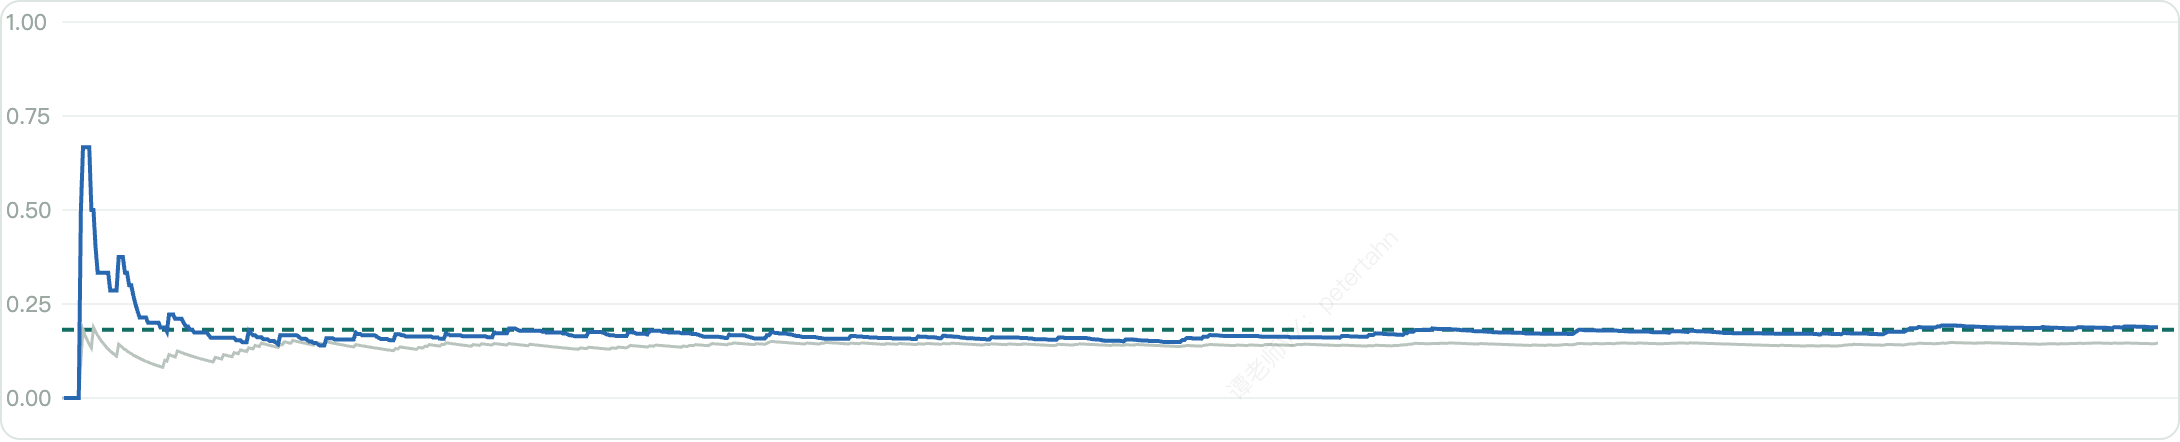
$B$ 没发生的试验直接丢弃——这正是“缩小样本空间”的实验含义。事件仍取第 1 节的 $A$(点数和为 8)与 $B$(至少一颗是 6)。

一次掷 1000 次的模拟记录如下:

总次数 $B$ 发生 $A$、$B$ 都发生 条件频率 理论 $P(A\mid B)$ 对照:$A$ 的频率
1000 287 54 0.1882 $\frac{2}{11}$ 0.1460
1000 次模拟中频率随试验次数的变化。蓝线是条件频率,绿虚线是理论值 P(A\mid B)=\frac{2}{11},灰线是不加条件的 A 的频率。蓝线逐渐贴近绿虚线,并始终在灰线上方
图 31000 次模拟中频率随试验次数的变化。蓝线是条件频率,绿虚线是理论值 $P(A\mid B)=\frac{2}{11}$,灰线是不加条件的 $A$ 的频率。蓝线逐渐贴近绿虚线,并始终在灰线上方
提示

$B$ 越“稀有”,有效样本越少,条件频率(蓝线)收敛越慢。

辨析:最易混的三对

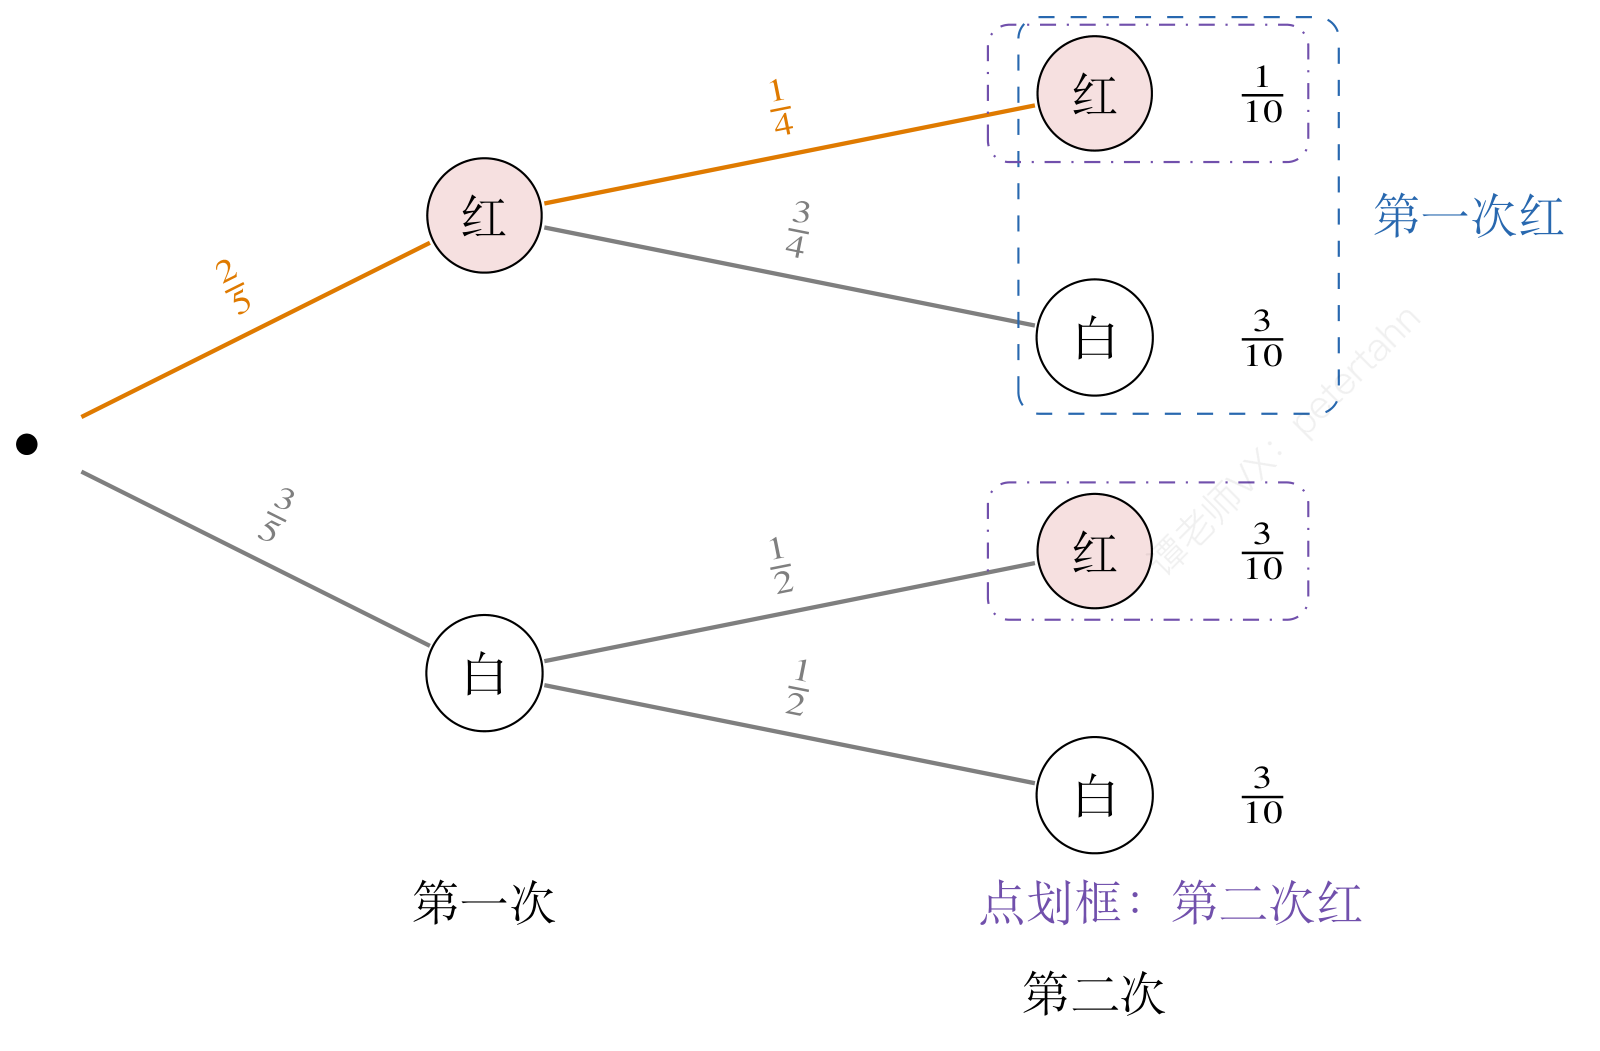
不放回摸球:袋中 2 红 3 白,依次摸两次

记 $A_1$:第一次摸到红球,$A_2$:第二次摸到红球。考虑四个问题:

① 两次都红;② 已知第一次红,第二次红;③ 第二次红;④ 已知第二次红,第一次红。

不放回摸球树:橙色为红红路径;蓝虚框为第一次红,紫点划框为第二次红。四条路径概率依次为 1/10,3/10,3/10,3/10。
图 4不放回摸球树:橙色为红红路径;蓝虚框为第一次红,紫点划框为第二次红。四条路径概率依次为 $1/10,3/10,3/10,3/10$。

四问辨析

① 积事件:沿“红→红”一条路径连乘。

$$ \begin{aligned} P(A_1A_2)&=P(A_1)P(A_2\mid A_1)\\ &=\frac{2}{5}\times\frac{1}{4}=\frac{1}{10} \end{aligned} $$

② 条件概率:站在“第一次红”这个节点上,只看下一条分支($r$ 为红球数,$n$ 为球的总数):

$$P(A_2\mid A_1)=\frac{r-1}{n-1}=\frac14$$

也可以用定义:$\dfrac{P(A_1A_2)}{P(A_1)}=\dfrac{1/10}{2/5}=\dfrac14$。

③ 全概率:第二次红有两条路径,相加:

$$P(A_2)=\frac{1}{10}+\frac{3}{10}=\frac25$$

恰好等于 $P(A_1)=\dfrac25$:抽签与顺序无关。

④ 逆向条件概率(贝叶斯的雏形):条件“第二次红”在后,问的是前面:

$$P(A_1\mid A_2)=\frac{P(A_1A_2)}{P(A_2)}=\frac{1/10}{2/5}=\frac14$$

和 ② 的数值相同,这是不放回摸球的对称性,并非一般规律。

读题信号

“已知…”“在…的条件下”“若…则…的概率” → 条件概率,分母变;“…且…”“…都…” → 积事件,沿路径连乘。

抽签公平

③ 的结果恰好等于第一次摸红的概率——不放回摸球与“先后顺序”无关。用全概率公式(下一模块)可严格证明。

互斥 ≠ 独立

若 $A$、$B$ 互斥且 $P(A)$、$P(B)>0$,则 $P(A\mid B)=0\ne P(A)$,一定不独立。互斥说的是“不能同时发生”,独立说的是“互不影响”——互斥恰恰影响最大。

例题精讲

高斯取整与条件概率

例 12024 济南三月模拟

抛掷甲、乙两枚质地均匀的骰子,所得点数分别为 $a,b$,记 $X=\left[\dfrac ba\right]$($[x]$ 表示不超过 $x$ 的最大整数)。

(1)求在 $X>0$ 的条件下,$X=\dfrac ba$ 的概率;

(2)求 $X$ 的分布列及数学期望。

建模思路

古典概型下的条件概率 = 在“新世界” $A$ 里数格子。把 36 个结果画成 $6\times6$ 方格,两个条件都变成方格里的区域。

解析

(1)在 $X>0$ 的条件下,$X=\dfrac ba$ 的概率

  1. 设 $A=\{X>0\}$,$B=\left\{X=\dfrac ba\right\}$。样本空间 $n(\Omega)=36$。

  2. $X>0\iff\left[\dfrac ba\right]\ge1\iff \dfrac ba\ge1\iff b\ge a$。

    取整后 $\ge1$ 等价于原数 $\ge1$

  3. $n(A)$:对角线及其上方,$6+5+4+3+2+1=21$。

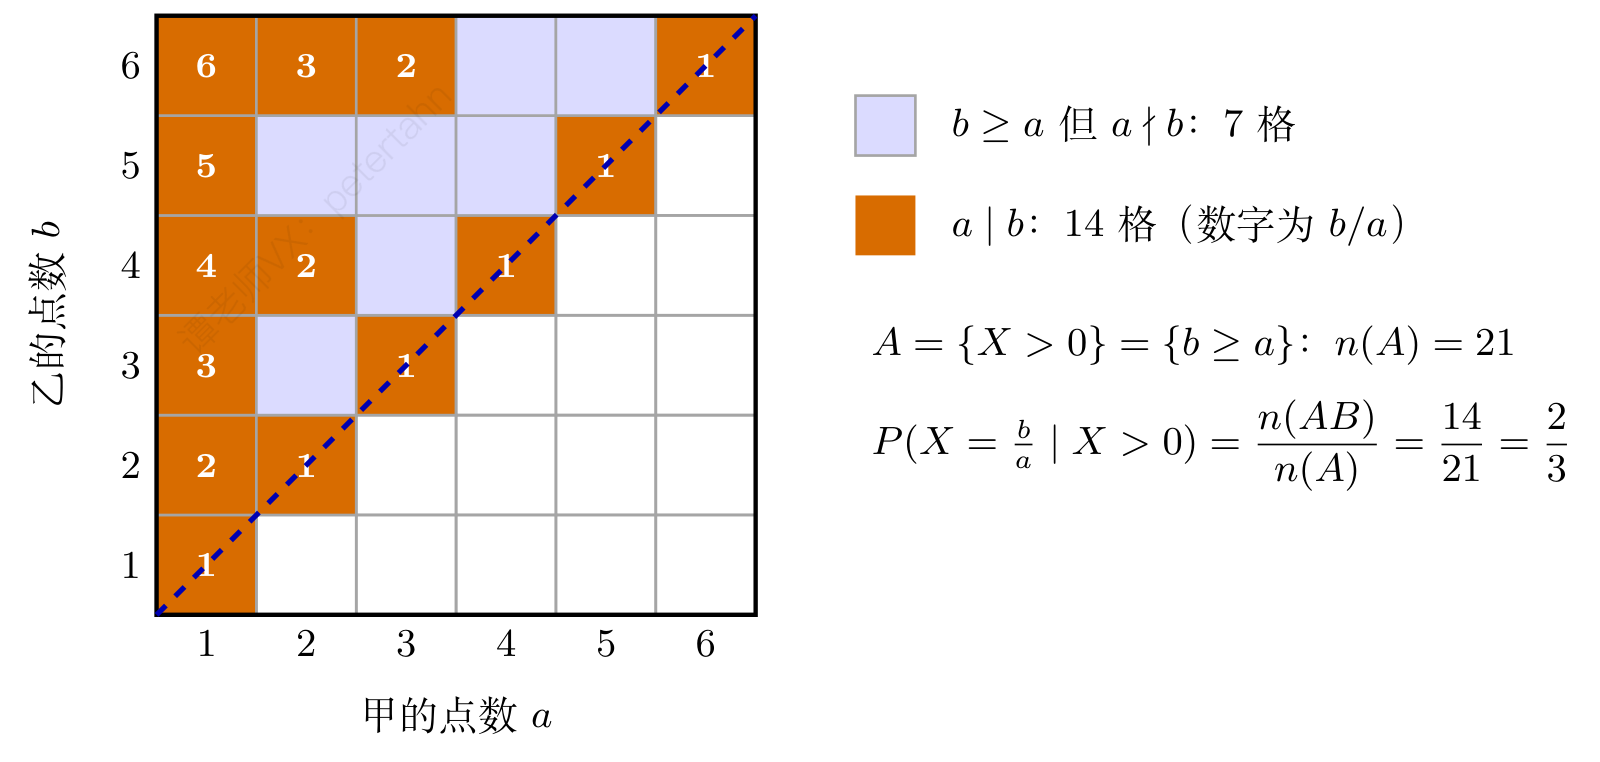
  4. $AB$:$\left[\dfrac ba\right]=\dfrac ba$ 即 $\dfrac ba$ 为正整数,即 $a\mid b$:$a=1$ 有 6 个,$a=2$ 有 $\{2,4,6\}$ 3 个,$a=3$ 有 $\{3,6\}$ 2 个,$a=4,5,6$ 各 1 个,$n(AB)=14$。

    6\times6 方格(横轴甲的点数 a,纵轴乙的点数 b),蓝虚线是对角线 b=a。橙色 14 格满足 a\mid b,即 AB,格中数字为 \frac ba;浅紫 7 格满足 b\ge a 但 a\nmid b。橙色与浅紫合起来 21 格就是新世界 A,故 P(B\mid A)=\frac{14}{21}=\frac23
    图 5$6\times6$ 方格(横轴甲的点数 $a$,纵轴乙的点数 $b$),蓝虚线是对角线 $b=a$。橙色 14 格满足 $a\mid b$,即 $AB$,格中数字为 $\frac ba$;浅紫 7 格满足 $b\ge a$ 但 $a\nmid b$。橙色与浅紫合起来 21 格就是新世界 $A$,故 $P(B\mid A)=\frac{14}{21}=\frac23$
  5. 由古典概型,

    $$P(B\mid A)=\frac{n(AB)}{n(A)}=\frac{14}{21}=\frac23$$

    分母是 21 而不是 36——这就是“缩小样本空间”

答案:$\dfrac23$

(2)$X$ 的分布列与期望

  1. $\dfrac16\le\dfrac ba\le6$,所以 $X\in\{0,1,2,3,4,5,6\}$。上图中橙色格的数字正是 $X$ 的部分取值。

  2. $X=0\iff b<a$:$15$ 个;$X=2$:$(1,2),(2,4),(2,5),(3,6)$ 共 4 个;$X=3$:$(1,3),(2,6)$;$X=4,5,6$ 各 1 个($a=1$)。

    先数容易的取值

  3. $X=1$ 用补数:$36-(15+4+2+1+1+1)=12$。

    避免枚举 $X=1$ 时漏数

  4. $X$ 的分布列:

    $X$ 0 1 2 3 4 5 6
    $P$ $\frac{15}{36}$ $\frac{12}{36}$ $\frac{4}{36}$ $\frac{2}{36}$ $\frac1{36}$ $\frac1{36}$ $\frac1{36}$
  5. 数学期望

    $$E(X)=\frac{0\cdot15+1\cdot12+2\cdot4+3\cdot2+4+5+6}{36}=\frac{41}{36}$$

答案:$E(X)=\dfrac{41}{36}$

易错

$X>0$ 不是 $b>a$,而是 $b\ge a$($b=a$ 时 $X=1$)。

无记忆性与几何分布

例 22024 湖南一起考大联考(二)

(节选第 2 问)植物寿命 $X$ 取正整数。对任意 $k\in\mathbf N^*$,寿命为 $k+1$ 的样本在寿命超过 $k$ 的样本中的占比,与寿命为 1 的样本在全体中的占比相同,均为 $0.1$。

(i) 求 $P(X=k)$;(ii) 推导 $E(X)$。

建模思路

“在寿命超过 $k$ 的样本里占比”就是条件概率 $P(X=k+1\mid X>k)$。把文字翻译成条件概率,再用定义化成递推。

解析

(i) 求 $P(X=k)$

  1. 翻译:$P(X=1)=0.1$,$P(X=k+1\mid X>k)=0.1$。

    “在…中的占比” = 条件概率,分母是“寿命超过 $k$”

  2. 由定义,$\{X=k+1\}\subseteq\{X>k\}$,所以交事件就是 $\{X=k+1\}$:

    $$\frac{P(X=k+1)}{P(X>k)}=0.1\ \Rightarrow\ P(X=k+1)=0.1\,P(X>k)$$

  3. 同理 $P(X=k)=0.1\,P(X>k-1)$($k\ge2$)。两式相减,并用 $P(X>k-1)-P(X>k)=P(X=k)$:

    $$ \begin{aligned} &P(X=k)-P(X=k+1)=0.1\,P(X=k)\\ \Rightarrow\ &P(X=k+1)=0.9\,P(X=k) \end{aligned} $$

    “相邻两式作差”是由前 $n$ 项关系得到相邻项关系的标准手法

  4. 验证 $k=1$:$P(X=2)=0.1\,P(X>1)=0.1\times0.9=0.9\,P(X=1)$,也成立。

    作差只对 $k\ge2$ 有效,首项要单独验证

  5. 所以 $\{P(X=k)\}$ 是首项 $0.1$、公比 $0.9$ 的等比数列:

    $$P(X=k)=0.1\times0.9^{k-1}$$

答案:$P(X=k)=0.1\times 0.9^{k-1}$

(ii) 推导 $E(X)$

  1. 记

    $$S_n=\sum_{k=1}^n k\cdot0.1\cdot0.9^{k-1},\qquad 0.9S_n=\sum_{k=1}^n k\cdot0.1\cdot0.9^{k}$$

  2. 错位相减:

    $$ \begin{aligned} 0.1S_n&=0.1\,(1+0.9+\cdots+0.9^{n-1})-n\cdot0.1\cdot0.9^n\\ &=1-0.9^n-0.1n\cdot0.9^n \end{aligned} $$

  3. $S_n=10-(n+10)\cdot0.9^n\to10$($n\to\infty$)。

    一般结论:几何分布 $E(X)=\dfrac1p$

答案:$E(X)=10$

易错

把“在寿命超过 $k$ 的样本里占比”误写成 $P(X=k+1)=0.1$,丢掉了条件。

风险比 $R$

例 32022 全国新高考 I 卷

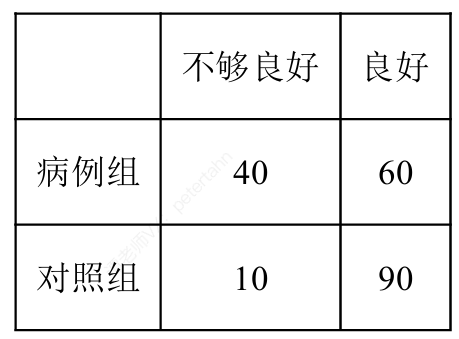
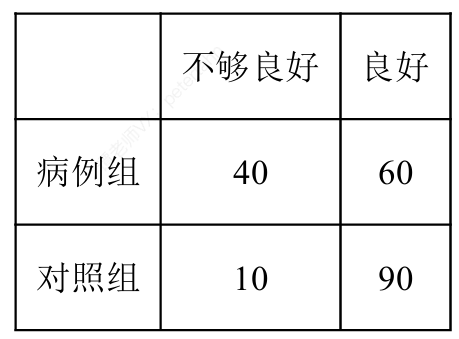
病例组 100 例、对照组 100 人的卫生习惯调查如下表。

不够良好 良好
病例组 40 60
对照组 10 90

(1)能否有 99% 的把握认为两组卫生习惯有差异?

(2)任选一人,$A$:卫生习惯不够良好,$B$:患该疾病。记

$$R=\frac{P(B\mid A)}{P(\bar B\mid A)}\Big/\frac{P(B\mid\bar A)}{P(\bar B\mid\bar A)}$$

(i) 证明 $R=\dfrac{P(A\mid B)}{P(\bar A\mid B)}\cdot\dfrac{P(\bar A\mid\bar B)}{P(A\mid\bar B)}$;

(ii) 估计 $P(A\mid B)$、$P(A\mid\bar B)$ 与 $R$。

建模思路

调查是“按病分组”抽样的:能估计的是 $P(A\mid B)$(病例组里习惯差的比例),不能直接估计 $P(B\mid A)$。(i) 的恒等式正是把“想要的” $R$ 换成“能估计的”量——这是贝叶斯思想的典型应用。

解析

(1)独立性检验

  1. $a=40,\ b=60,\ c=10,\ d=90,\ n=200$。

  2. 计算统计量:

    $$ \begin{aligned} K^2&=\frac{200(40\times90-60\times10)^2}{100\times100\times50\times150}\\ &=\frac{200\times3000^2}{7.5\times10^7}=24 \end{aligned} $$

  3. $24>6.635$,所以有 99% 的把握认为两组卫生习惯有差异。

    “有差异”= 拒绝“无关”的原假设

答案:有 99% 的把握认为有差异。

(2)(i) 证明恒等式

  1. 同一条件下的比值,分母 $P(A)$ 约掉:

    $$\frac{P(B\mid A)}{P(\bar B\mid A)}=\frac{P(AB)/P(A)}{P(A\bar B)/P(A)}=\frac{P(AB)}{P(A\bar B)}$$

    核心技巧:同条件的两个条件概率之比 = 交事件概率之比

  2. 同理 $\dfrac{P(B\mid\bar A)}{P(\bar B\mid\bar A)}=\dfrac{P(\bar AB)}{P(\bar A\bar B)}$,所以

    $$R=\frac{P(AB)\,P(\bar A\bar B)}{P(A\bar B)\,P(\bar AB)}$$

    这个对称形式就是“交叉乘积比”,即统计中的优势比 OR

  3. 重新分组,按条件 $B$、$\bar B$ 引入分母:

    $$ \begin{aligned} R&=\frac{P(AB)/P(B)}{P(\bar AB)/P(B)}\cdot\frac{P(\bar A\bar B)/P(\bar B)}{P(A\bar B)/P(\bar B)}\\ &=\frac{P(A\mid B)}{P(\bar A\mid B)}\cdot\frac{P(\bar A\mid\bar B)}{P(A\mid\bar B)} \end{aligned} $$

答案:证毕。

(2)(ii) 估计 $R$

  1. 病例组中习惯不够良好的频率估计 $P(A\mid B)=\dfrac{40}{100}=0.4$;对照组中估计 $P(A\mid\bar B)=\dfrac{10}{100}=0.1$。

  2. 补集:$P(\bar A\mid B)=0.6$,$P(\bar A\mid\bar B)=0.9$。

  3. 代入 (i) 的恒等式:

    $$R=\frac{0.4}{0.6}\times\frac{0.9}{0.1}=6$$

    也等于交叉乘积比 $\dfrac{ad}{bc}=\dfrac{40\times90}{60\times10}=6$。

    $R$ 与列联表的 $\dfrac{ad}{bc}$ 一致,可作检验

答案:$P(A\mid B)=0.4,\ P(A\mid\bar B)=0.1,\ R=6$

易错

用 $\dfrac{40}{50}$ 去估计 $P(B\mid A)$——这里病例组、对照组人数是人为定的各 100 人,表中纵向比例不能代表人群患病率。

课堂小测

课堂小测

一个家庭有两个孩子,已知至少有一个是男孩,两个都是男孩的概率是

查看答案与解析

答案C

解析

新世界 $B=${男男,男女,女男},其中 $A\cap B=${男男},所以 $P=\tfrac13$。

辨析
  • A:$\tfrac12$ 是“已知老大是男孩”的答案;“至少一个”时新世界是{男男,男女,女男},有 3 个结果。B:$\tfrac14$ 是没有条件时两个都是男孩的概率,忘了缩小样本空间。D:$\tfrac23$ 是“至少一个男孩的条件下,恰有一个男孩”的概率。
课堂小测

$P(A)=0.5,\ P(B)=0.4,\ P(A\mid B)=0.5$,则 $P(B\mid A)=$

查看答案与解析

答案B

解析

$P(AB)=P(B)P(A\mid B)=0.2$,$P(B\mid A)=\dfrac{P(AB)}{P(A)}=\dfrac{0.2}{0.5}=0.4$。也可看出 $P(A\mid B)=P(A)$,$A$、$B$ 独立,所以 $P(B\mid A)=P(B)$。

辨析
  • A:把 $P(B\mid A)$ 和 $P(A\mid B)$ 当成一样了,条件概率一般不对称。C:$0.2$ 是 $P(AB)$,还要除以 $P(A)$。D:除反了,$P(B\mid A)$ 的分母是 $P(A)$。
课堂小测

下列说法正确的是

查看答案与解析

答案A

解析

$P(A\mid B)+P(\bar A\mid B)=\dfrac{P(AB)+P(\bar AB)}{P(B)}=1$。

辨析
  • B:反例:两个男孩问题中 $P(A\mid B)=\tfrac13$,$P(A\mid\bar B)=0$,条件不同的两个概率之和没有固定值。C:只在 $B\subseteq A$ 或 $B$ 为必然事件等特殊情形成立,一般 $P(A\mid B)$ 可大于、也可小于 $P(A)$。D:互斥(且概率为正)则 $P(A\mid B)=0\ne P(A)$,一定不独立。
专题 02

全概率与贝叶斯:顺着因果算结果,逆着结果找原因

全概率公式:分情况,再加权求和。贝叶斯公式:已经看到结果,回头问“是哪一种情况造成的”。两者是同一棵树的正向与逆向读法。

粒子流:全概率

三台机床生产同一种零件,零件混在一起,任取一件

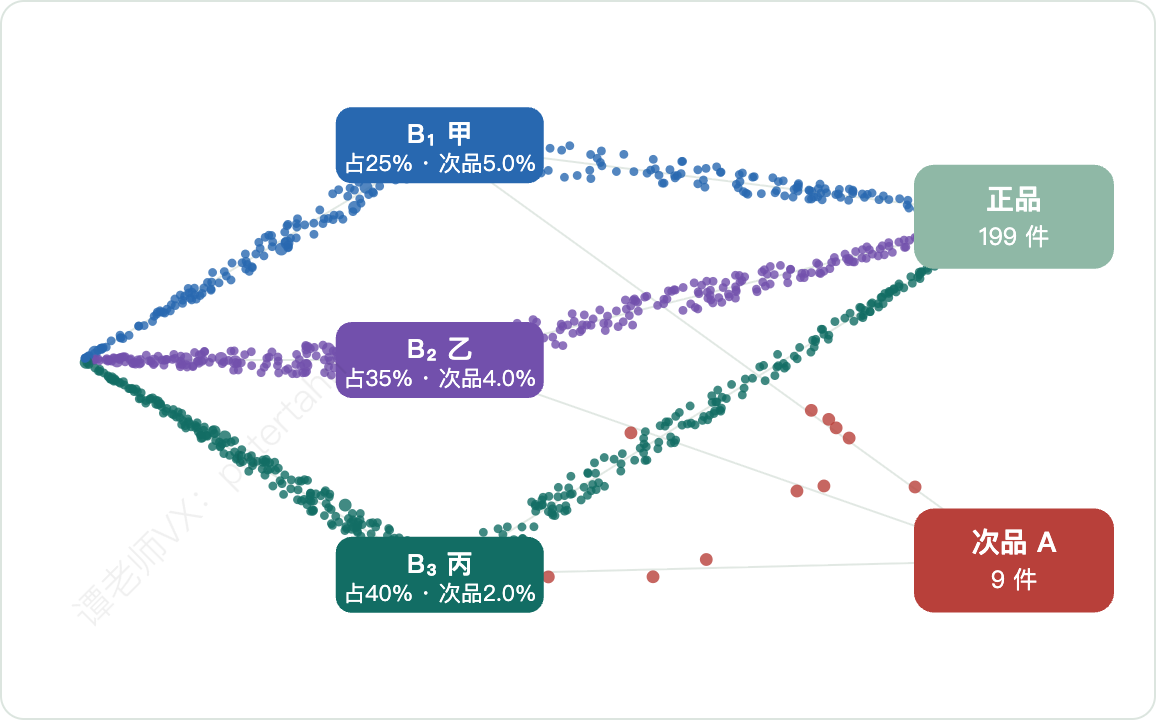
三台机床生产的零件混在一起:左侧一点出发,蓝、紫、绿三股粒子流分别经过甲(B_1)、乙(B_2)、丙(B_3)三台机床,各机床框内标出产量占比与次品率;粒子最终汇入右侧的“正品”(浅绿)或“次品 A”(红色)。红色粒子即各机床产出的次品。
图 1三台机床生产的零件混在一起:左侧一点出发,蓝、紫、绿三股粒子流分别经过甲($B_1$)、乙($B_2$)、丙($B_3$)三台机床,各机床框内标出产量占比与次品率;粒子最终汇入右侧的“正品”(浅绿)或“次品 $A$”(红色)。红色粒子即各机床产出的次品。

设 $B_i$ 为“零件来自第 $i$ 台机床”,$A$ 为“取到次品”,参数如下:

机床 产量占比 $P(B_i)$ 次品率 $P(A\mid B_i)$
$B_1$ 甲 0.25 0.050
$B_2$ 乙 0.35 0.040
$B_3$ 丙 0.40 0.020

三者占比之和为 $1$。于是

$$ \begin{aligned} P(A)&=\sum_i P(B_i)P(A\mid B_i)\\ &=0.25\times0.050+0.35\times0.040+0.40\times0.020\\ &=0.0345 \end{aligned} $$

结构

一个“原因”层(哪台机床,构成 $\Omega$ 的一个划分)+ 一个“结果”层(是否次品)。

$P(A)$ = 各条通往 $A$ 的路径概率之和 = 各原因的加权平均,权重是 $P(B_i)$。

推导:两条公式

全概率公式

  1. 划分:$B_1,\dots,B_n$ 两两互斥,$B_1\cup\cdots\cup B_n=\Omega$,且 $P(B_i)>0$。

    “原因”必须不重不漏——这是用公式前要检查的第一件事

  2. 任一事件 $A$ 被划分切成互不相交的碎片: $$A=A\Omega=AB_1\cup AB_2\cup\cdots\cup AB_n$$

    分配律;各碎片 $AB_i$ 两两互斥

  3. 由有限可加性: $$P(A)=\sum_{i=1}^n P(AB_i)$$
  4. 每一项用乘法公式展开: $$\boxed{P(A)=\sum_{i=1}^n P(B_i)\,P(A\mid B_i)}$$

    树状图:每条通往 $A$ 的路径连乘,再把路径相加

  5. 加权平均的读法:$\sum P(B_i)=1$,所以 $P(A)$ 介于 $\min P(A\mid B_i)$ 与 $\max P(A\mid B_i)$ 之间。

    可用来快速检查答案是否离谱

  6. 最常用的二分划分 $\{B,\bar B\}$: $$ \begin{aligned} P(A)=\ &P(B)P(A\mid B)\\ +\ &P(\bar B)P(A\mid \bar B) \end{aligned} $$

贝叶斯公式

  1. 已知结果 $A$ 发生,问原因 $B_k$ 的概率,按定义: $$P(B_k\mid A)=\frac{P(AB_k)}{P(A)}$$
  2. 分子用乘法公式“顺着树”写:$P(AB_k)=P(B_k)P(A\mid B_k)$

    把难求的“逆向”换成题目给出的“正向”

  3. 分母用全概率公式: $$\boxed{P(B_k\mid A)=\frac{P(B_k)P(A\mid B_k)}{\sum_{i}P(B_i)P(A\mid B_i)}}$$
  4. 一句话:$P(B_k\mid A)$ = 第 $k$ 条通往 $A$ 的路径 ÷ 所有通往 $A$ 的路径之和。

    做题时不用背公式,画树、圈路径、做除法

  5. 术语:$P(B_k)$ 称先验,$P(A\mid B_k)$ 称似然,$P(B_k\mid A)$ 称后验。比例形式: $$\text{后验}\ \propto\ \text{先验}\times\text{似然}$$

    分母只是归一化常数,对所有 $k$ 相同

  6. 比值形式(大学视角,便于连续更新): $$ \underbrace{\frac{P(B\mid A)}{P(\bar B\mid A)}}_{\text{后验几率}} =\underbrace{\frac{P(B)}{P(\bar B)}}_{\text{先验几率}} \times\underbrace{\frac{P(A\mid B)}{P(A\mid\bar B)}}_{\text{似然比}} $$

    多次独立检测:每次都乘一个似然比

翻转树:贝叶斯

同一组数据,两种画法

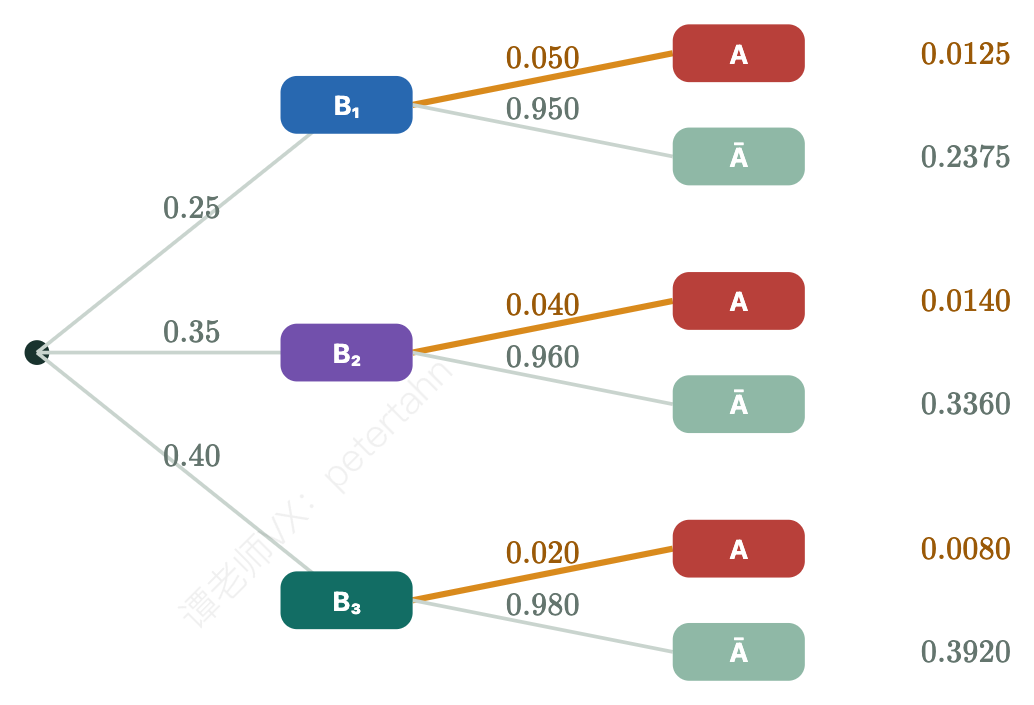
正向树(原因 → 结果):第一层分支是先验 P(B_i)(0.25、0.35、0.40),第二层分支是似然 P(A\mid B_i)(0.050、0.040、0.020 等),右侧数字是叶子的联合概率 P(B_iA)。橙色分支都通往 A,其联合概率 0.0125,\,0.0140,\,0.0080 相加即 P(A)=0.0345。
图 2正向树(原因 → 结果):第一层分支是先验 $P(B_i)$(0.25、0.35、0.40),第二层分支是似然 $P(A\mid B_i)$(0.050、0.040、0.020 等),右侧数字是叶子的联合概率 $P(B_iA)$。橙色分支都通往 $A$,其联合概率 $0.0125,\,0.0140,\,0.0080$ 相加即 $P(A)=0.0345$。
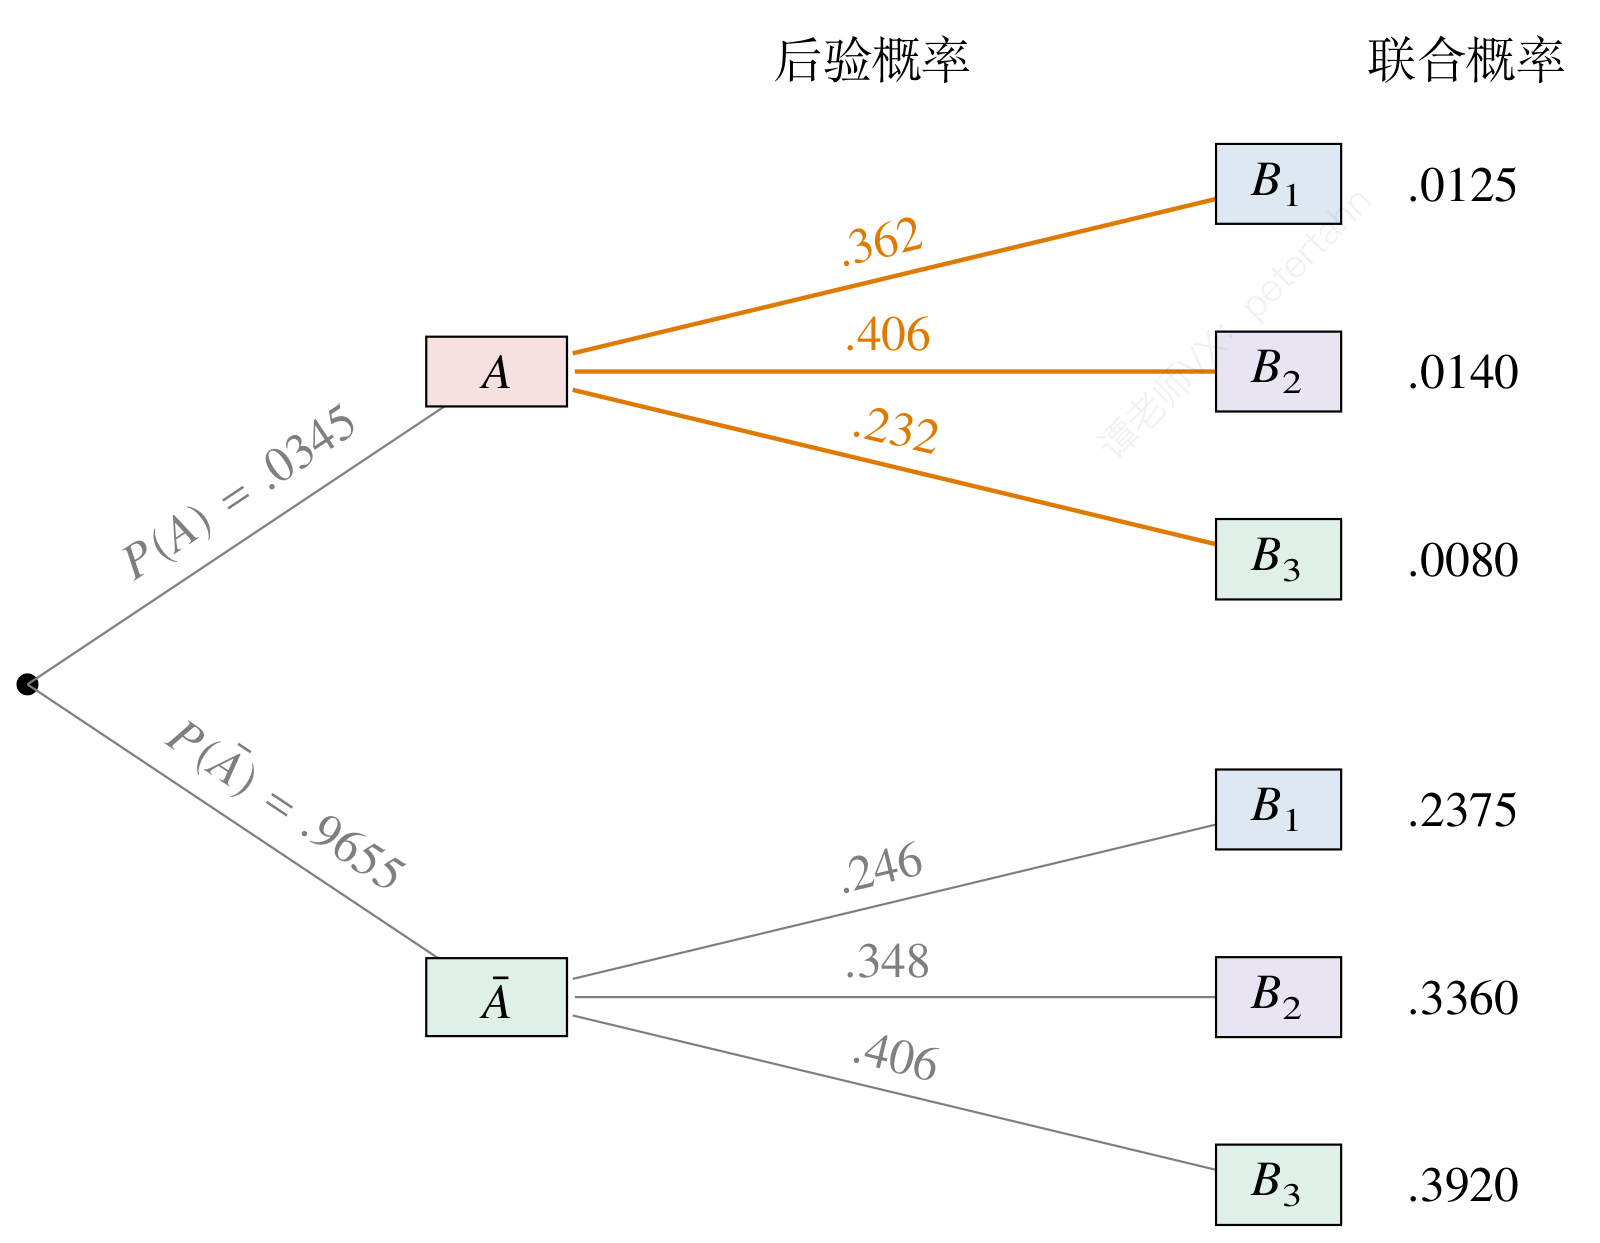
逆向树(结果 \to 原因):分支标后验概率,右侧标联合概率;A 下三个橙色分支分别约为 0.362,0.406,0.232。
图 3逆向树(结果 $\to$ 原因):分支标后验概率,右侧标联合概率;$A$ 下三个橙色分支分别约为 $0.362,0.406,0.232$。

翻转时发生了什么

正向树:第一层是先验 $P(B_i)$,第二层是似然 $P(A\mid B_i)$,叶子是联合概率 $P(B_iA)$。橙色路径都通往 $A$,相加即全概率 $P(A)=0.0345$。

逆向树(结果 → 原因):第一层先问“是否次品”,第二层分支就是后验概率:

$$P(B_i\mid A)=\frac{P(B_i)P(A\mid B_i)}{P(A)}$$

$$ \begin{aligned} P(B_1\mid A)&=\frac{0.0125}{0.0345}=0.3623\\ P(B_2\mid A)&=\frac{0.0140}{0.0345}=0.4058\\ P(B_3\mid A)&=\frac{0.0080}{0.0345}=0.2319 \end{aligned} $$

提示

对比先验与后验:甲 $0.25\to\mathbf{0.362}$,乙 $0.35\to\mathbf{0.406}$,丙 $0.40\to\mathbf{0.232}$。次品率高的机床,“嫌疑”上升。

注意

题目通常给出正向树的分支概率(先验、似然)。贝叶斯就是把它改画成逆向树:叶子上的联合概率不变,只是重新分组。

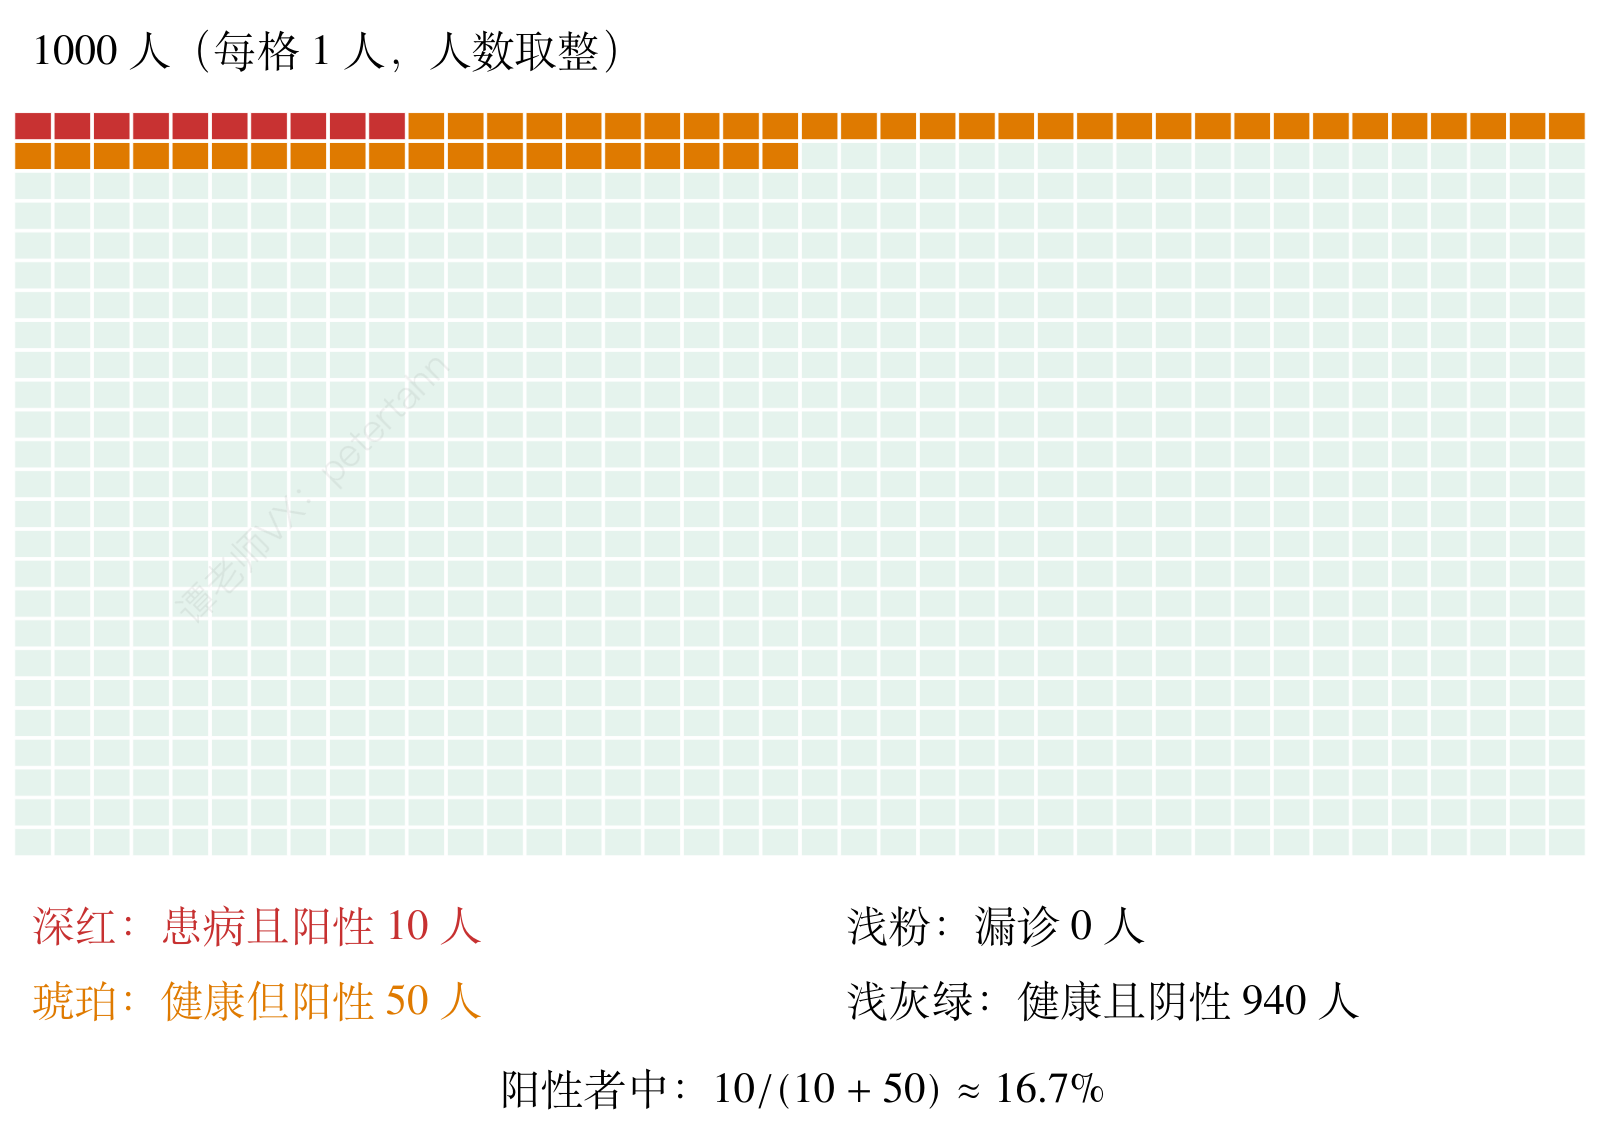
1000 人:检测悖论

检测为阳性,真的患病吗?

1000 人检测方格图,每格 1 人;人数取整后,10 人真阳性、50 人误诊、0 人漏诊、940 人真阴性,阳性者中约 10/60 患病。
图 41000 人检测方格图,每格 1 人;人数取整后,10 人真阳性、50 人误诊、0 人漏诊、940 人真阴性,阳性者中约 $10/60$ 患病。

设患病率 $0.01$,检测灵敏度 $P(\text{阳}\mid\text{病})=0.99$,误诊率 $P(\text{阳}\mid\text{健康})=0.05$。把 1000 人看成 1000 个小方格(每格 1 人),分为三类:患病且阳性(真阳性)、患病但阴性(漏诊)、健康但阳性(误诊)。

计算

$$ \begin{aligned} P(\text{病}\mid\text{阳})&=\frac{P(\text{病})P(\text{阳}\mid\text{病})}{P(\text{阳})}\\ &=\frac{0.01\times0.99}{0.01\times0.99+0.990\times0.05}\\ &\approx0.1667\\[4pt] &\text{人数直观:}\ \frac{10}{10+50}\ \text{(真阳性 ÷ 全部阳性)} \end{aligned} $$

  • $P(\text{患病}\mid\text{阳性})$:约 $16.7\%$
  • 复查再阳性后:约 $79.8\%$(似然比 $19.8$)
基础比率谬误

直觉把 $P(\text{阳}\mid\text{病})=99\%$ 当成 $P(\text{病}\mid\text{阳})$。疾病越罕见,健康人基数越大,误诊的人数就越多,可以压过真阳性。

复查

第一次阳性后的后验,成为第二次检测的先验(假设两次检测条件独立)。这就是“比值形式”中再乘一次似然比。

三门问题

三门问题:选一扇门,主持人打开一扇羊门,换不换?

三扇门 1、2、3,其中一扇后面是车,另两扇后面是羊。你先选定一扇门,主持人(知道车在哪)打开另一扇有羊的门,问你是否换成剩下的那扇门。

贝叶斯分析

  1. 设你选 1 号门,$C_i$:车在 $i$ 号门,先验 $P(C_i)=\tfrac13$。$H_3$:主持人开 3 号门。

  2. 似然(主持人知道车在哪,且只开羊门;有两扇可开时随机选): $$P(H_3\mid C_1)=\tfrac12,\ \ P(H_3\mid C_2)=1,\ \ P(H_3\mid C_3)=0$$

    关键:主持人的行为依赖于车的位置,所以带来了信息

  3. 全概率:$P(H_3)=\tfrac13\cdot\tfrac12+\tfrac13\cdot1+\tfrac13\cdot0=\tfrac12$

  4. 贝叶斯: $$ \begin{aligned} P(C_1\mid H_3)&=\frac{\frac13\cdot\frac12}{\frac12}=\frac13\\ P(C_2\mid H_3)&=\frac{\frac13\cdot 1}{\frac12}=\frac23 \end{aligned} $$

  5. 结论:换门胜率 $\tfrac23$。

    变式:若主持人不知道车在哪、随机开门恰好是羊,则 $P(H_3\mid C_2)=\tfrac12$,此时两门各 $\tfrac12$——同样的“看到”,不同的“生成机制”,答案不同。

    贝叶斯的核心:似然由“结果是怎么产生的”决定

例题精讲

例 12022 全国新高考 I 卷

病例组 100 例、对照组 100 人的卫生习惯调查如下表。

(1)能否有 99% 的把握认为两组卫生习惯有差异?

(2)任选一人,$A$:卫生习惯不够良好,$B$:患该疾病。记 $R=\dfrac{P(B\mid A)}{P(\bar B\mid A)}\Big/\dfrac{P(B\mid\bar A)}{P(\bar B\mid\bar A)}$。

(i) 证明 $R=\dfrac{P(A\mid B)}{P(\bar A\mid B)}\cdot\dfrac{P(\bar A\mid\bar B)}{P(A\mid\bar B)}$;(ii) 估计 $P(A\mid B)$、$P(A\mid\bar B)$ 与 $R$。

原题数据:病例组中卫生习惯“不够良好”40 人、“良好”60 人;对照组中“不够良好”10 人、“良好”90 人。
图 5原题数据:病例组中卫生习惯“不够良好”40 人、“良好”60 人;对照组中“不够良好”10 人、“良好”90 人。
建模思路

调查是“按病分组”抽样的:能估计的是 $P(A\mid B)$(病例组里习惯差的比例),不能直接估计 $P(B\mid A)$。(i) 的恒等式正是把“想要的” $R$ 换成“能估计的”量——这是贝叶斯思想的典型应用。

解析

(1)独立性检验

  1. $a=40,\ b=60,\ c=10,\ d=90,\ n=200$。
  2. $$K^2=\frac{200(40\times90-60\times10)^2}{100\times100\times50\times150}=\frac{200\times3000^2}{7.5\times10^7}=24$$
  3. $24>6.635$,所以有 99% 的把握认为两组卫生习惯有差异。

    “有差异”= 拒绝“无关”的原假设

答案:有 99% 的把握认为有差异。

(2)(i) 证明恒等式

  1. 同一条件下的比值,分母 $P(A)$ 约掉: $$\frac{P(B\mid A)}{P(\bar B\mid A)}=\frac{P(AB)/P(A)}{P(A\bar B)/P(A)}=\frac{P(AB)}{P(A\bar B)}$$

    核心技巧:同条件的两个条件概率之比 = 交事件概率之比

  2. 同理 $\dfrac{P(B\mid\bar A)}{P(\bar B\mid\bar A)}=\dfrac{P(\bar AB)}{P(\bar A\bar B)}$,所以 $$R=\frac{P(AB)\,P(\bar A\bar B)}{P(A\bar B)\,P(\bar AB)}$$

    这个对称形式就是“交叉乘积比”,即统计中的优势比 OR

  3. 重新分组,按条件 $B$、$\bar B$ 引入分母: $$ \begin{aligned} R&=\frac{P(AB)/P(B)}{P(\bar AB)/P(B)}\cdot\frac{P(\bar A\bar B)/P(\bar B)}{P(A\bar B)/P(\bar B)}\\ &=\frac{P(A\mid B)}{P(\bar A\mid B)}\cdot\frac{P(\bar A\mid\bar B)}{P(A\mid\bar B)} \end{aligned} $$

答案:证毕。

(2)(ii) 估计 $R$

  1. 病例组中习惯不够良好的频率估计 $P(A\mid B)=\dfrac{40}{100}=0.4$;对照组中估计 $P(A\mid\bar B)=\dfrac{10}{100}=0.1$。
  2. 补集:$P(\bar A\mid B)=0.6$,$P(\bar A\mid\bar B)=0.9$。
  3. $$R=\frac{0.4}{0.6}\times\frac{0.9}{0.1}=6$$ 也等于交叉乘积比 $\dfrac{ad}{bc}=\dfrac{40\times90}{60\times10}=6$。

    $R$ 与列联表的 $ad/bc$ 一致,可作检验

答案:$P(A\mid B)=0.4,\ P(A\mid\bar B)=0.1,\ R=6$。

易错

易错点:用 $\dfrac{40}{50}$ 去估计 $P(B\mid A)$——这里病例组、对照组人数是人为定的各 100 人,表中纵向比例不能代表人群患病率。

例 22023 深圳一模

袋中 1 黑 2 白,每名员工有放回摸两次。两次颜色不同按方式 I 回答(第一次白画“○”,否则画“×”);否则按方式 II 回答(满意画“○”,否则画“×”)。

(1)某部门 9 人,$X$ 为按方式 I 回答的人数,求 $E(X)$;(2)所有问卷中“○”与“×”之比为 $4:5$,估计满意度。

建模思路

调查者看不到每个人走的是哪条分支,只看到“○”的总比例。全概率公式把总比例拆成两条路径,其中一条含未知数 $p$——正向用全概率,反向解方程。

解析

(1)$E(X)$

  1. 单人方式 I(两次颜色不同):$P=\tfrac23\cdot\tfrac13+\tfrac13\cdot\tfrac23=\tfrac49$。
  2. 9 人相互独立,$X\sim B\left(9,\tfrac49\right)$,$E(X)=9\times\tfrac49=4$。

答案:$4$。

(2)满意度

  1. 设 $A$:方式 I,$\bar A$:方式 II,$C$:画“○”,满意度为 $p=P(C\mid\bar A)$。$P(A)=\tfrac49$,$P(\bar A)=\tfrac59$。
  2. 方式 I 下画“○”= 摸到(白,黑):$P(AC)=\tfrac23\times\tfrac13=\tfrac29$,即 $P(C\mid A)=\tfrac12$。

    不是“$\tfrac12$ 凭感觉”:$AC$ 的实质是摸球结果为(白,黑)

  3. 全概率: $$P(C)=P(A)P(C\mid A)+P(\bar A)P(C\mid\bar A)=\tfrac29+\tfrac59p$$
  4. 频率估计 $P(C)=\tfrac{4}{4+5}=\tfrac49$,解 $\tfrac49=\tfrac29+\tfrac59p$ 得 $p=\tfrac25=40\%$。

答案:$40\%$。

易错

易错点:把“○”占 $\tfrac49$ 直接当成满意度;忘了方式 I 中也有人画“○”。

例 32024 湖南十八校联盟三月

(节选第 1 问)两个粒子经第一道逻辑门后等可能地变为上旋或下旋;再经第二道门,每个粒子的自旋状态以概率 $p$ 发生改变,粒子间相互独立。若第二道门后上旋粒子个数为 2,且 $p=\tfrac13$,求第一道门后上旋个数也为 2 的概率。

建模思路

两层的树:第一层是“原因”(第一道门后的状态 $A_0,A_1,A_2$),第二层是“结果” $B$。已知结果问原因——标准贝叶斯。

解析
  1. $A_i$:第一道门后上旋 $i$ 个,$X_1\sim B(2,\tfrac12)$:$P(A_0)=\tfrac14,\ P(A_1)=\tfrac12,\ P(A_2)=\tfrac14$。

  2. $B$:第二道门后两个都上旋。似然:$P(B\mid A_0)=p^2=\tfrac19$(两个都改变),$P(B\mid A_1)=(1-p)p=\tfrac29$(上旋保持、下旋改变),$P(B\mid A_2)=(1-p)^2=\tfrac49$。

    每个粒子的“改变 / 保持”分开看,再按独立相乘

  3. 全概率:$P(B)=\tfrac14\cdot\tfrac19+\tfrac12\cdot\tfrac29+\tfrac14\cdot\tfrac49=\tfrac{1+4+4}{36}=\tfrac14$。

    三条通往 B 的路径:A_0(下下)、A_1(一上一下)、A_2(上上)三个状态分别以概率 \tfrac14,\tfrac12,\tfrac14 出现,再以 p^2,\ (1-p)p,\ (1-p)^2 到达 B,路径概率 \tfrac1{36},\tfrac4{36},\tfrac4{36} 相加得 P(B)=\tfrac14;橙色路径(A_2\to B)占其中 \tfrac49。
    图 6三条通往 $B$ 的路径:$A_0$(下下)、$A_1$(一上一下)、$A_2$(上上)三个状态分别以概率 $\tfrac14,\tfrac12,\tfrac14$ 出现,再以 $p^2,\ (1-p)p,\ (1-p)^2$ 到达 $B$,路径概率 $\tfrac1{36},\tfrac4{36},\tfrac4{36}$ 相加得 $P(B)=\tfrac14$;橙色路径($A_2\to B$)占其中 $\tfrac49$。
  4. 贝叶斯: $$P(A_2\mid B)=\frac{P(A_2)P(B\mid A_2)}{P(B)}=\frac{4/36}{9/36}=\frac49$$

答案:$\dfrac49$。

易错

易错点:以为“改变概率 $p$”只针对下旋→上旋;题意是两个方向都以 $p$ 改变。

例 42024 福建适应性练习

甲发球时甲得分概率 $\tfrac23$,乙发球时甲得分概率 $\tfrac12$,各球独立。第一局打到 10:10,此后每球交换发球权,领先 2 分者胜。

(1)再打两个球,甲新增得分 $X$ 的分布列与均值;(2)求第一局甲获胜的概率 $p_0$。

建模思路

两个球中恰好甲、乙各发一球(顺序不影响乘积)。11:11 与 10:10 处境完全相同——对“下一步的结果”用全概率公式,得到关于 $p_0$ 自身的方程。这是马尔可夫链 / 概率递推的入门。

解析

(1)$X$ 的分布列

  1. 两球中甲发一球、乙发一球。$P(X=2)=\tfrac23\cdot\tfrac12=\tfrac13$,$P(X=0)=\tfrac13\cdot\tfrac12=\tfrac16$,$P(X=1)=1-\tfrac13-\tfrac16=\tfrac12$。

    也可按“谁先发”再用一次全概率,两种情况结果相同

  2. $E(X)=0\cdot\tfrac16+1\cdot\tfrac12+2\cdot\tfrac13=\tfrac76$。

答案:$E(X)=\tfrac76$。

(2)第一局甲获胜的概率 $p_0$

  1. 以“再打两球的结果”为划分:$X=2$ 甲胜;$X=0$ 甲负;$X=1$ 回到平局(11:11),胜率仍为 $p_0$。
  2. 全概率: $$p_0=\tfrac13\cdot1+\tfrac12\cdot p_0+\tfrac16\cdot0$$

    条件概率 $P(\text{甲胜}\mid X=1)$ 恰好是 $p_0$ 本身——“自相似”

  3. 解得 $p_0=\tfrac23$。

答案:$p_0=\tfrac23$。

另一种做法

把无限多球的情形逐一相加也可行:等比级数 $\sum\left(\tfrac12\right)^k\cdot\tfrac13=\tfrac23$,但列方程更快。

例 52024 湖北 12 月联考

$n$ 颗大小互不相同的麦穗依次出现,只能摘一次、不能回头。策略:跳过前 $k$ 颗,从第 $k+1$ 颗起,遇到比之前都大的就摘,否则摘最后一颗。设 $k=tn$,摘到最大麦穗的概率为 $P$(可用 $\dfrac kn\sum_{j=k}^{n-1}\dfrac1j\approx\dfrac kn\ln\dfrac nk$)。

(1)$n=4,k=2$,求 $P$;(2)$n\to\infty$,求 $P$ 的最大值及此时的 $t$。

建模思路

(1) 样本空间是 4 颗麦穗的全排列,用古典概型数。(2) 按最大麦穗所在位置 $j$ 用全概率公式,关键条件概率:第 $j$ 颗被摘 $\iff$ 前 $j-1$ 颗中的最大者落在前 $k$ 颗里。

解析

(1)$n=4,\ k=2$

  1. $n(\Omega)=\mathrm{A}_4^4=24$。要摘到最大的,它必须在第 3 或第 4 位。
  2. 最大在第 3 位:一定比前 2 颗都大,会被摘下。其余 3 颗任意排,$3!=6$ 种。
  3. 最大在第 4 位:需要第 3 颗不被摘,即前 3 颗中的最大者(第二大)在前 2 位。第二大的位置 2 种 × 其余 2 颗排列 2 种 $=4$ 种。

    若第 3 颗是前 3 颗中最大的,就会被摘走,轮不到第 4 颗

  4. $P=\dfrac{6+4}{24}=\dfrac5{12}$。

    枚举全部 24 种排列验证一致

答案:$\dfrac5{12}$。

(2)$n\to\infty$ 时的最大值

  1. $B_j$:最大麦穗在第 $j$ 位,$P(B_j)=\tfrac1n$。$A$:摘到最大的。
  2. $j\le k$:被跳过,$P(A\mid B_j)=0$。$j\ge k+1$:$P(A\mid B_j)=\dfrac{k}{j-1}$。

    前 $j-1$ 颗中的“临时冠军”在 $j-1$ 个位置上等可能,落在前 $k$ 个的概率为 $\dfrac{k}{j-1}$

  3. 全概率: $$P=\sum_{j=k+1}^n\frac1n\cdot\frac k{j-1}=\frac kn\sum_{j=k}^{n-1}\frac1j\approx\frac kn\ln\frac nk=-t\ln t$$
  4. $f(t)=-t\ln t$,$f'(t)=-\ln t-1$,$t<\tfrac1e$ 时递增,$t>\tfrac1e$ 时递减。
  5. $t=\tfrac1e$ 时取最大值 $f\!\left(\tfrac1e\right)=\tfrac1e\approx0.368$。

    “37% 法则”:先观察约 37%,再选第一个比之前都好的

答案:$P_{\max}=\dfrac1e$,此时 $t=\dfrac1e$。

易错

易错点:最大在第 4 位时,误以为一定能摘到;忽略了第 3 颗可能先被摘走。

课堂小测

课堂小测

甲、乙两厂产品分别占 60%、40%,次品率分别为 2%、5%。任取一件是次品,它来自乙厂的概率?

查看答案与解析

答案D

解析

$\dfrac{0.4\times0.05}{0.6\times0.02+0.4\times0.05}=\dfrac{0.020}{0.032}=\dfrac58$。

辨析
  • A:$0.4$ 是先验 $P(\text{乙})$,没有用到“是次品”这个信息
  • B:$0.05$ 是 $P(\text{次}\mid\text{乙})$,方向反了
  • C:$0.032$ 是全概率 $P(\text{次})$,只算了分母。
课堂小测

用全概率公式前,必须检查的是

查看答案与解析

答案B

解析

划分要“不重”(两两互斥)、“不漏”(并为 $\Omega$)。

辨析
  • A:$A$ 与 $B_i$ 不必独立;若独立,$P(A\mid B_i)$ 都相等,全概率公式就没意义了
  • C:各 $P(A\mid B_i)$ 之和没有要求,一般不等于 1
  • D:不需要等可能。
专题 03

独立与互斥:一个说“互不影响”,一个说“不能同时”

互斥看的是集合(有没有交集),独立看的是概率(知道一个会不会改变另一个)。两者几乎是反义词。

看见:面积模型里的独立

单位正方形:$A$ 是竖条,$B$ 是横条

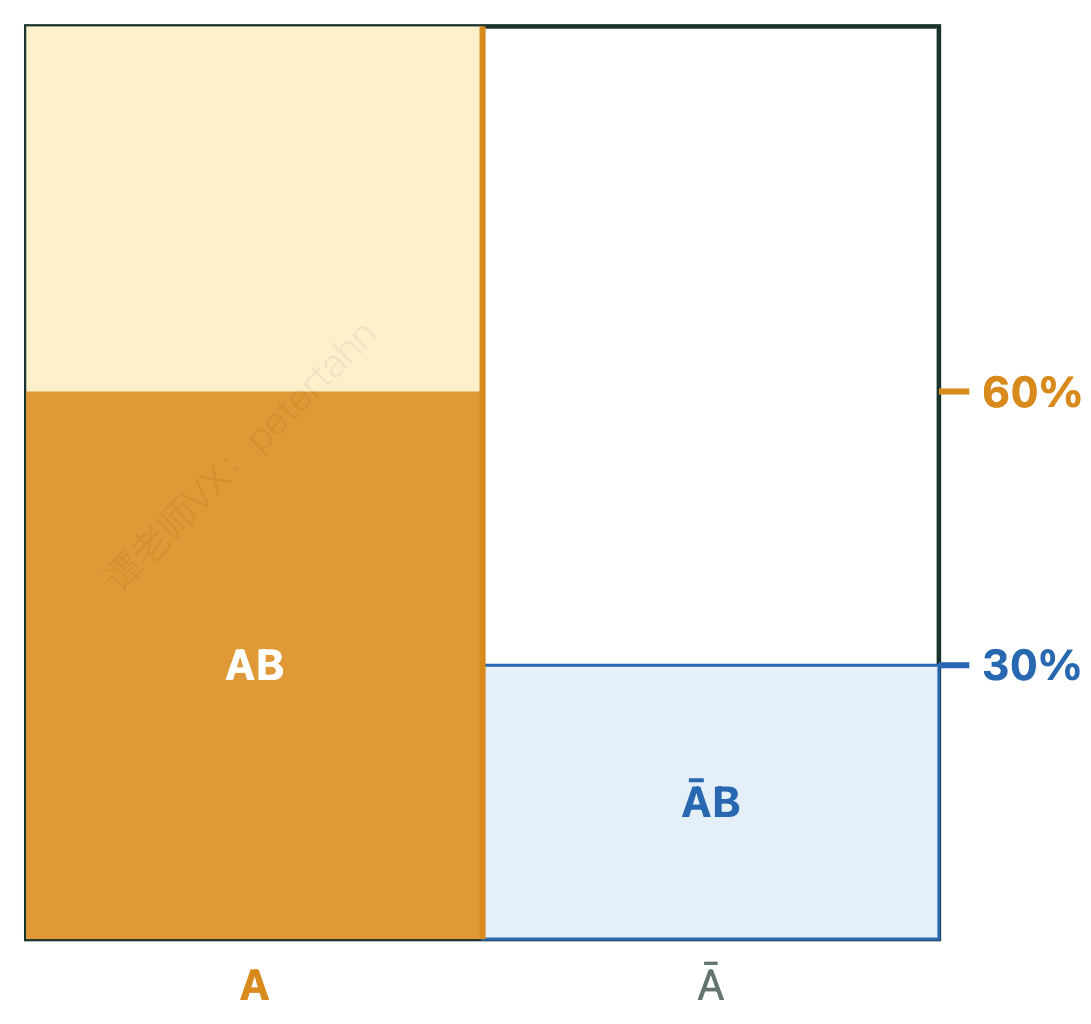
$A$ 占宽度 $P(A)$。$B$ 在 $A$ 内的高度是 $P(B\mid A)$,在 $A$ 外的高度是 $P(B\mid\bar A)$。两段高度一样时,$B$ 变成一整条横带。

单位正方形的面积模型,取 P(A)=0.5,P(B\mid A)=0.6,P(B\mid\bar A)=0.3。左半(宽 P(A))是 A 的竖条,右半是 \bar A;深橙色块 AB 的高度为 60\%,蓝色块 \bar AB 的高度为 30\%,右侧刻度标出这两段高度。两段高度不同,B 不是一整条横带,所以此时 A、B 不独立。
图 1单位正方形的面积模型,取 $P(A)=0.5$,$P(B\mid A)=0.6$,$P(B\mid\bar A)=0.3$。左半(宽 $P(A)$)是 $A$ 的竖条,右半是 $\bar A$;深橙色块 $AB$ 的高度为 $60\%$,蓝色块 $\bar AB$ 的高度为 $30\%$,右侧刻度标出这两段高度。两段高度不同,$B$ 不是一整条横带,所以此时 $A$、$B$ 不独立。

读数

对上图的取值($P(A)=0.50$,$P(B\mid A)=0.60$,$P(B\mid\bar A)=0.30$):

$$ \begin{aligned} P(B)&=0.50\times0.60+0.50\times0.30=0.4500\\ P(AB)&=0.3000\\ P(A)P(B)&=0.50\times0.4500=0.2250 \end{aligned} $$

$P(AB)>P(A)P(B)$:不独立($A$ 发生使 $B$ 更可能)。

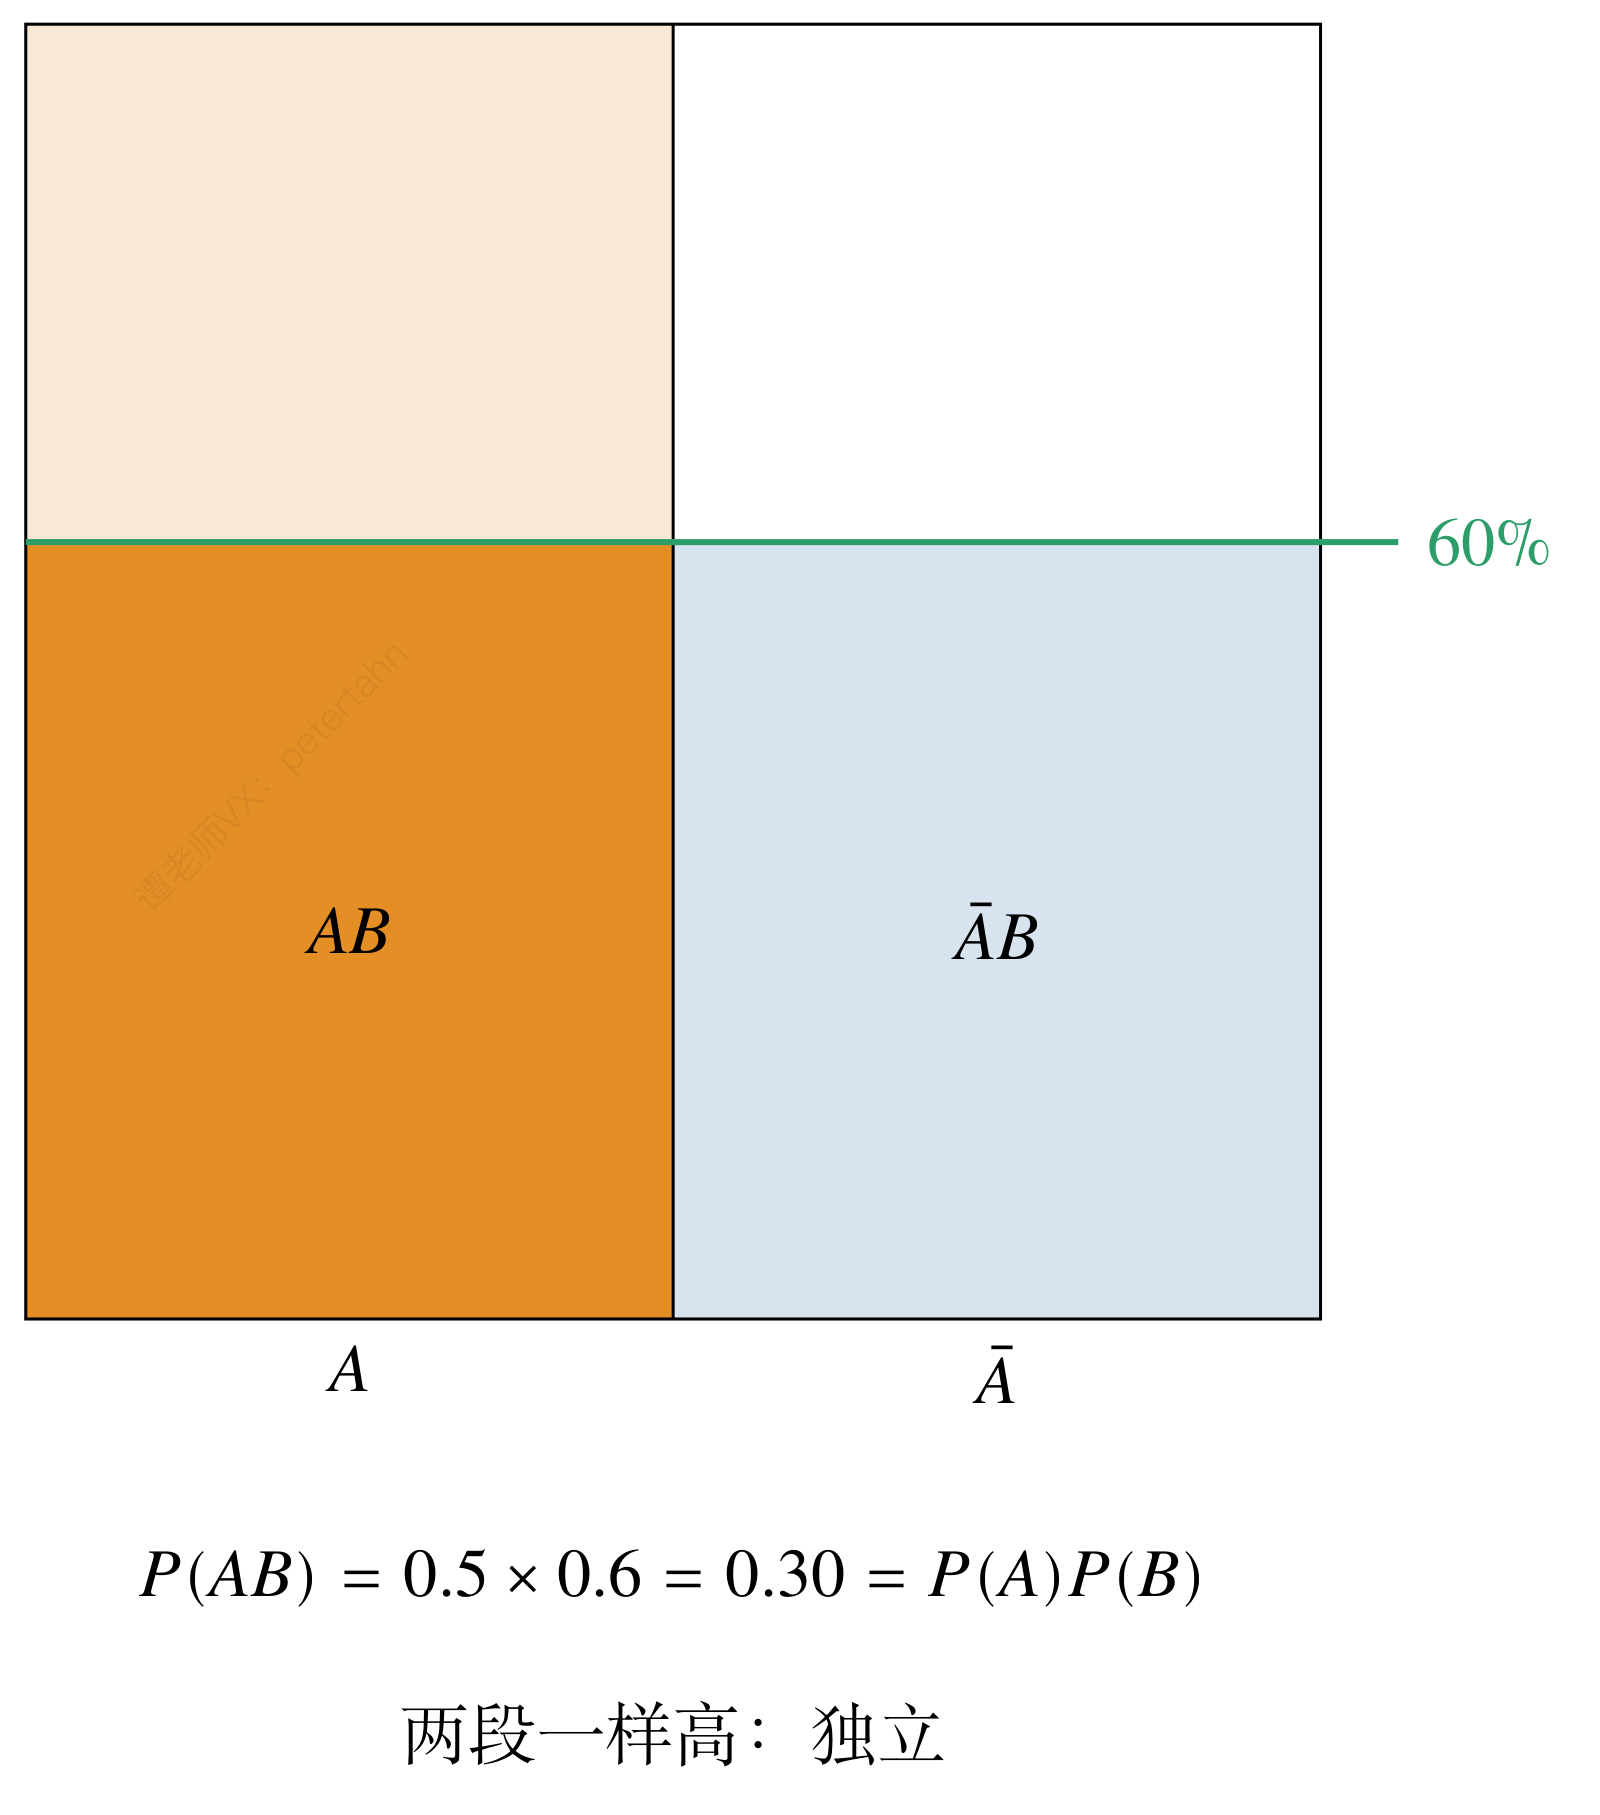
独立状态:P(A)=0.5,B 在 A 与 \bar A 内的高度均为 60\%;P(AB)=0.30=P(A)P(B)。
图 2独立状态:$P(A)=0.5$,$B$ 在 $A$ 与 $\bar A$ 内的高度均为 $60\%$;$P(AB)=0.30=P(A)P(B)$。
思路

独立的几何含义:$B$ 是一整条水平的带子,与 $A$ 的竖条垂直相交,交集面积 = 宽 × 高 = $P(A)\cdot P(B)$。“一样高”说明 $B$ 发生的可能性不受 $A$ 是否发生的影响。

注意

只有一种情况能让独立的 $A$、$B$ 互斥:其中一个概率为 $0$。在面积图上,交集是“宽 × 高”的一个矩形,只要宽、高都不为 $0$,它就不可能为空。

推导:定义与性质

从“互不影响”推到乘法定义

  1. 直观要求:知道 $B$ 发生,$A$ 的概率不变: $$P(A\mid B)=P(A)\quad(P(B)>0)$$

    上一模块:条件概率衡量“知道 $B$”对 $A$ 的影响

  2. 代入条件概率定义 $P(A\mid B)=\dfrac{P(AB)}{P(B)}$: $$\frac{P(AB)}{P(B)}=P(A)\ \Rightarrow\ P(AB)=P(A)P(B)$$

  3. 定义:若 $$P(AB)=P(A)P(B)$$ 则称 $A$、$B$ 相互独立。

    用乘法写定义:$A$、$B$ 地位对称,且 $P(B)=0$ 时也有意义

  4. 对称性:当 $P(A)>0$ 时,同样推出 $P(B\mid A)=P(B)$——“$A$ 不影响 $B$”与“$B$ 不影响 $A$”是一回事。

  5. 对立事件也独立:若 $A$、$B$ 独立,则 $A$ 与 $\bar B$ 独立: $$ \begin{aligned} P(A\bar B)&=P(A)-P(AB)=P(A)-P(A)P(B)\\ &=P(A)\,[1-P(B)]=P(A)P(\bar B) \end{aligned} $$

    由 $A=AB\cup A\bar B$(互斥)得 $P(A\bar B)=P(A)-P(AB)$。同理 $\bar A$ 与 $B$、$\bar A$ 与 $\bar B$ 都独立

  6. “至少一个”用对立:$A$、$B$ 独立时 $$P(A\cup B)=1-P(\bar A\,\bar B)=1-P(\bar A)P(\bar B)$$

    比 $P(A)+P(B)-P(A)P(B)$ 更好推广到 $n$ 个事件:$1-\prod(1-p_i)$

  7. 多个事件相互独立:$A_1,\dots,A_n$ 中任意 $k\ (2\le k\le n)$ 个的积都等于概率之积。

    两两独立 $\neq$ 相互独立:只检查两两乘积不够(见“辨析”一节的反例)。

  8. 互斥的加法与独立的乘法对照: $$\text{互斥:}P(A\cup B)=P(A)+P(B)\qquad\text{独立:}P(AB)=P(A)P(B)$$

    “或”用加法要求互斥;“且”用乘法要求独立。题目里两者常同时出现

掷两颗骰子:亲手检验 $P(AB)=P(A)P(B)$

两骰子方格:行是第一颗,列是第二颗;浅黄只在 A(和为 7),浅蓝只在 B(第一颗为 1),橙色为交集 (1,6)。
图 3两骰子方格:行是第一颗,列是第二颗;浅黄只在 $A$(和为 7),浅蓝只在 $B$(第一颗为 1),橙色为交集 $(1,6)$。

在 $6\times6$ 的方格里,行 = 第一颗,列 = 第二颗;每个格子对应一个等可能的结果。把事件 $A$ 取作“点数和为 7”,$B$ 取作“第一颗是 1”:

$$ \begin{aligned} &P(A)=\dfrac{1}{6},\quad P(B)=\dfrac{1}{6}\\ &P(AB)=\dfrac{1}{36},\quad P(A)P(B)=\dfrac{1}{36} \end{aligned} $$

相等:$A$、$B$ 相互独立。

提示

“直觉上无关”的事件不一定独立;“直觉上有关”的事件也可能恰好独立,例如 点数和为 7 与 第一颗是 1。必须用乘法公式验证。

换一对事件再检验

下面两张表把同一套检验换成其他事件组合(每个事件的概率都按 $36$ 个等可能结果数出来)。

表一:$B$ 固定为“第一颗是 1”($P(B)=\frac16$),$A$ 变化。

$A$ $P(A)$ $P(AB)$ $P(A)P(B)$ 结论
第一颗是 1 $\frac16$ $\frac16$ $\frac1{36}$ $A$ 与自身:$P(AA)=P(A)\ne P(A)^2$(除非概率为 $0$ 或 $1$)
第一颗是奇数 $\frac12$ $\frac16$ $\frac1{12}$ 不独立
第二颗是奇数 $\frac12$ $\frac1{12}$ $\frac1{12}$ 独立
点数和为偶数 $\frac12$ $\frac1{12}$ $\frac1{12}$ 独立
点数和为 8 $\frac5{36}$ $0$ $\frac5{216}$ 不独立,且互斥
至少一颗是 6 $\frac{11}{36}$ $\frac1{36}$ $\frac{11}{216}$ 不独立
第一颗 $\ge5$ $\frac13$ $0$ $\frac1{18}$ 不独立,且互斥
点数和为 7 $\frac16$ $\frac1{36}$ $\frac1{36}$ 独立

表二:$A$ 固定为“点数和为 7”($P(A)=\frac16$),$B$ 变化。

$B$ $P(B)$ $P(AB)$ $P(A)P(B)$ 结论
点数和为 7 $\frac16$ $\frac16$ $\frac1{36}$ $B$ 与自身:$P(AA)=P(A)\ne P(A)^2$(除非概率为 $0$ 或 $1$)
第一颗是奇数 $\frac12$ $\frac1{12}$ $\frac1{12}$ 独立
第二颗是奇数 $\frac12$ $\frac1{12}$ $\frac1{12}$ 独立
点数和为偶数 $\frac12$ $0$ $\frac1{12}$ 不独立,且互斥
点数和为 8 $\frac5{36}$ $0$ $\frac5{216}$ 不独立,且互斥
两颗点数相同 $\frac16$ $0$ $\frac1{36}$ 不独立,且互斥
至少一颗是 6 $\frac{11}{36}$ $\frac1{18}$ $\frac{11}{216}$ 不独立
第一颗 $\ge5$ $\frac13$ $\frac1{18}$ $\frac1{18}$ 独立

辨析:互斥 vs 独立

一张表分清两个概念

互斥 相互独立
定义 $AB=\varnothing$(集合关系) $P(AB)=P(A)P(B)$(概率关系)
判断依据 看事件本身,不需要算概率 必须算概率;换一个概率模型结论可能变
图上 两块不重叠 交集面积 = 宽 × 高
公式 $P(A\cup B)=P(A)+P(B)$ $P(AB)=P(A)P(B)$
典型题目信号 “恰有一个”“分类讨论”的各类 “各次相互独立”“互不影响”“有放回”
二者的关系

若 $P(A),P(B)>0$:互斥 $\Rightarrow$ 不独立(因为 $P(AB)=0\neq P(A)P(B)$);独立 $\Rightarrow$ 不互斥。

易错

对立是特殊的互斥(还要求 $A\cup B=\Omega$)。对立 $\Rightarrow$ 互斥,反之不成立。

反例:两两独立,但不相互独立

掷两枚均匀硬币。$A$:第一枚正面;$B$:第二枚正面;$C$:两枚结果相同。

结果 正正 正反 反正 反反
$A$ ✓ ✓
$B$ ✓ ✓
$C$ ✓ ✓
  1. $P(A)=P(B)=P(C)=\tfrac12$。
  2. $P(AB)=P(\{\text{正正}\})=\tfrac14=P(A)P(B)$,同理 $P(AC)=P(BC)=\tfrac14$:两两独立。
  3. 但 $P(ABC)=P(\{\text{正正}\})=\tfrac14\neq\tfrac18=P(A)P(B)P(C)$。

    知道 $A$、$B$ 都发生,$C$ 就一定发生——$A$、$B$ 联合起来完全决定了 $C$

  4. 结论:判断三个事件相互独立,四个等式都要成立:三个两两乘积,加上三者乘积。

应用:串并联电路

电子模块:元件 1、4 串联,中间 2、3 并联(第 18 题)

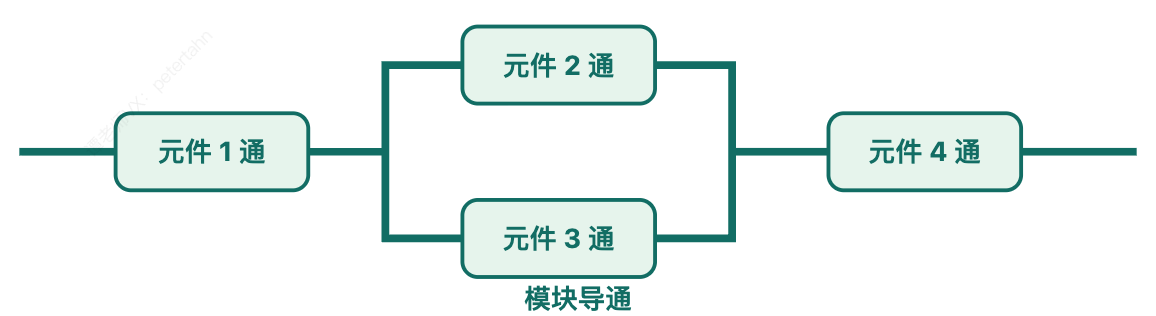
电子模块示意:元件 1 与元件 4 串联在两端,元件 2、3 并联后接在中间;图中各元件均处于“通”的状态,整个模块导通。模块导通的条件是:元件 1 通、元件 4 通,且元件 2、3 至少一个通。
图 4电子模块示意:元件 1 与元件 4 串联在两端,元件 2、3 并联后接在中间;图中各元件均处于“通”的状态,整个模块导通。模块导通的条件是:元件 1 通、元件 4 通,且元件 2、3 至少一个通。

拆解:串联用“且”,并联用“或”

  1. 记 $E_i$:元件 $i$ 导通,$P(E_i)=r$,各元件相互独立。
  2. 模块导通 $=E_1\cap(E_2\cup E_3)\cap E_4$。

    串联:每一段都要通,用交;并联:至少一条通,用并

  3. 并联部分用对立: $$P(E_2\cup E_3)=1-P(\bar E_2)P(\bar E_3)=1-(1-r)^2$$
  4. 三段独立,相乘: $$p=r\cdot[1-(1-r)^2]\cdot r=r^2[1-(1-r)^2]$$
  5. 代入 $r=0.90$: $$p=0.90^2\times[1-0.10^2]=0.8100\times0.9900\approx0.8019$$

    第 18 题:$0.81\times0.99=0.8019$,保留两位有效数字得 $0.80$

例题精讲

例 12024 温州一模

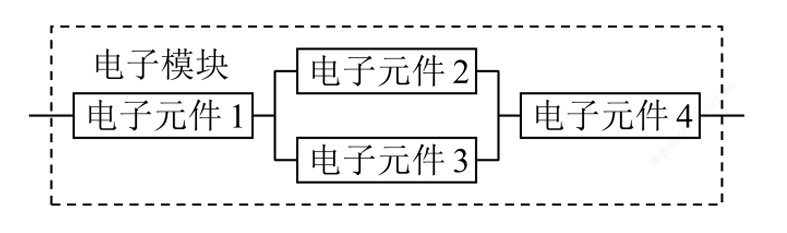
每个电子模块由 4 个电子元件按图示方式连接,每个元件导通的概率均为 $0.9$,各元件独立。

(1)求每个模块导通的概率 $p$(保留两位有效数字);

(2)某器件由 20 个模块构成,模块彼此独立,当且仅当不低于 $50\%$ 的模块导通时器件正常工作。再添加 2 个相同模块,新器件正常工作的概率是增大还是减小?

原题电路图:元件 1 与元件 4 串联,元件 2、3 并联后接在中间。
图 5原题电路图:元件 1 与元件 4 串联,元件 2、3 并联后接在中间。
建模思路

(1) 串联 = 交,并联 = 并,各元件独立 $\to$ 乘法。(2) 不要直接算 22 项求和:以“原来 20 个模块中导通的个数 $X$”为基准,新增 2 个只在 $X=9,10$ 两种临界情形改变结果。

解析

(1)模块导通的概率

  1. 导通 $=E_1\cap(E_2\cup E_3)\cap E_4$。
  2. $P(E_2\cup E_3)=1-0.1^2=0.99$。

    并联用对立:两条都不通才断

  3. $p=0.9\times0.99\times0.9=0.8019\approx0.80$。

    两位有效数字是 $0.80$,不是保留两位小数

答案:$p\approx0.80$

(2)加 2 个模块后正常工作概率的变化

  1. 原器件:$X\sim B(20,p)$,正常 $\iff X\ge10$。新器件 22 个模块,正常 $\iff$ 导通数 $\ge11$。

  2. 以原 20 个的导通数 $X$ 为基准、新增 2 个的导通数为 $Y\sim B(2,p)$(与 $X$ 独立)分类:

    $X$ 新器件正常的条件
    $\ge11$ 一定正常
    $10$ $Y\ge1$,概率 $1-(1-p)^2$
    $9$ $Y=2$,概率 $p^2$
    $\le8$ 不可能
  3. 分别写出新、旧器件正常工作的概率并作差: $$ \begin{aligned} P_\text{新}&=P(X\ge11)+P(X=10)\big[1-(1-p)^2\big]+P(X=9)\,p^2\\ P_\text{旧}&=P(X\ge11)+P(X=10)\\ P_\text{新}-P_\text{旧}&=P(X=9)\,p^2-P(X=10)\,(1-p)^2 \end{aligned} $$

    $P(X\ge11)$ 两边抵消,只剩临界项

  4. 代入二项概率并提取公因式: $$ \begin{aligned} P_\text{新}-P_\text{旧}&=\mathrm{C}_{20}^9p^{11}(1-p)^{11}-\mathrm{C}_{20}^{10}p^{10}(1-p)^{12}\\ &=p^{10}(1-p)^{11}\big[\mathrm{C}_{20}^9p-\mathrm{C}_{20}^{10}(1-p)\big] \end{aligned} $$

  5. $\mathrm{C}_{20}^{10}=\tfrac{11}{10}\mathrm{C}_{20}^9$,代入 $p=0.8$: $$\mathrm{C}_{20}^9\Big[0.8-\tfrac{11}{10}\times0.2\Big]=\mathrm{C}_{20}^9\times0.58>0$$

    组合数相邻项之比 $\mathrm{C}_n^{k+1}/\mathrm{C}_n^k=(n-k)/(k+1)$

  6. 所以 $P_\text{新}>P_\text{旧}$,正常工作的概率增大。

    数值验证:原 $\approx0.99944$,新 $\approx0.99965$

答案:增大

易错

易错点:第 (2) 问直接写 $\sum_{k=11}^{22}$ 与 $\sum_{k=10}^{20}$ 硬算;或忽略“新增模块与原模块独立”这一前提。

例 22024 新课标全国 II 卷

第一阶段由一名队员投 3 次,3 次都不中则淘汰(0 分);至少中 1 次则进入第二阶段,由另一名队员投 3 次,每中一次得 5 分。甲每次投中概率 $p$,乙为 $q$,各次独立。

(1)$p=0.4,\ q=0.5$,甲打第一阶段,求成绩不少于 5 分的概率;

(2)设 $0<p<q$:(i) 要使得 15 分的概率最大,谁打第一阶段?(ii) 要使成绩期望最大,谁打第一阶段?

建模思路

两阶段相互独立 $\to$ 概率相乘。“至少中一次”用对立事件 $1-(1-p)^3$。比较两种安排:作差、因式分解、判断每个因子的符号。

解析

(1)成绩不少于 5 分

  1. 进入第二阶段:$1-0.6^3=0.784$。
  2. 第二阶段至少中 1 次:$1-0.5^3=0.875$。

    “不少于 5 分”= 第二阶段至少中一次

  3. 两阶段独立:$P=0.784\times0.875=0.686$。

答案:$0.686$

(2)(i) 15 分的概率

  1. 甲先:$P_\text{甲}=[1-(1-p)^3]\,q^3$;乙先:$P_\text{乙}=[1-(1-q)^3]\,p^3$。
  2. 展开 $1-(1-p)^3=3p-3p^2+p^3$,$p^3q^3$ 项两边相同,作差后抵消: $$P_\text{甲}-P_\text{乙}=q^3(3p-3p^2)-p^3(3q-3q^2)$$
  3. 整理: $$ \begin{aligned} P_\text{甲}-P_\text{乙}&=3pq\big[q^2(1-p)-p^2(1-q)\big]\\ &=3pq\big[(q^2-p^2)-pq(q-p)\big]\\ &=3pq(q-p)(p+q-pq) \end{aligned} $$

    也可写成 $3pq(p-q)(pq-p-q)$,与上式是同一个式子

  4. $q-p>0$;$p+q-pq=1-(1-p)(1-q)>0$。所以差为正,甲打第一阶段。

答案:甲参加第一阶段

(2)(ii) 成绩的期望

  1. 第二阶段若由乙投,得分 $5Y$,$Y\sim B(3,q)$,期望 $15q$。所以 $E_\text{甲先}=15q\,[1-(1-p)^3]$。

    先算条件期望,再乘进入第二阶段的概率

  2. 同理 $E_\text{乙先}=15p\,[1-(1-q)^3]$。作差: $$ \begin{aligned} E_\text{甲先}-E_\text{乙先}&=15pq\big[(3-3p+p^2)-(3-3q+q^2)\big]\\ &=15pq(q-p)(3-p-q) \end{aligned} $$
  3. $q-p>0$,$3-p-q>1>0$,差为正,甲打第一阶段。

答案:甲参加第一阶段

易错

易错点:漏掉“必须先通过第一阶段”;或把 15 分写成 3 次中至少 1 次。直觉:命中率低的人去“拿门票”,命中率高的人去“拿分”。

例 32024 广州一模

团队 $n$ 人依次上场。某人过第一关则继续闯第二关,否则换下一人闯第一关;某人过第二关则活动结束,否则换下一人直接闯第二关。所有人上场后也结束。每人过第一关、第二关的概率分别为 $\tfrac34,\tfrac12$,相互独立。

(1)$n=3$,$X$ 为结束时上场人数,求 $E(X)$;

(2)$p_k$ 为第 $k$ 位成员上场且闯过第二关的概率,$k_0$ 为 $\{k\mid p_k<\tfrac3{128}\}$ 的最小值,令 $n=k_0+1$,求 $n$。

建模思路

关键是“团队当前处在哪一关”:第一关一旦有人通过,后面的人只闯第二关。按第一个闯过第一关的人是谁分成互斥的情形,每个情形是独立事件的连乘。

解析

(1)$n=3$ 时 $E(X)$

  1. $X=1$:第 1 人连过两关,$\tfrac34\cdot\tfrac12=\tfrac38$。
  2. $X=2$:分两类(互斥)——第 1 人第一关失败、第 2 人连过两关:$\tfrac14\cdot\tfrac38=\tfrac3{32}$;第 1 人过一关、败二关,第 2 人过二关:$\tfrac38\cdot\tfrac12=\tfrac6{32}$。合计 $\tfrac9{32}$。

    第 2 人从第几关开始,取决于第 1 人在哪一关失败

  3. $X=3$:$1-\tfrac{12}{32}-\tfrac9{32}=\tfrac{11}{32}$。

    第 3 人上场即结束,不论成败

  4. $E(X)=\dfrac{1\cdot12+2\cdot9+3\cdot11}{32}=\dfrac{63}{32}$。

答案:$\dfrac{63}{32}$

(2)求 $n$

  1. 按“第一个过第一关的人” $i$ 分类,$1\le i\le k$:前 $i-1$ 人都败一关 $\left(\tfrac14\right)^{i-1}$;第 $i$ 人过一关 $\tfrac34$。
  2. $i=k$:第 $k$ 人还要过第二关,概率 $\left(\tfrac14\right)^{k-1}\cdot\tfrac34\cdot\tfrac12$。
  3. $i<k$:第 $i$ 到第 $k-1$ 人都败二关 $\left(\tfrac12\right)^{k-i}$,第 $k$ 人过二关 $\tfrac12$: $$\left(\tfrac14\right)^{i-1}\cdot\tfrac34\cdot\left(\tfrac12\right)^{k-i}\cdot\tfrac12$$

    第 $i$ 人自己在第二关也失败了,所以是 $k-i$ 个“败二关”

  4. 求和: $$ \begin{aligned} p_k&=\tfrac38\sum_{i=1}^{k}\left(\tfrac14\right)^{i-1}\left(\tfrac12\right)^{k-i}\\ &=\tfrac38\left(\tfrac12\right)^{k-1}\sum_{i=1}^k\left(\tfrac12\right)^{i-1}\\ &=\tfrac32\left[\left(\tfrac12\right)^k-\left(\tfrac14\right)^k\right] \end{aligned} $$

    $i=k$ 那项恰好也是这个通式,可以合并成一个等比数列求和

  5. $p_k<\tfrac3{128}\iff t-t^2<\tfrac1{64}$,$t=\left(\tfrac12\right)^k$。$p_k$ 关于 $k$ 递减,逐个检验:$k=5$:$\tfrac{31}{1024}>\tfrac{16}{1024}$;$k=6$:$\tfrac{63}{4096}<\tfrac{64}{4096}$。
  6. $k_0=6$,$n=7$。

答案:$7$

易错

易错点:以为每人都从第一关开始;或第 2 问只考虑“前 $k-1$ 人都没过第一关”一种情形。

课堂小测

课堂小测

掷一颗骰子,$A$:点数为偶数,$B$:点数为 1 或 2 或 3。则 $A$ 与 $B$

查看答案与解析

答案C

解析

$A\cap B=\{2\}\neq\varnothing$,不互斥;$P(AB)=\tfrac16\neq\tfrac12\cdot\tfrac12$,不独立。

辨析
  • A:$A\cap B=\{2\}$ 非空,所以不互斥
  • B:$P(AB)=\tfrac16$,$P(A)P(B)=\tfrac14$,不相等,不独立
  • D:$P(A)$、$P(B)$ 都大于 $0$ 时,互斥与独立不能同时成立。
课堂小测

甲、乙独立射击,命中率分别为 $0.8$、$0.7$。目标被击中的概率是

查看答案与解析

答案B

解析

$1-P(\bar A)P(\bar B)=1-0.2\times0.3=0.94$。

辨析
  • A:$0.56$ 是两人都命中的概率 $P(AB)$
  • C:直接相加 $0.8+0.7$ 超过 $1$:$A$、$B$ 并不互斥,不能直接相加
  • D:$0.38$ 是“恰有一人命中”:$0.8\times0.3+0.2\times0.7$。
课堂小测

下列说法正确的是

查看答案与解析

答案D

解析

$P(\bar A\bar B)=1-P(A\cup B)=1-P(A)-P(B)+P(A)P(B)=(1-P(A))(1-P(B))$。

辨析
  • A:反例见“辨析”一节:两枚硬币的 $A$、$B$、$C$ 两两独立,但 $P(ABC)\neq P(A)P(B)P(C)$
  • B:$P(A)$、$P(B)>0$ 时,互斥意味着 $P(AB)=0\neq P(A)P(B)$,一定不独立
  • C:反例:$P(A)=0$ 的事件与任何事件都独立($0=0\cdot P(B)$)。
专题 04

古典概型与几何概型:先保证“等可能”,再数

概率 = 有利结果 ÷ 全部结果,前提是每个结果等可能。数“个数”是古典概型,量“长度、面积”是几何概型。

看见:什么才是等可能

掷两颗骰子,点数和 2~12 共 11 种,每种概率是 $\dfrac1{11}$ 吗?

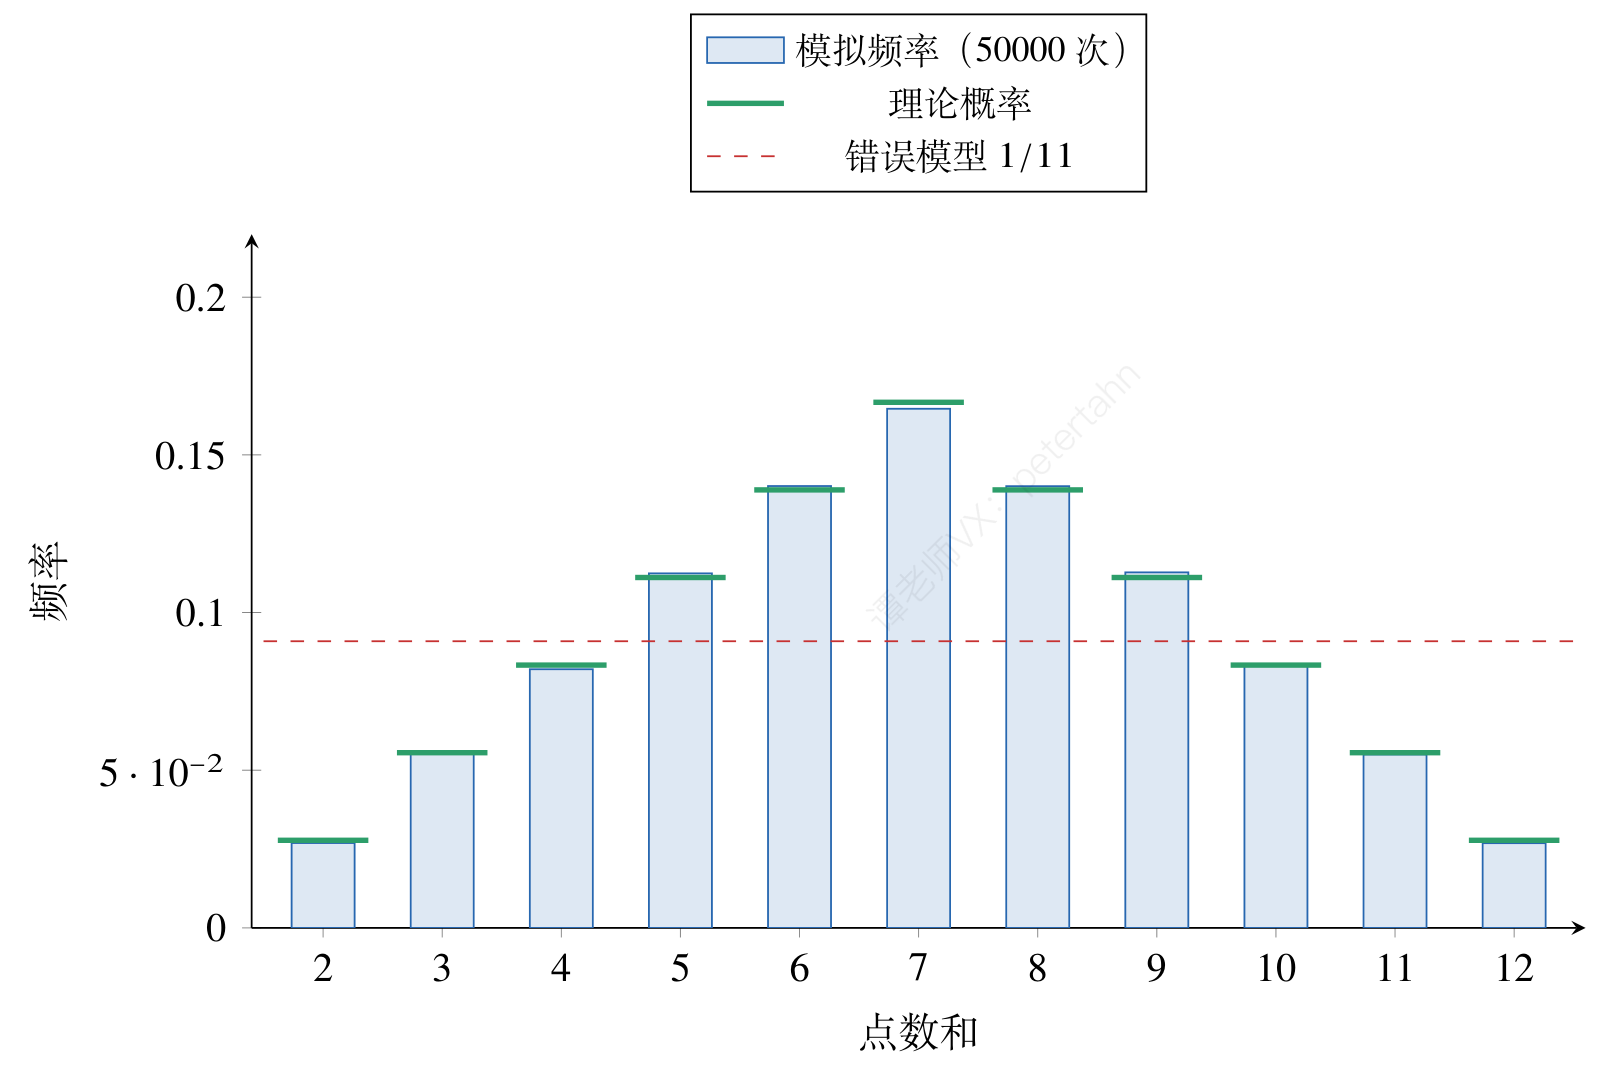
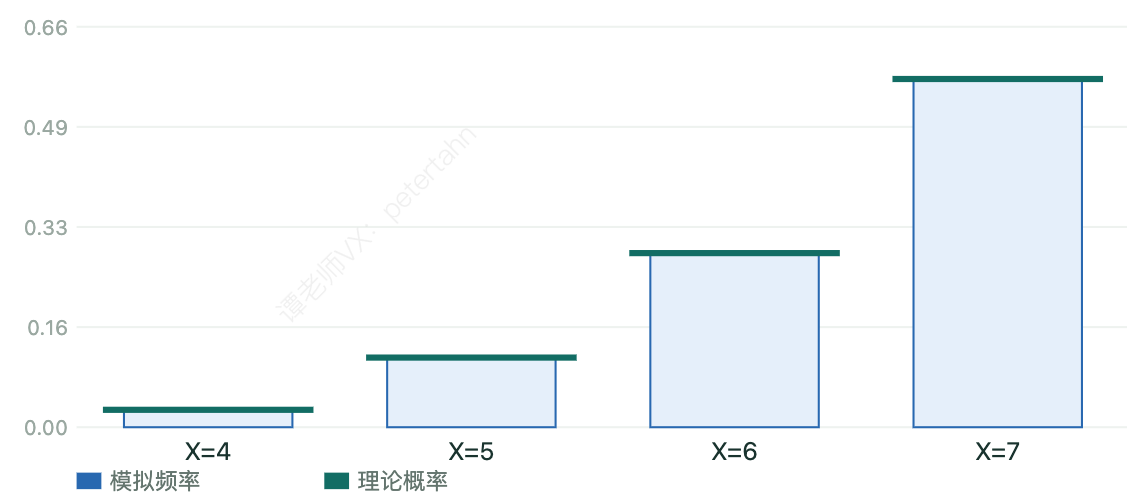
掷两颗骰子 50000 次的模拟频率(蓝柱),绿色短横线为理论概率,红色虚线为错误模型 1/11。
图 1掷两颗骰子 50000 次的模拟频率(蓝柱),绿色短横线为理论概率,红色虚线为错误模型 $1/11$。

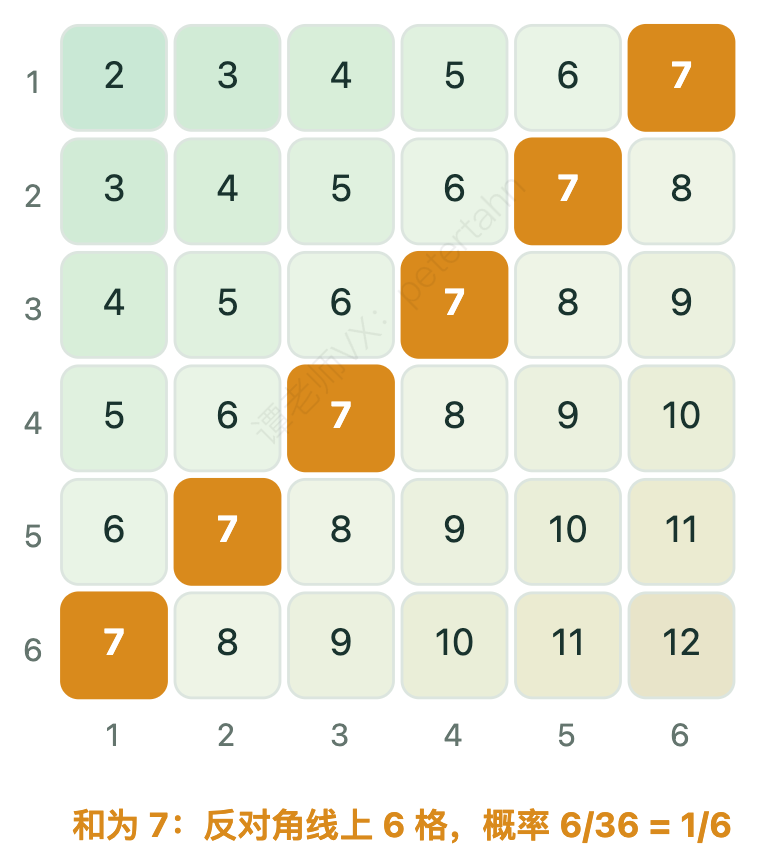
以和为 7 为例:理论概率 $P(\text{和为 }7)=\dfrac16\approx0.1667$,而错误模型给出 $\dfrac1{11}\approx0.0909$,实验频率接近前者。

为什么

“点数和”这 11 个结果不等可能:和为 7 有 6 种来源,和为 2 只有 1 种。真正等可能的是 36 个有序数对 $(a,b)$。

36 个有序数对 (a,b) 的点数和表:行为第一颗骰子点数 a,列为第二颗骰子点数 b,格中数字为 a+b。橙色格是和为 7 的 6 个数对,恰好排在反对角线上,概率 \frac6{36}=\frac16。
图 236 个有序数对 $(a,b)$ 的点数和表:行为第一颗骰子点数 $a$,列为第二颗骰子点数 $b$,格中数字为 $a+b$。橙色格是和为 7 的 6 个数对,恰好排在反对角线上,概率 $\frac6{36}=\frac16$。
判断等可能的办法

把结果拆到“物理上对称”的最细层次——每颗骰子的每一面、每个球(哪怕颜色相同也给它编号)。在这个层次上等可能,再把同类结果合并计数。

提示

历史上莱布尼茨就曾认为掷两颗骰子得 11 和得 12 一样容易——他把 $\{5,6\}$ 和 $\{6,6\}$ 都当成“一种”。实验频率可以纠正这种错误。

推导:两个公式与计数原则

古典概型

  1. 两个条件:(1) 样本空间 $\Omega$ 只有有限个样本点;(2) 每个样本点等可能。
  2. 设 $n(\Omega)=n$,每个样本点概率相同,由 $P(\Omega)=1$ 得每个都是 $\dfrac1n$。
  3. 事件 $A$ 含 $n(A)$ 个样本点,它们两两互斥,概率相加: $$P(A)=\underbrace{\tfrac1n+\cdots+\tfrac1n}_{n(A)\text{ 个}}=\frac{n(A)}{n(\Omega)}$$

    古典概型公式由“等可能 + 互斥事件加法”直接推出

  4. 计数一致原则:分子、分母必须在同一个样本空间里数。要么都考虑顺序(排列 $\mathrm{A}_n^k$),要么都不考虑(组合 $\mathrm{C}_n^k$)。

    例:5 球中 2 红,任取 2 球都红。有序 $\dfrac{\mathrm{A}_2^2}{\mathrm{A}_5^2}=\dfrac{2}{20}$,无序 $\dfrac{\mathrm{C}_2^2}{\mathrm{C}_5^2}=\dfrac1{10}$,结果相同

  5. 正难则反:$P(A)=1-P(\bar A)$。“至少一个”“不全相同”等题型,往往数对立事件更简单。
  6. 有放回 vs 不放回:有放回抽 $k$ 次,$n(\Omega)=n^k$(每次 $n$ 种);不放回,$n(\Omega)=\mathrm{A}_n^k$。例 1 中买 $n$ 个盲盒,样本空间就是 $3^n$。
古典概型公式

条件:样本点有限个,且每个样本点等可能。

$$P(A)=\frac{n(A)}{n(\Omega)}$$

分子、分母在同一个样本空间里数;“正难则反”:$P(A)=1-P(\bar A)$。

几何概型

  1. 样本点有无限多个(区间、区域中的点),但“均匀分布”:落在任一子区域的概率只与该区域的度量(长度 / 面积 / 体积)成正比。
  2. 比例常数由 $P(\Omega)=1$ 确定: $$P(A)=\frac{\mu(A)}{\mu(\Omega)}$$ 其中 $\mu$ 表示长度、面积或体积。
  3. 单个点的概率为 0,但它不是不可能事件:概率为 0 $\ne$ 不可能。

    所以几何概型里 “$\le$” 与 “$<$” 不影响概率

  4. 建模关键:选对变量和区域。两个独立、均匀的随机量 $(x,y)$ 对应正方形里均匀的一点,条件变成区域,概率就是面积比——这就是下一节的会面问题。
  5. 同一个问题,不同的“均匀”假设会给出不同答案(贝特朗悖论)。题目必须说明“随机”是对哪个量均匀。
几何概型公式

$$P(A)=\frac{\mu(A)}{\mu(\Omega)}\qquad(\mu\text{ 为长度、面积或体积})$$

建模关键:选对变量和区域,说明“均匀”是对哪个量而言。

几何概型:会面问题

甲、乙约定 7:00~8:00 间到达,先到者等 $t$ 分钟后离开,求两人会面的概率

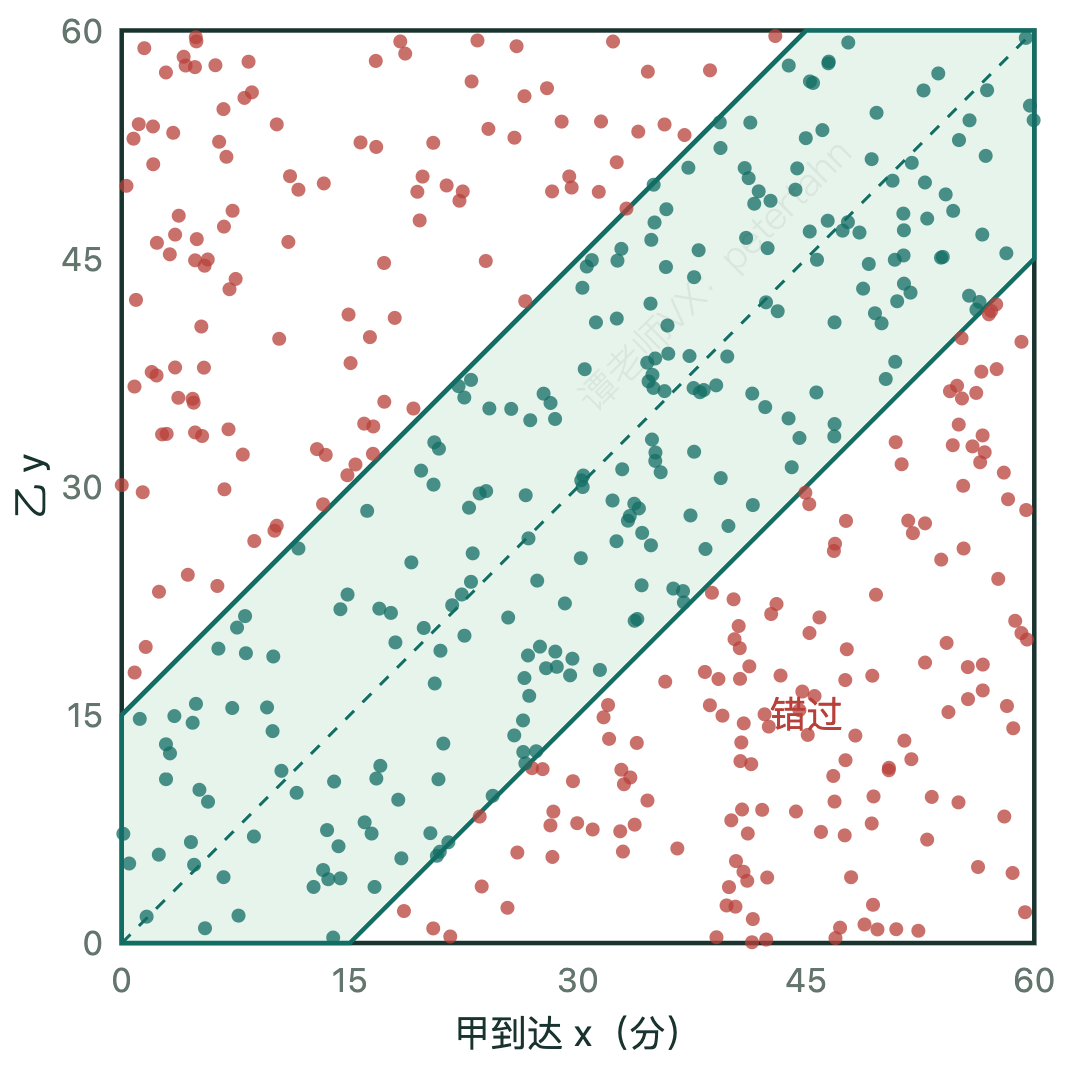
会面问题,取 t=15 分钟。横轴为甲到达时刻 x,纵轴为乙到达时刻 y(单位:分钟),正方形是全部可能的 (x,y)。绿色带状区域是 |x-y|\le15(两人会面),中间虚线为 y=x;绿点落在带内(会面),红点落在带外(错过),共 500 个随机点。带外是两个直角边为 45 的等腰直角三角形。
图 3会面问题,取 $t=15$ 分钟。横轴为甲到达时刻 $x$,纵轴为乙到达时刻 $y$(单位:分钟),正方形是全部可能的 $(x,y)$。绿色带状区域是 $|x-y|\le15$(两人会面),中间虚线为 $y=x$;绿点落在带内(会面),红点落在带外(错过),共 500 个随机点。带外是两个直角边为 $45$ 的等腰直角三角形。

推导

  1. 设甲、乙到达时刻分别为 $x,y$(分钟,$0\le x,y\le60$),独立且均匀,$(x,y)$ 是正方形内均匀的点:$\mu(\Omega)=60^2$。
  2. 会面 $\iff |x-y|\le t$,即两条直线 $y=x\pm t$ 之间的带状区域。
  3. 带外是两个直角边为 $60-t$ 的等腰直角三角形,面积合计 $(60-t)^2$。
  4. $$P=\frac{60^2-(60-t)^2}{60^2}=1-\left(1-\frac t{60}\right)^2$$
  5. $t=15$ 时: $$P=1-\left(\frac{45}{60}\right)^2=\dfrac{7}{16}\approx0.4375$$

随机投点时,落在带内的点所占比例会接近面积比 $0.4375$。

思路

随机投点估计面积比,就是蒙特卡洛方法。用同样的想法往正方形里投点,可以估计 $\pi$。

排列视角:不放回抽取

袋中 7 球,4 个黑球,不放回逐个摸,直到黑球全部摸出(例 2 的模型)

N=7、m=4 时,摸出最后一个黑球所需次数 X 的分布。蓝色柱为 2000 轮模拟的频率,绿色粗横线为理论概率 \frac{\mathrm{C}_{k-1}^{3}}{\mathrm{C}_7^4}:X=4,5,6,7 时依次为 \frac1{35},\frac4{35},\frac{10}{35},\frac{20}{35},越晚越可能。
图 4$N=7$、$m=4$ 时,摸出最后一个黑球所需次数 $X$ 的分布。蓝色柱为 2000 轮模拟的频率,绿色粗横线为理论概率 $\frac{\mathrm{C}_{k-1}^{3}}{\mathrm{C}_7^4}$:$X=4,5,6,7$ 时依次为 $\frac1{35},\frac4{35},\frac{10}{35},\frac{20}{35}$,越晚越可能。

把“摸球过程”看成“一次随机排列”

  1. 不放回摸完所有球,结果就是 $N$ 个球的一个排列,所有排列等可能。
  2. 只关心黑球占哪些位置:从 $N$ 个位置中选 $m$ 个,$n(\Omega)=\mathrm{C}_N^m$,每种选法等可能。

    同色球不必区分顺序,分子分母都用组合即可

  3. $X$ = 摸出最后一个黑球时的次数。$X=k$ 等价于:第 $k$ 个位置是黑球,且前 $k-1$ 个位置中恰有 $m-1$ 个黑球。
  4. $$P(X=k)=\frac{\mathrm{C}_{k-1}^{m-1}}{\mathrm{C}_N^m},\qquad k=m,m+1,\dots,N$$

    第 $k$ 位固定为黑,只需在前 $k-1$ 位里放剩下的 $m-1$ 个黑球

  5. 当 $N=7,\ m=4$ 时: $$E(X)=\sum_{k=4}^{7}k\cdot\frac{\mathrm{C}_{k-1}^{3}}{\mathrm{C}_{7}^{4}}=\dfrac{32}{5}=6.4$$

    一般结论 $E(X)=\dfrac{m(N+1)}{m+1}$;例 2 中 $N=7,m=4$:$\dfrac{4\times8}{5}=\dfrac{32}5$

最后一个黑球出现的次数

$N$ 个球中有 $m$ 个黑球,不放回摸球,$X$ 为摸出最后一个黑球时的次数:

$$P(X=k)=\frac{\mathrm{C}_{k-1}^{m-1}}{\mathrm{C}_N^m}\ (k=m,\dots,N),\qquad E(X)=\frac{m(N+1)}{m+1}$$

抽签公平

同一个道理:每个位置是黑球的概率都是 $\dfrac mN$,与“第几次摸”无关。

例题精讲

例 12024 广州调研 (B)

亚运盲盒(有放回计数 + 期望决策)

盲盒 19 元一个,随机装三款吉祥物之一(等可能);直接购买 30 元一个。

(1)逐个购买盲盒,首次出现相同款式时的购买次数为 $X$,求 $X$ 的分布列;

(2)为集齐三款,先一次性买不超过 3 个盲盒,未集齐再直接购买。以期望费用为依据,应买几个盲盒?

建模思路

买 $n$ 个盲盒 = 有放回抽 $n$ 次,等可能的样本点是长度为 $n$ 的款式序列,$n(\Omega)=3^n$。

解析

(1)$X$ 的分布列

  1. $X\in\{2,3,4\}$:只有 3 款,第 4 个必然与前面重复。

    抽屉原理

  2. $P(X=2)$:第 2 个与第 1 个相同,$\dfrac{3\times1}{3^2}=\dfrac13$。

  3. $P(X=3)$:前两个不同、第三个与其中之一相同,$\dfrac{\mathrm{A}_3^2\times2}{3^3}=\dfrac49$。

  4. $P(X=4)$:前三个各不相同,$\dfrac{\mathrm{A}_3^3}{3^3}=\dfrac29$。

    $X$ 2 3 4
    $P$ $\frac13$ $\frac49$ $\frac29$

(2)买几个盲盒

  1. 买 0 个:$90$ 元;买 1 个:$19+60=79$ 元。
  2. 买 2 个:不同款 $\dfrac{\mathrm{A}_3^2}{9}=\dfrac23$,花 $38+30=68$;同款 $\dfrac13$,花 $38+60=98$。$E=68\cdot\dfrac23+98\cdot\dfrac13=78$。
  3. 买 3 个:全不同 $\dfrac{6}{27}=\dfrac29$,花 $57$;恰两款 $\dfrac{\mathrm{C}_3^1\mathrm{C}_2^1\mathrm{C}_3^2}{27}=\dfrac{18}{27}=\dfrac23$,花 $87$;全相同 $\dfrac{3}{27}=\dfrac19$,花 $117$。

    恰两款:选重复的款 × 选另一款 × 重复款占哪两个位置

  4. $E=57\cdot\dfrac29+87\cdot\dfrac23+117\cdot\dfrac19=\dfrac{251}3\approx83.7$。
  5. 比较 $90,\,79,\,78,\,83.7$:买 2 个盲盒期望费用最低。

答案:一次性买 2 个盲盒

易错

易错点:把“款式组合”当样本点(如 3 个盲盒的 {全同, 两款, 三款}),它们不等可能。

例 22023 武汉二月调研

不放回摸到最后一个黑球

口袋 7 球,4 黑。不放回逐个抽取,直到 4 个黑球全部取出为止。

(1)总抽取次数为 $X$,求 $E(X)$;

(2)改为甲袋 3 球(2 黑)、乙袋 4 球(2 黑),先在甲袋中取到 2 黑全出,再在乙袋中取到 2 黑全出。总次数为 $Y$,求 $E(Y)$ 并解释与 $E(X)$ 的大小关系。

建模思路

不放回取完 = 一个随机排列。$X=k$ 等价于“第 $k$ 位是黑,前 $k-1$ 位恰有 $m-1$ 个黑”,所以 $P(X=k)=\dfrac{\mathrm{C}_{k-1}^{m-1}}{\mathrm{C}_N^m}$(见“排列视角”一节)。

解析

(1)$E(X)$

  1. $X\in\{4,5,6,7\}$,$n(\Omega)=\mathrm{C}_7^4=35$(黑球占哪 4 个位置)。
  2. $P(X=k)=\dfrac{\mathrm{C}_{k-1}^3}{35}$:$\dfrac1{35},\ \dfrac4{35},\ \dfrac{10}{35},\ \dfrac{20}{35}$。
  3. $E(X)=\dfrac{4+20+60+140}{35}=\dfrac{224}{35}=\dfrac{32}5$。

答案:$\dfrac{32}5$

(2)$E(Y)$ 与解释

  1. $Y=Y_1+Y_2$。甲袋 $N=3,m=2$:$P(Y_1=2)=\dfrac13,\ P(Y_1=3)=\dfrac23$,$E(Y_1)=\dfrac83$。
  2. 乙袋 $N=4,m=2$:$P(Y_2=k)=\dfrac{\mathrm{C}_{k-1}^1}{\mathrm{C}_4^2}=\dfrac16,\dfrac26,\dfrac36$($k=2,3,4$),$E(Y_2)=\dfrac{10}3$。
  3. $E(Y)=E(Y_1)+E(Y_2)=6$。

    期望的线性性:不必先求 $Y$ 的分布列

  4. $E(Y)=6<\dfrac{32}5=E(X)$。解释:分袋后,甲袋的白球不会混进乙袋的抽取过程;甲袋黑球取完就转到乙袋,相当于提前排除了一部分白球的干扰。

答案:$E(Y)=6<E(X)$

易错

易错点:把 $P(X=k)$ 的分子写成 $\mathrm{C}_k^4$:忘了第 $k$ 次必须是黑球。

例 32024 湖北 12 月联考

摘麦穗(秘书问题)

$n$ 颗大小互不相同的麦穗依次出现,只能摘一次、不能回头。策略:跳过前 $k$ 颗,从第 $k+1$ 颗起,遇到比之前都大的就摘,否则摘最后一颗。设 $k=tn$,摘到最大麦穗的概率为 $P$(可用 $\dfrac kn\sum_{j=k}^{n-1}\dfrac1j\approx\dfrac kn\ln\dfrac nk$)。

(1)$n=4,k=2$,求 $P$;

(2)$n\to\infty$,求 $P$ 的最大值及此时的 $t$。

建模思路

(1) 样本空间是 4 颗麦穗的全排列,用古典概型数。(2) 按最大麦穗所在位置 $j$ 用全概率公式,关键条件概率:第 $j$ 颗被摘 $\iff$ 前 $j-1$ 颗中的最大者落在前 $k$ 颗里。

解析

(1)$n=4$,$k=2$

  1. $n(\Omega)=\mathrm{A}_4^4=24$。要摘到最大的,它必须在第 3 或第 4 位。
  2. 最大在第 3 位:一定比前 2 颗都大,会被摘下。其余 3 颗任意排,$3!=6$ 种。
  3. 最大在第 4 位:需要第 3 颗不被摘,即前 3 颗中的最大者(第二大)在前 2 位。第二大的位置 2 种 × 其余 2 颗排列 2 种 $=4$ 种。

    若第 3 颗是前 3 颗中最大的,就会被摘走,轮不到第 4 颗

  4. $P=\dfrac{6+4}{24}=\dfrac5{12}$。

    逐一枚举全部 24 种排列,结果一致

答案:$\dfrac5{12}$

(2)$n\to\infty$ 时的最大值

  1. $B_j$:最大麦穗在第 $j$ 位,$P(B_j)=\dfrac1n$。$A$:摘到最大的。
  2. $j\le k$:被跳过,$P(A\mid B_j)=0$。$j\ge k+1$:$P(A\mid B_j)=\dfrac{k}{j-1}$。

    前 $j-1$ 颗中的“临时冠军”在 $j-1$ 个位置上等可能,落在前 $k$ 个的概率为 $\dfrac k{j-1}$

  3. 全概率: $$\begin{aligned} P&=\sum_{j=k+1}^n\frac1n\cdot\frac k{j-1}=\frac kn\sum_{j=k}^{n-1}\frac1j\\ &\approx\frac kn\ln\frac nk=-t\ln t \end{aligned}$$
  4. $f(t)=-t\ln t$,$f'(t)=-\ln t-1$,$t<\dfrac1e$ 时递增,$t>\dfrac1e$ 时递减。
  5. $t=\dfrac1e$ 时取最大值 $f\!\left(\dfrac1e\right)=\dfrac1e\approx0.368$。

    “37% 法则”:先观察约 37%,再选第一个比之前都好的

答案:$P_{\max}=\dfrac1e$,此时 $t=\dfrac1e$

易错

易错点:最大在第 4 位时,误以为一定能摘到;忽略了第 3 颗可能先被摘走。

课堂小测

课堂小测

同时抛两枚均匀硬币,“一正一反”的概率是

查看答案与解析

答案B

解析

等可能的样本点是 正正、正反、反正、反反,其中一正一反有 2 个,$P=\dfrac24=\dfrac12$。

辨析
  • A:把{两正, 两反, 一正一反}当成 3 个等可能结果——它们不等可能
  • C:$\dfrac14$ 是“两正”或“两反”的概率
  • D:$\dfrac34$ 是“至少一个正面”的概率。
课堂小测

5 件产品中有 2 件次品,任取 2 件,恰有 1 件次品的概率是

查看答案与解析

答案C

解析

$\dfrac{\mathrm{C}_2^1\mathrm{C}_3^1}{\mathrm{C}_5^2}=\dfrac6{10}=\dfrac35$。

辨析
  • A:只数了“先次品后正品”一种顺序:$\dfrac25\times\dfrac34=\dfrac3{10}$,漏了“先正品后次品”,应再乘 2
  • B:这是“至少一件次品”的概率 $1-\dfrac{\mathrm{C}_3^2}{\mathrm{C}_5^2}=\dfrac7{10}$
  • D:$\dfrac25$ 是任取 1 件为次品的概率。
课堂小测

在区间 $[0,3]$ 上随机取一个数 $x$,则 $x^2\le1$ 的概率是

查看答案与解析

答案A

解析

$x\in[0,3]$ 且 $x^2\le1\iff 0\le x\le1$,长度比 $\dfrac13$。

辨析
  • B:对 $x^2$ 均匀才会得到 $\dfrac19$,题目是 $x$ 均匀,不是 $x^2$ 均匀
  • C:$-1\le x\le1$ 的长度为 2,但 $x$ 只在 $[0,3]$ 上取值,交集只有 $[0,1]$
  • D:几何概型按长度比计算,不是 $\dfrac12$。
专题 05

分布列·期望·方差:概率是质量,期望是重心

把每个取值处放一块质量为 $P(X=x)$ 的砝码。期望是这根木板的平衡点,方差是绕平衡点的转动惯量。

看见:分布列是一根木板

每个取值处放一块砝码,质量 = 概率

在数轴的每个取值 $x$ 处放一块质量为 $P(X=x)$ 的砝码,这就是分布列的“木板模型”。把支点放在位置 $t$,木板会向重的一侧倾斜。

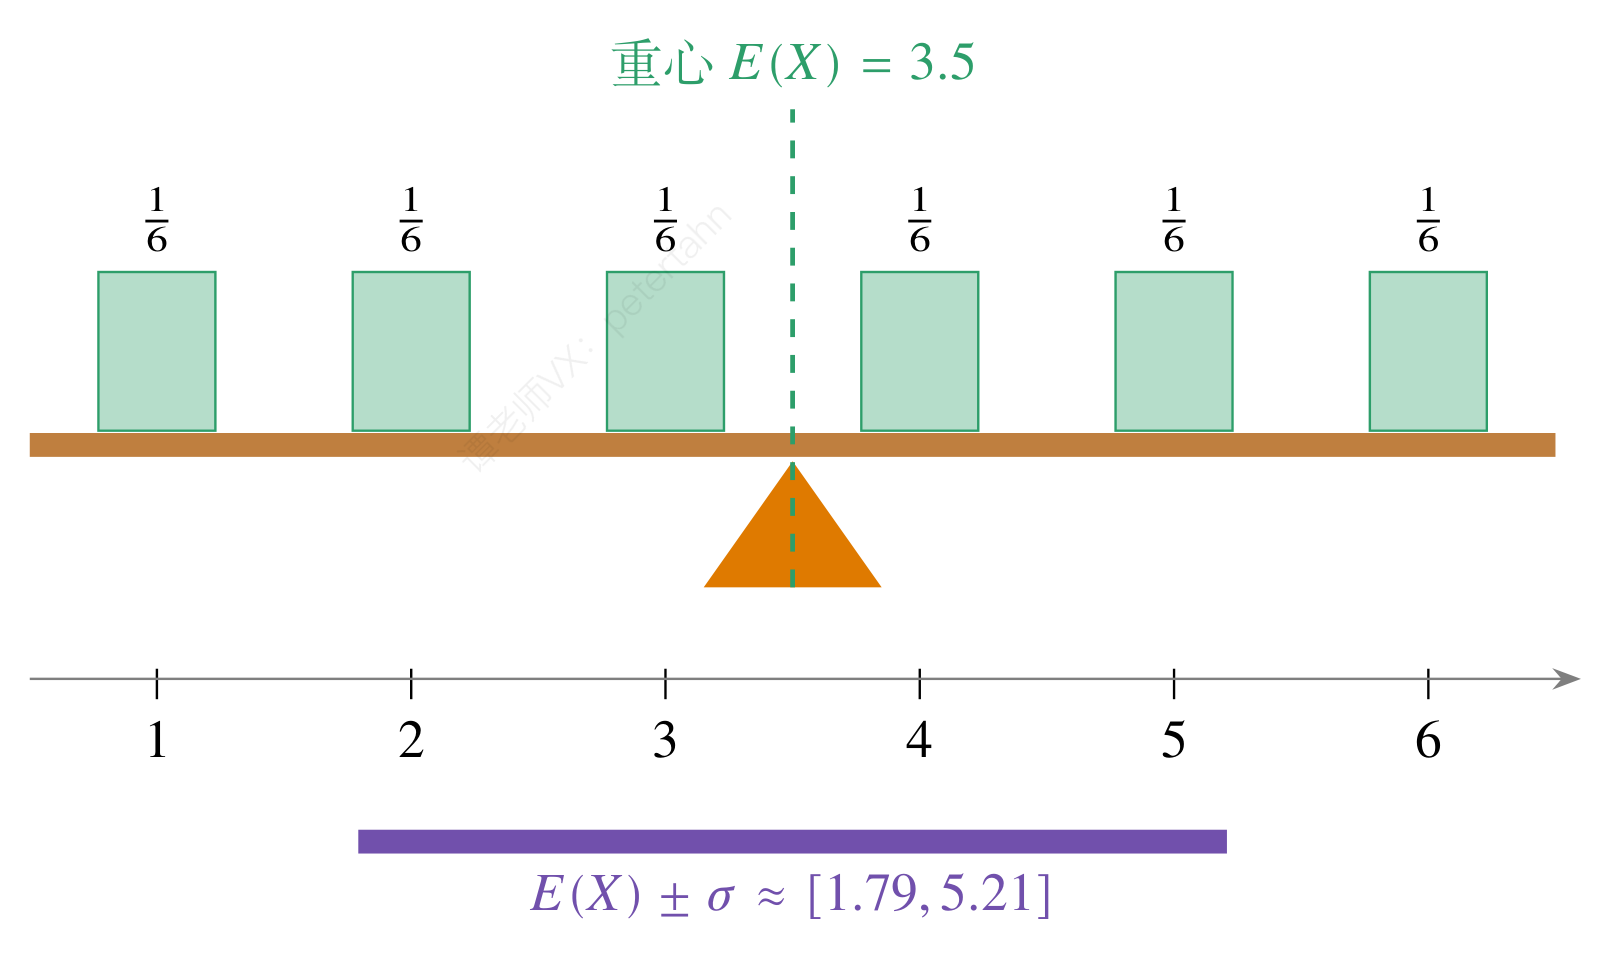
均匀骰子的分布列木板:六块同色砝码质量均为 1/6,支点位于重心 E(X)=3.5,木板水平;底部紫色条为 E(X)\pm\sigma\approx[1.79,5.21]。
图 1均匀骰子的分布列木板:六块同色砝码质量均为 $1/6$,支点位于重心 $E(X)=3.5$,木板水平;底部紫色条为 $E(X)\pm\sigma\approx[1.79,5.21]$。

读数

均匀骰子($X=1,2,\dots,6$,每个取值概率 $\tfrac16$)的各项读数:

  • $E(X)$(重心):$\dfrac72\approx3.5$;
  • $D(X)$(转动惯量):$\dfrac{35}{12}\approx2.917$;
  • $\sigma=\sqrt{D(X)}\approx1.708$;
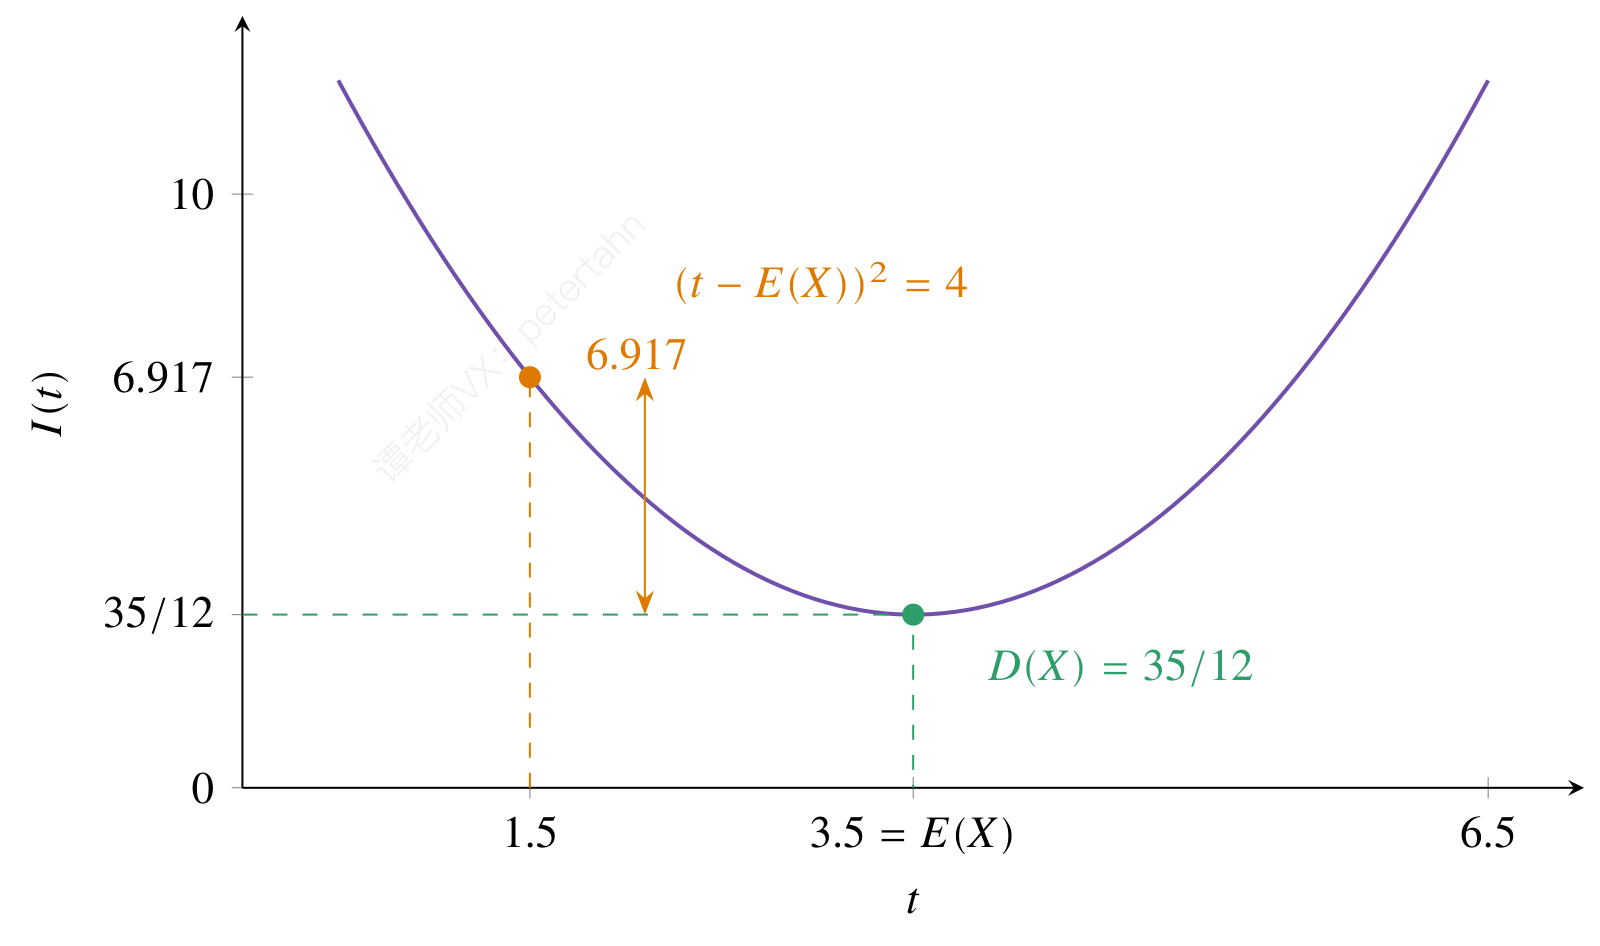
  • 绕支点 $t=1.5$ 的力矩 $\sum(x-t)p$:$3.5-1.5=2$。
$x$ $1$ $2$ $3$ $4$ $5$ $6$ 合计
$p$ $\tfrac{1}{6}$ $\tfrac{1}{6}$ $\tfrac{1}{6}$ $\tfrac{1}{6}$ $\tfrac{1}{6}$ $\tfrac{1}{6}$ $1$
$xp$ $\tfrac{1}{6}$ $\tfrac{1}{3}$ $\tfrac{1}{2}$ $\tfrac{2}{3}$ $\tfrac{5}{6}$ $1$ $\tfrac{7}{2}$
$(x-\mu)^2p$ $\tfrac{25}{24}$ $\tfrac{3}{8}$ $\tfrac{1}{24}$ $\tfrac{1}{24}$ $\tfrac{3}{8}$ $\tfrac{25}{24}$ $\tfrac{35}{12}$
转动惯量 I(t)=35/12+(t-3.5)^2;最低点为 (3.5,35/12),橙点为 (1.5,83/12),两点高度差为 4。
图 2转动惯量 $I(t)=35/12+(t-3.5)^2$;最低点为 $(3.5,35/12)$,橙点为 $(1.5,83/12)$,两点高度差为 $4$。
力矩与转动惯量

力矩 $\sum(x_i-t)p_i=E(X)-t$,只有 $t=E(X)$ 时木板平衡。

转动惯量 $\sum(x_i-t)^2p_i=D(X)+\bigl(t-E(X)\bigr)^2$,在重心处最小,最小值就是方差。

同一重心,不同的“转动惯量”

把砝码的质量换一种分配,重心和方差都会随之改变。下表列出几种常用分布:

分布 取值与概率 $E(X)$ $D(X)$ $\sigma$
均匀骰子 $x=1,\dots,6$,概率均为 $\tfrac16$ $\tfrac72$ $\tfrac{35}{12}$ $1.708$
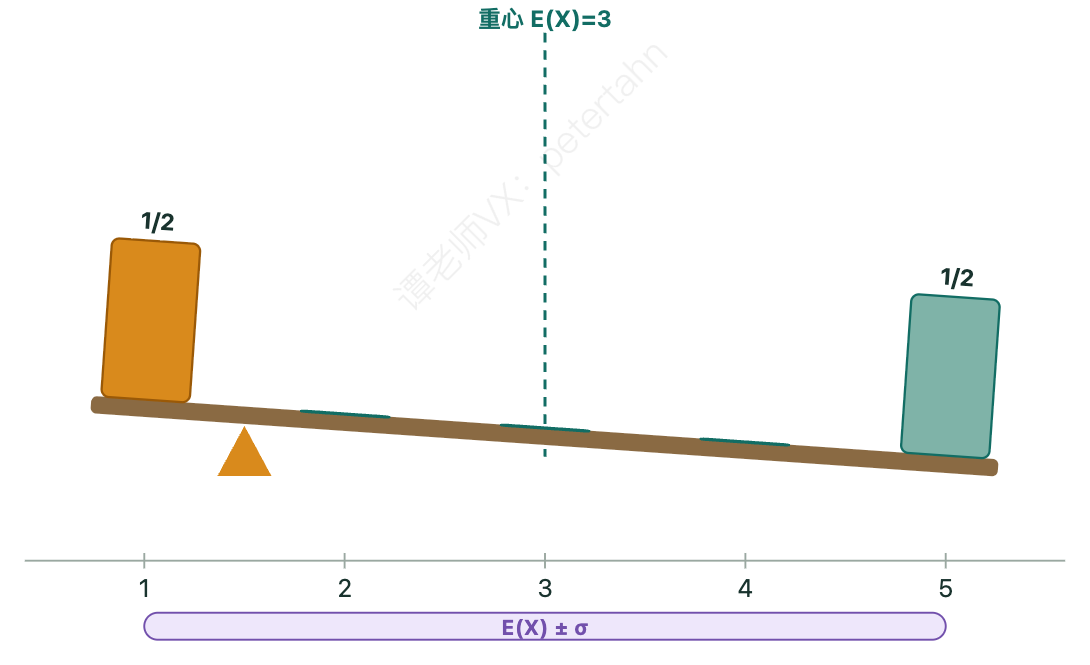
两端 $x=1,5$,概率各 $\tfrac12$,其余为 $0$ $3$ $4$ $2$
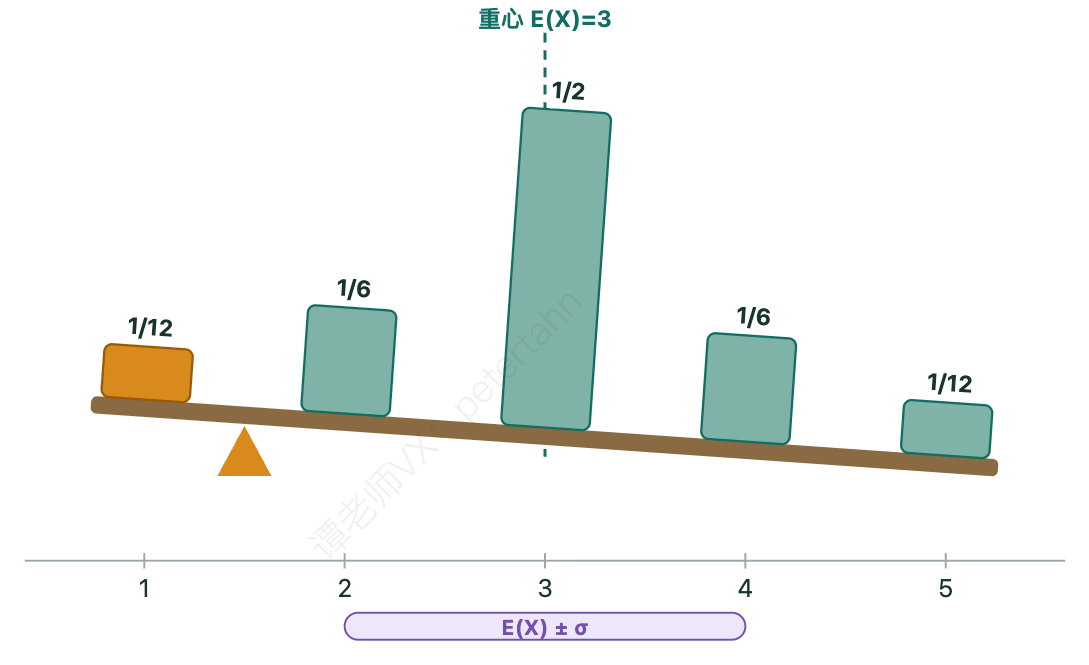
集中在中间 $x=1,\dots,5$:$\tfrac1{12},\tfrac16,\tfrac12,\tfrac16,\tfrac1{12}$ $3$ $1$ $1$
右偏 $x=0,\dots,5$:$\tfrac13,\tfrac5{18},\tfrac16,\tfrac19,\tfrac1{18},\tfrac1{18}$ $\tfrac{13}9$ $\tfrac{173}{81}$ $1.461$
例 3(2)的得分 $x=0,1,2,3,7$:$\tfrac8{27},\tfrac{12}{27},\tfrac2{27},\tfrac4{27},\tfrac1{27}$ $\tfrac{35}{27}$ $\tfrac{1610}{729}\approx2.2085$ $1.486$

其中“两端”与“集中在中间”的重心相同(都是 $E(X)=3$),方差却差了 4 倍:砝码越往两侧放,绕重心的转动惯量越大。

“两端”分布:质量 \tfrac12 的两块砝码分别放在 x=1 和 x=5,重心 E(X)=3,\sigma=2,紫色条 E(X)\pm\sigma 覆盖整根木板
图 3“两端”分布:质量 $\tfrac12$ 的两块砝码分别放在 $x=1$ 和 $x=5$,重心 $E(X)=3$,$\sigma=2$,紫色条 $E(X)\pm\sigma$ 覆盖整根木板
“集中在中间”分布:质量集中在 x=3(\tfrac12),两侧递减,重心同样是 E(X)=3,但 \sigma=1,紫色条只覆盖 2\sim4
图 4“集中在中间”分布:质量集中在 $x=3$($\tfrac12$),两侧递减,重心同样是 $E(X)=3$,但 $\sigma=1$,紫色条只覆盖 $2\sim4$

推导:线性变换与方差公式

从定义出发,一行一行推

  1. 期望的定义:$X$ 取 $x_1,\dots,x_n$,概率 $p_1,\dots,p_n$:

    $$E(X)=\sum_{i=1}^{n}x_ip_i$$

    做 $N$ 次试验,取到 $x_i$ 约 $Np_i$ 次,平均值 $\approx\sum x_i\cdot\dfrac{Np_i}{N}$。频率稳定于概率,平均值稳定于 $E(X)$

  2. 重心性质:记 $\mu=E(X)$,

    $$\sum(x_i-\mu)p_i=\sum x_ip_i-\mu\sum p_i=\mu-\mu=0$$

    用到 $\sum p_i=1$。偏差的加权和为 $0$:这就是“力矩平衡”

  3. 线性变换:$Y=aX+b$ 取 $ax_i+b$ 的概率仍是 $p_i$,

    $$E(aX+b)=\sum(ax_i+b)p_i=a\sum x_ip_i+b\sum p_i=aE(X)+b$$

    若某些 $ax_i+b$ 相同(如 $a=0$),合并后求和结果不变

  4. 方差的定义:偏差平方的加权平均

    $$D(X)=\sum(x_i-\mu)^2p_i$$

    偏差有正有负会抵消(第 2 步),平方后才能衡量“离重心有多远”

  5. 方差的线性变换:$aX+b$ 的期望是 $a\mu+b$,偏差 $(ax_i+b)-(a\mu+b)=a(x_i-\mu)$,

    $$D(aX+b)=\sum a^2(x_i-\mu)^2p_i=a^2D(X)$$

    平移 $b$ 不改变离散程度;伸缩 $a$ 倍,偏差变 $a$ 倍,平方后变 $a^2$ 倍

  6. 计算公式:展开 $(x_i-\mu)^2=x_i^2-2\mu x_i+\mu^2$,

    $$D(X)=\sum x_i^2p_i-2\mu\sum x_ip_i+\mu^2\sum p_i=E(X^2)-\mu^2$$

    中间项 $2\mu\cdot\mu$ 与末项 $\mu^2$ 合并为 $-\mu^2$。考试中常用:先算 $E(X^2)$ 再减

  7. 平行轴公式:对任意 $t$,

    $$\sum(x_i-t)^2p_i=\sum\bigl[(x_i-\mu)+(\mu-t)\bigr]^2p_i=D(X)+(\mu-t)^2$$

    交叉项 $2(\mu-t)\sum(x_i-\mu)p_i$ 由第 2 步等于 $0$。所以绕重心的转动惯量最小

  8. 推论:$D(X)\ge0$,即 $E(X^2)\ge[E(X)]^2$;$D(X)=0$ 当且仅当 $X$ 只取一个值(概率为 $1$)。

期望与方差的常用公式

$$ \begin{aligned} E(aX+b)&=aE(X)+b\\ D(aX+b)&=a^2D(X)\\ D(X)&=E(X^2)-[E(X)]^2 \end{aligned} $$

$Y=aX+b$:分布整体伸缩、平移

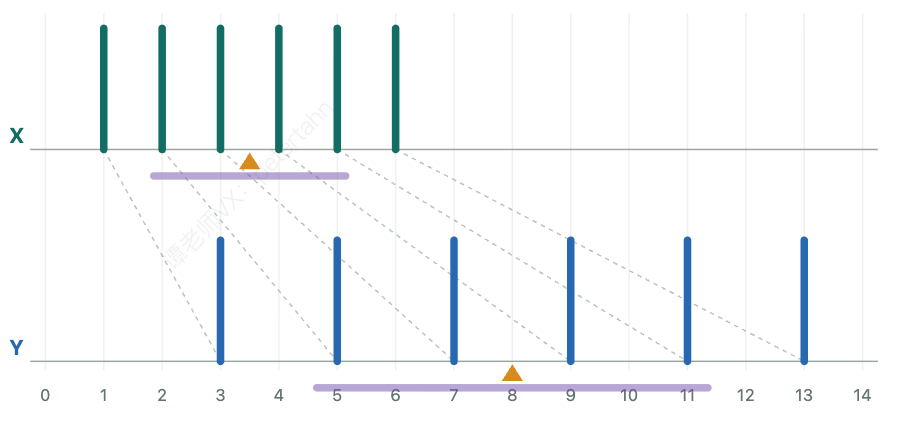
取均匀骰子的分布为 $X$,令 $Y=2X+1$($a=2,\ b=1$)。概率不变,只是取值“搬家”。

上排是 X 的分布(绿色,取值 1\sim6),下排是 Y=2X+1 的分布(蓝色,取值 3,5,\dots,13),灰色虚线连接对应的取值;橙色三角标出各自的期望(E(X)=3.5,E(Y)=8),紫色条表示 E\pm\sigma,Y 的紫色条比 X 的宽一倍
图 5上排是 $X$ 的分布(绿色,取值 $1\sim6$),下排是 $Y=2X+1$ 的分布(蓝色,取值 $3,5,\dots,13$),灰色虚线连接对应的取值;橙色三角标出各自的期望($E(X)=3.5$,$E(Y)=8$),紫色条表示 $E\pm\sigma$,$Y$ 的紫色条比 $X$ 的宽一倍

$$ \begin{aligned} E(Y)&=aE(X)+b=2\cdot\tfrac{7}{2}+1=8\\ D(Y)&=a^2D(X)=4\cdot\tfrac{35}{12}=\tfrac{35}{3} \end{aligned} $$

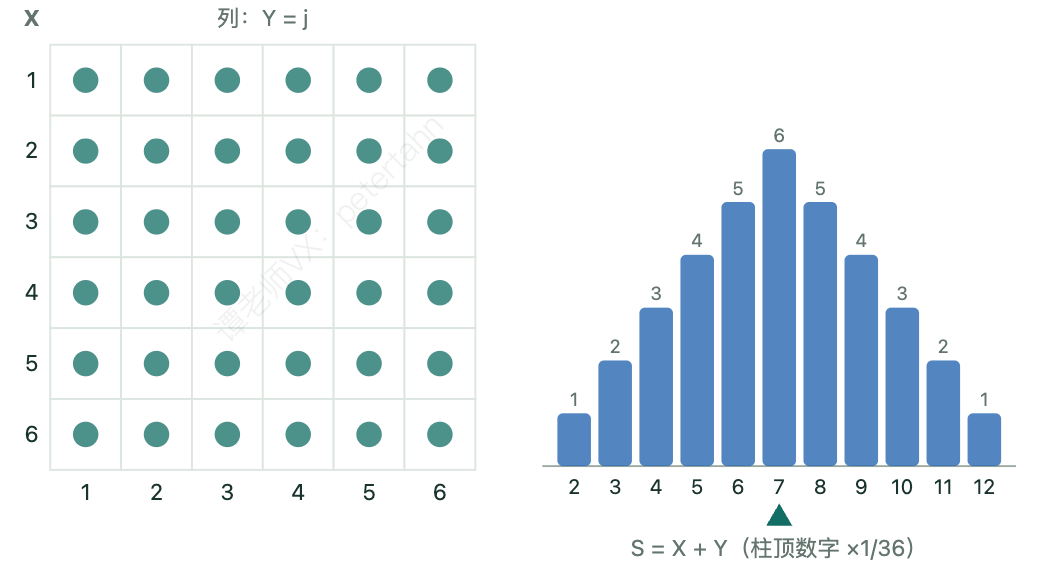
线性性:$E(X+Y)$ 不需要独立

掷两颗骰子:$X$ 是第一颗,$Y$ 另行指定

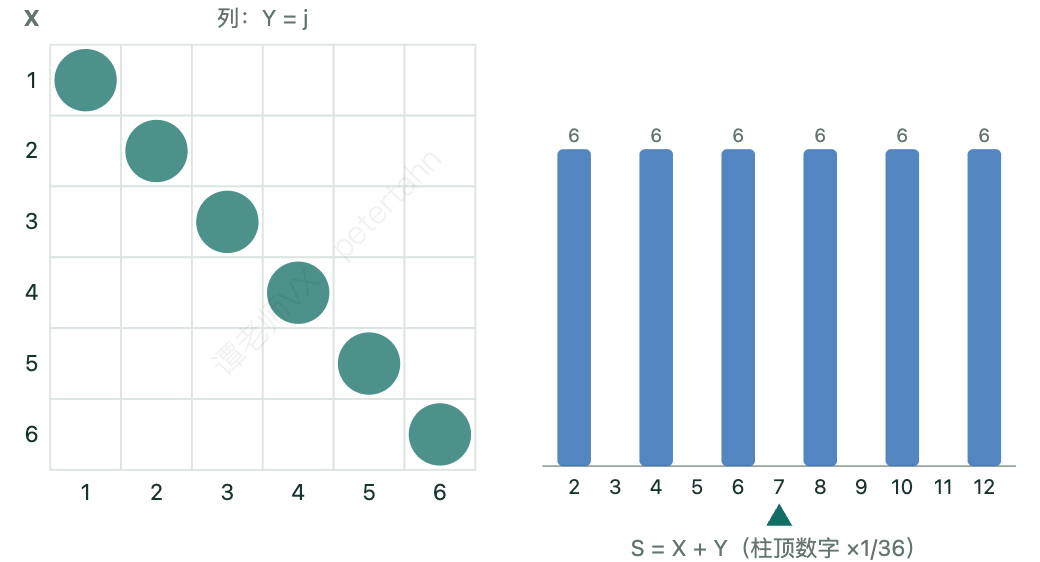
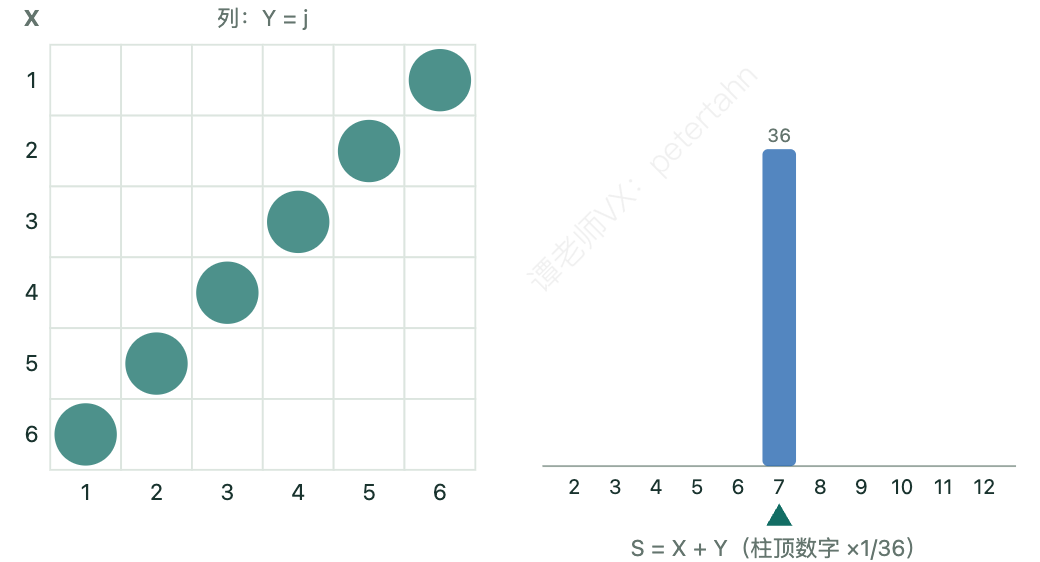
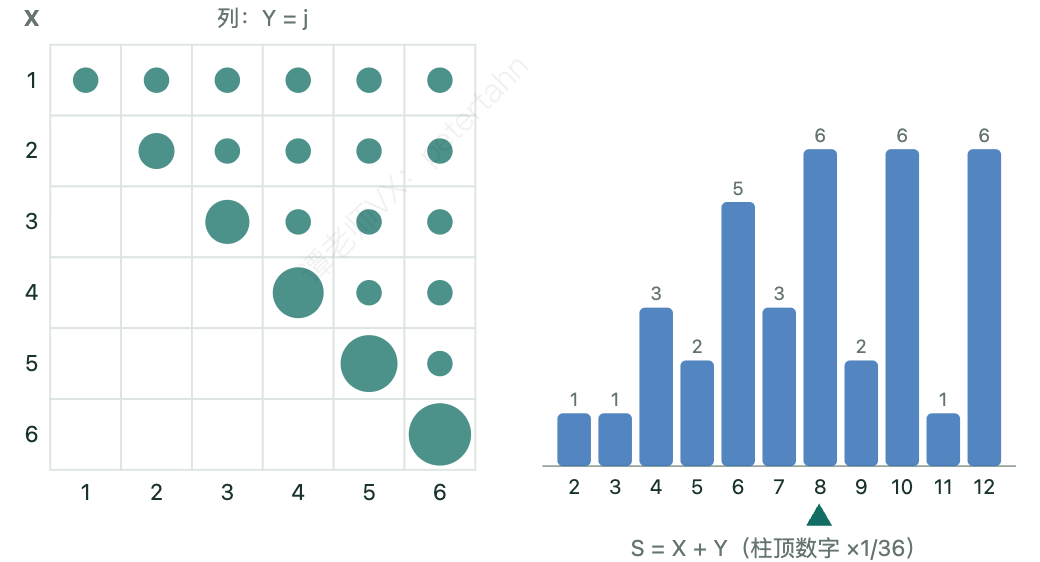
设 $X$ 为第一颗骰子的点数,$Y$ 取下面四种不同的量。每种情形的图都这样读:左图是联合分布,行为 $X=i$、列为 $Y=j$,圆的面积正比于 $P(X=i,Y=j)$;右图是 $S=X+Y$ 的分布列,柱顶数字乘以 $\tfrac1{36}$ 即概率,绿色三角标出 $E(S)$。

情形一:$Y$ = 第二颗点数(独立)

X、Y 独立:36 个格子的圆一样大,每格概率 \tfrac1{36};右图 S=X+Y 的分布呈三角形,在 S=7 处最高(\tfrac6{36}),绿色三角位于 E(S)=7
图 6$X$、$Y$ 独立:36 个格子的圆一样大,每格概率 $\tfrac1{36}$;右图 $S=X+Y$ 的分布呈三角形,在 $S=7$ 处最高($\tfrac6{36}$),绿色三角位于 $E(S)=7$
$X$ $Y$ $X+Y$ 直接算 分别相加
$E$ $\tfrac{7}{2}$ $\tfrac{7}{2}$ $7$ $7$
$D$ $\tfrac{35}{12}$ $\tfrac{35}{12}$ $\tfrac{35}{6}$ $\tfrac{35}{6}$

此时 $E(XY)-E(X)E(Y)=0$。结论:$E(X+Y)=E(X)+E(Y)$ 成立;$D(X+Y)=D(X)+D(Y)$ 也成立(独立)。

情形二:$Y=X$(完全相同)

Y=X:联合分布只落在对角线上,每个对角格的概率 \tfrac6{36};S=2X 只取偶数 2,4,\dots,12,每个值概率 \tfrac6{36},绿色三角位于 E(S)=7
图 7$Y=X$:联合分布只落在对角线上,每个对角格的概率 $\tfrac6{36}$;$S=2X$ 只取偶数 $2,4,\dots,12$,每个值概率 $\tfrac6{36}$,绿色三角位于 $E(S)=7$
$X$ $Y$ $X+Y$ 直接算 分别相加
$E$ $\tfrac{7}{2}$ $\tfrac{7}{2}$ $7$ $7$
$D$ $\tfrac{35}{12}$ $\tfrac{35}{12}$ $\tfrac{35}{3}$ $\tfrac{35}{6}$

此时 $E(XY)-E(X)E(Y)=\tfrac{35}{12}$。结论:$E(X+Y)=E(X)+E(Y)$ 成立;$D(X+Y)>D(X)+D(Y)$,方差不可直接相加。

情形三:$Y=7-X$(反向)

Y=7-X:联合分布落在反对角线上;S=X+Y\equiv7 恒为常数,右图只有 S=7 一根柱(概率 \tfrac{36}{36}=1)
图 8$Y=7-X$:联合分布落在反对角线上;$S=X+Y\equiv7$ 恒为常数,右图只有 $S=7$ 一根柱(概率 $\tfrac{36}{36}=1$)
$X$ $Y$ $X+Y$ 直接算 分别相加
$E$ $\tfrac{7}{2}$ $\tfrac{7}{2}$ $7$ $7$
$D$ $\tfrac{35}{12}$ $\tfrac{35}{12}$ $0$ $\tfrac{35}{6}$

此时 $E(XY)-E(X)E(Y)=-\tfrac{35}{12}$。结论:$E(X+Y)=E(X)+E(Y)$ 成立;$D(X+Y)<D(X)+D(Y)$,方差不可直接相加。

情形四:$Y$ = 两颗中的较大者

Y=\max:联合分布只在对角线及其右上方有圆,且 Y\ge X;格 (i,i) 对应 i 个结果(圆最大的是 (6,6)),格 (i,j)(j>i)对应 1 个结果;右图是 S=X+Y 的分布,绿色三角位于 E(S)=\tfrac{287}{36}\approx7.97
图 9$Y=\max$:联合分布只在对角线及其右上方有圆,且 $Y\ge X$;格 $(i,i)$ 对应 $i$ 个结果(圆最大的是 $(6,6)$),格 $(i,j)$($j>i$)对应 1 个结果;右图是 $S=X+Y$ 的分布,绿色三角位于 $E(S)=\tfrac{287}{36}\approx7.97$
$X$ $Y$ $X+Y$ 直接算 分别相加
$E$ $\tfrac{7}{2}$ $\tfrac{161}{36}$ $\tfrac{287}{36}$ $\tfrac{287}{36}$
$D$ $\tfrac{35}{12}$ $\tfrac{2555}{1296}$ $\tfrac{10115}{1296}$ $\tfrac{6335}{1296}$

此时 $E(XY)-E(X)E(Y)=\tfrac{35}{24}$。结论:$E(X+Y)=E(X)+E(Y)$ 成立;$D(X+Y)>D(X)+D(Y)$,方差不可直接相加。

期望总能相加,方差不一定

四种情形中,$E(X+Y)=E(X)+E(Y)$ 始终成立;$D(X+Y)$ 与 $D(X)+D(Y)$ 的差,恰好由 $E(XY)-E(X)E(Y)$ 的符号和大小决定。

  1. 联合分布 $p_{ij}=P(X=x_i,Y=y_j)$,行和 $\sum_j p_{ij}=P(X=x_i)$,列和 $\sum_i p_{ij}=P(Y=y_j)$。

  2. 期望的可加性:

    $$ \begin{aligned} E(X+Y)&=\sum_{i,j}(x_i+y_j)p_{ij}\\ &=\sum_i x_i\sum_j p_{ij}+\sum_j y_j\sum_i p_{ij}\\ &=E(X)+E(Y) \end{aligned} $$

    只用到行和、列和,没有用到 $p_{ij}=p_i\cdot q_j$。所以不需要独立

  3. 方差:

    $$ \begin{aligned} D(X+Y)=\;&D(X)+D(Y)\\ &+2\,\bigl[E(XY)-E(X)E(Y)\bigr] \end{aligned} $$

    由 $D=E(S^2)-E(S)^2$ 展开得到。独立时 $E(XY)=E(X)E(Y)$,方括号为 $0$,方差才可相加

  4. 拆分技巧:若 $X=I_1+I_2+\cdots+I_n$,$I_k$ 为示性变量(事件 $A_k$ 发生取 $1$,否则取 $0$),则

    $$E(X)=P(A_1)+P(A_2)+\cdots+P(A_n)$$

    $E(I_k)=1\cdot P(A_k)+0\cdot\bigl(1-P(A_k)\bigr)$。二项分布、超几何分布的期望都这样推(下两个模块)

例:帽子配对

$n$ 人把帽子混在一起再随机各拿一顶,拿对自己帽子的人数为 $X$。$I_k$ 表示第 $k$ 人拿对,$P(A_k)=\frac1n$,所以 $E(X)=n\cdot\frac1n=1$。各 $I_k$ 并不独立,结论照样成立。

模拟:样本均值逼近期望

按第 1 步的分布列反复抽样

按均匀骰子的分布列反复抽样,下图是抽样 1000 次的一次记录。

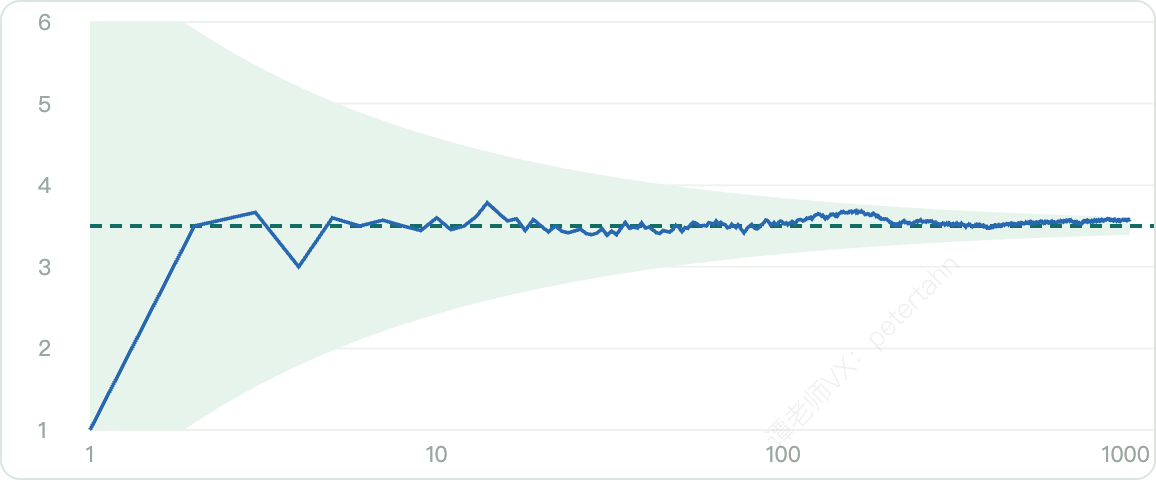
样本均值随抽样次数 n 的变化(横轴为 n,对数刻度;纵轴为取值范围 1\sim6):蓝色折线是样本均值 \bar x;绿色虚线是 E(X)=3.5;浅绿色带是 E(X)\pm2\sigma/\sqrt n。样本均值起初摆动很大,随 n 增大逐渐收窄并稳定在 E(X) 附近
图 10样本均值随抽样次数 $n$ 的变化(横轴为 $n$,对数刻度;纵轴为取值范围 $1\sim6$):蓝色折线是样本均值 $\bar x$;绿色虚线是 $E(X)=3.5$;浅绿色带是 $E(X)\pm2\sigma/\sqrt n$。样本均值起初摆动很大,随 $n$ 增大逐渐收窄并稳定在 $E(X)$ 附近
1000 次抽样中各点数的频率(蓝)与概率(绿)对比:各柱的蓝绿高度非常接近,说明频率稳定于概率
图 111000 次抽样中各点数的频率(蓝)与概率(绿)对比:各柱的蓝绿高度非常接近,说明频率稳定于概率

频率 → 概率,样本均值 → 期望

这次 1000 次抽样的记录:

抽样次数 $n$ 样本均值 $\bar x$ $E(X)$ 样本方差 $D(X)$
$1000$ $3.582$ $3.5$ $3.0093$ $2.9167$
  1. 样本均值 $\bar x=\dfrac{\sum x_i\cdot n_i}{n}=\sum x_i\cdot\dfrac{n_i}{n}$,其中 $n_i$ 是取到 $x_i$ 的次数。

    样本均值就是用频率 $\dfrac{n_i}{n}$ 加权

  2. $n$ 越大,频率 $\dfrac{n_i}{n}$ 越稳定在 $p_i$ 附近,所以 $\bar x$ 稳定在 $\sum x_ip_i=E(X)$ 附近。

  3. 波动幅度:$D(\bar X)=\dfrac{D(X)}{n}$,标准差 $\dfrac{\sigma}{\sqrt n}$。

    由 $D(X_1+\cdots+X_n)=nD(X)$(各次独立)与 $D\!\left(\dfrac Xn\right)=\dfrac D{n^2}$。抽样次数变为 4 倍,误差只减半

注意

期望是“长期平均”,不是“最可能的值”。比如第 1 步的“两端”分布,$E(X)=3$,但 $X$ 从不取 $3$。

例题精讲

高斯取整与条件概率

例 12024 济南三月模拟

抛掷甲、乙两枚质地均匀的骰子,所得点数分别为 $a,b$,记 $X=\left[\dfrac ba\right]$($[x]$ 表示不超过 $x$ 的最大整数)。

(1)求在 $X>0$ 的条件下,$X=\dfrac ba$ 的概率;

(2)求 $X$ 的分布列及数学期望。

建模思路

古典概型下的条件概率 = 在“新世界” $A$ 里数格子。把 36 个结果画成 $6\times6$ 方格,两个条件都变成方格里的区域。

解析

(1)在 $X>0$ 的条件下,$X=\dfrac ba$ 的概率

  1. 设 $A=\{X>0\}$,$B=\left\{X=\dfrac ba\right\}$。样本空间 $n(\Omega)=36$。

  2. $X>0\iff\left[\dfrac ba\right]\ge1\iff \dfrac ba\ge1\iff b\ge a$。

    取整后 $\ge1$ 等价于原数 $\ge1$

  3. $n(A)$:对角线及其上方,$6+5+4+3+2+1=21$。

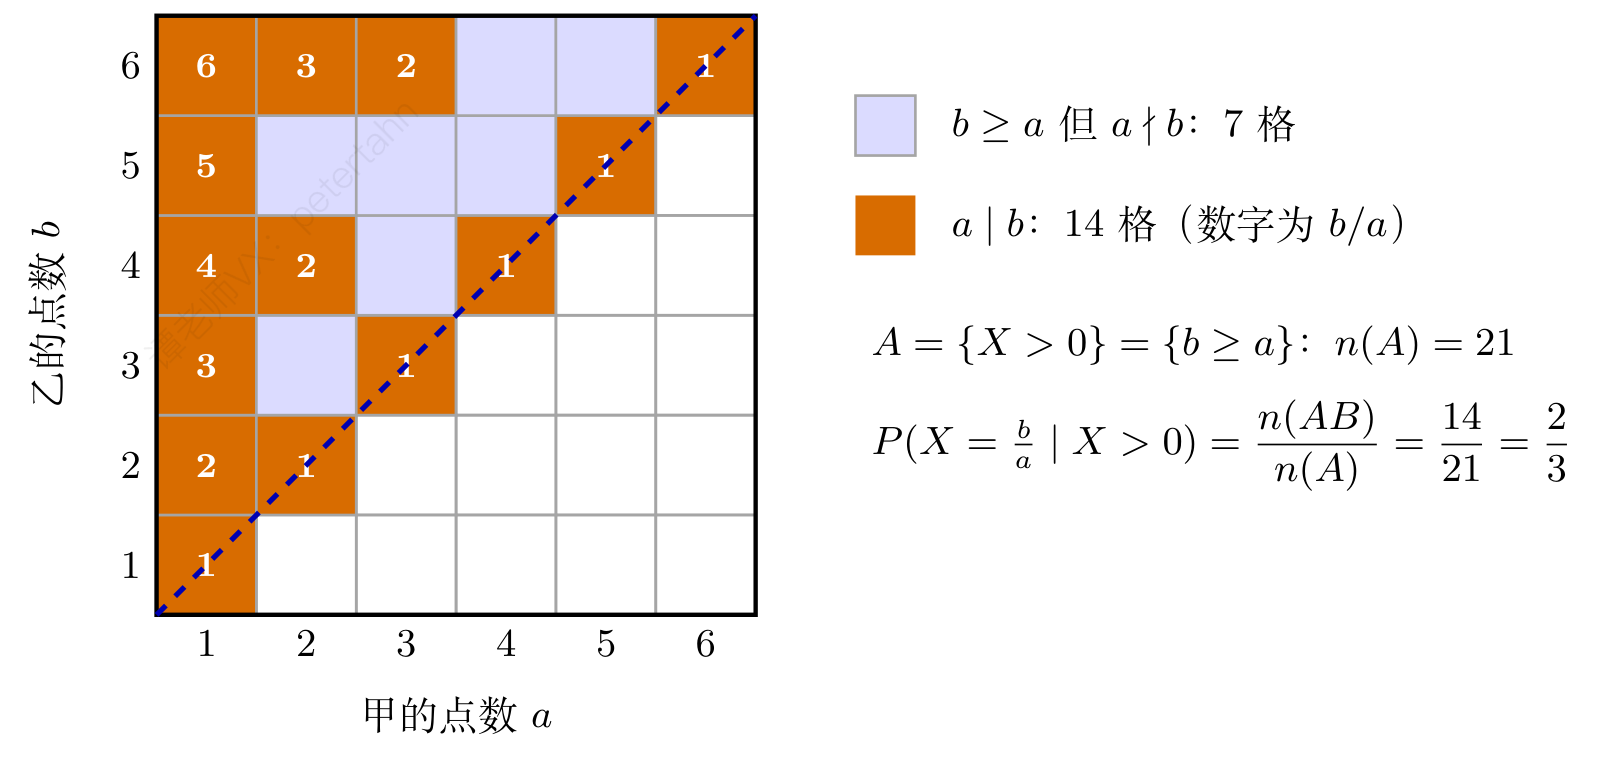
  4. $AB$:$\left[\dfrac ba\right]=\dfrac ba$ 即 $\dfrac ba$ 为正整数,即 $a\mid b$:$a=1$ 有 6 个,$a=2$ 有 $\{2,4,6\}$ 3 个,$a=3$ 有 $\{3,6\}$ 2 个,$a=4,5,6$ 各 1 个,$n(AB)=14$。

    6\times6 方格(横轴甲的点数 a,纵轴乙的点数 b),蓝色虚线是对角线 b=a。橙色 14 格满足 a\mid b,即 AB,格中数字为 \frac ba;浅紫 7 格满足 b\ge a 但 a\nmid b。橙色与浅紫合起来 21 格就是新世界 A,故 P(B\mid A)=\frac{14}{21}=\frac23
    图 12$6\times6$ 方格(横轴甲的点数 $a$,纵轴乙的点数 $b$),蓝色虚线是对角线 $b=a$。橙色 14 格满足 $a\mid b$,即 $AB$,格中数字为 $\frac ba$;浅紫 7 格满足 $b\ge a$ 但 $a\nmid b$。橙色与浅紫合起来 21 格就是新世界 $A$,故 $P(B\mid A)=\frac{14}{21}=\frac23$
  5. 由古典概型,

    $$P(B\mid A)=\frac{n(AB)}{n(A)}=\frac{14}{21}=\frac23$$

    分母是 21 而不是 36——这就是“缩小样本空间”

答案:$\dfrac23$

(2)$X$ 的分布列与期望

  1. $\dfrac16\le\dfrac ba\le6$,所以 $X\in\{0,1,2,3,4,5,6\}$。上图中橙色格的数字正是 $X$ 的部分取值。

  2. $X=0\iff b<a$:$15$ 个;$X=2$:$(1,2),(2,4),(2,5),(3,6)$ 共 4 个;$X=3$:$(1,3),(2,6)$;$X=4,5,6$ 各 1 个($a=1$)。

    先数容易的取值

  3. $X=1$ 用补数:$36-(15+4+2+1+1+1)=12$。

    避免枚举 $X=1$ 时漏数

  4. 分布列:

    $X$ 0 1 2 3 4 5 6
    $P$ $\frac{15}{36}$ $\frac{12}{36}$ $\frac{4}{36}$ $\frac{2}{36}$ $\frac1{36}$ $\frac1{36}$ $\frac1{36}$
  5. 期望:

    $$E(X)=\frac{0\cdot15+1\cdot12+2\cdot4+3\cdot2+4+5+6}{36}=\frac{41}{36}$$

答案:$E(X)=\dfrac{41}{36}$

易错

$X>0$ 不是 $b>a$,而是 $b\ge a$($b=a$ 时 $X=1$)。

不放回摸到最后一个黑球

例 22023 武汉二月调研

口袋 7 球,4 黑。不放回逐个抽取,直到 4 个黑球全部取出为止。

(1)总抽取次数为 $X$,求 $E(X)$;

(2)改为甲袋 3 球(2 黑)、乙袋 4 球(2 黑),先在甲袋中取到 2 黑全出,再在乙袋中取到 2 黑全出。总次数为 $Y$,求 $E(Y)$ 并解释与 $E(X)$ 的大小关系。

建模思路

不放回取完 = 一个随机排列。设共有 $N$ 个球、其中 $m$ 个黑球,则 $X=k$ 等价于“第 $k$ 位是黑,前 $k-1$ 位恰有 $m-1$ 个黑”,所以 $P(X=k)=\dfrac{\mathrm{C}_{k-1}^{m-1}}{\mathrm{C}_N^m}$。

解析

(1)$E(X)$

  1. $X\in\{4,5,6,7\}$,$n(\Omega)=\mathrm{C}_7^4=35$(黑球占哪 4 个位置)。
  2. $P(X=k)=\dfrac{\mathrm{C}_{k-1}^3}{35}$:$\dfrac1{35},\dfrac4{35},\dfrac{10}{35},\dfrac{20}{35}$。
  3. $E(X)=\dfrac{4+20+60+140}{35}=\dfrac{224}{35}=\dfrac{32}5$。

答案:$\dfrac{32}5$

(2)$E(Y)$ 与解释

  1. $Y=Y_1+Y_2$。甲袋 $N=3,m=2$:$P(Y_1=2)=\tfrac13,\ P(Y_1=3)=\tfrac23$,$E(Y_1)=\tfrac83$。
  2. 乙袋 $N=4,m=2$:$P(Y_2=k)=\dfrac{\mathrm{C}_{k-1}^1}{\mathrm{C}_4^2}=\tfrac16,\tfrac26,\tfrac36$($k=2,3,4$),$E(Y_2)=\tfrac{10}3$。
  3. $E(Y)=E(Y_1)+E(Y_2)=6$。

    期望的线性性:不必先求 $Y$ 的分布列

  4. $E(Y)=6<\tfrac{32}5=E(X)$。解释:分袋后,甲袋的白球不会混进乙袋的抽取过程;甲袋黑球取完就转到乙袋,相当于提前排除了一部分白球的干扰。

答案:$E(Y)=6<E(X)$

易错

把 $P(X=k)$ 的分子写成 $\mathrm{C}_k^4$:忘了第 $k$ 次必须是黑球。

连中翻倍的摸奖得分

例 32024 江西八所重点中学四月联考

选手连续摸奖:首次中奖得 1 分;若连续中奖,下一次中奖的得分是上一次得分的两倍;某次未中奖则该次得 0 分,且下一次中奖重新从 1 分算。某同学连续摸奖 $n$ 次,总得分为 $X$,每次中奖概率为 $\dfrac13$,各次相互独立。

(1)当 $n=5$ 时,求 $X=3$ 的概率;

(2)当 $n=3$ 时,求 $X$ 的分布列和数学期望;

(3)当 $n=30$ 时,判断 $E(X)$ 与 10 的大小,并说明理由。

建模思路

得分取决于“中奖序列”。前两问枚举序列;第 3 问不必求分布列,用期望的线性性与单调性:把总分和“中奖次数”比较。

解析

(1)$n=5$ 时,$P(X=3)$

  1. 3 分的组成只有两种:$1+2$(恰好一段“连中两次”,其余不中),或 $1+1+1$(三次中奖互不相邻)。

    连中三次得 $1+2+4=7$,超过 3;单独一次中奖只得 1 分

  2. 情形一:2 次中奖相邻、3 次不中。把“中中”捆成一块,插入 3 个“不中”形成的 4 个空位之一:4 种序列,每种概率 $\left(\tfrac13\right)^2\left(\tfrac23\right)^3$:

    $$4\times\frac19\times\frac8{27}=\frac{32}{243}$$

  3. 情形二:3 次中奖互不相邻、2 次不中。2 个“不中”形成 3 个空位,3 次中奖各占一个:只有 1 种(中不中不中中),概率

    $$\left(\tfrac13\right)^3\left(\tfrac23\right)^2=\frac4{243}$$

    5 个位置放 3 个互不相邻的“中”,只能是第 1、3、5 次

  4. 两种情形互斥:

    $$P(X=3)=\frac{32}{243}+\frac4{243}=\frac{36}{243}=\frac4{27}$$

答案:$\dfrac4{27}$

(2)$n=3$ 时的分布列与期望

  1. 用 1 表示中奖。8 种序列的得分:$000\to0$;$100,010,001\to1$;$101\to1+1=2$;$110,011\to1+2=3$;$111\to1+2+4=7$。所以 $X\in\{0,1,2,3,7\}$。

  2. 每个序列的概率 $=\left(\tfrac13\right)^{\text{中奖次数}}\left(\tfrac23\right)^{\text{未中次数}}$:

    $X$ 0 1 2 3 7
    $P$ $\frac8{27}$ $\frac{12}{27}$ $\frac2{27}$ $\frac4{27}$ $\frac1{27}$

    检查:$8+12+2+4+1=27$,概率和为 1

  3. 期望:

    $$E(X)=\frac{0\cdot8+1\cdot12+2\cdot2+3\cdot4+7\cdot1}{27}=\frac{35}{27}$$

答案:$E(X)=\dfrac{35}{27}$

(3)$n=30$ 时,$E(X)$ 与 10 的大小

  1. 设 $\xi$ 为 30 次中的中奖次数,则 $\xi\sim B\left(30,\tfrac13\right)$,$E(\xi)=30\times\tfrac13=10$。

  2. 每次中奖至少得 1 分,所以对每一个结果都有 $X\ge\xi$;当出现连续中奖时得分为 $2,4,\dots$ 严格大于 1,此时 $X>\xi$。

    逐个样本点比较:$X$ 和 $\xi$ 是同一次试验的两个函数

  3. $Y=X-\xi\ge0$,且 $P(Y>0)\ge P(\text{前两次都中})=\tfrac19>0$,所以 $E(Y)>0$。由线性性 $E(X)=E(\xi)+E(Y)>10$。

    非负随机变量取正值的概率大于 0,期望就大于 0

  4. 精确值(线性性):记 $Y_i$ 为第 $i$ 次的得分,$X=Y_1+\cdots+Y_{30}$。第 $i$ 次得 $2^{j-1}$ 分 $\iff$ 第 $i$ 次所在的连中段恰好长 $j$,可算出

    $$E(Y_i)=\frac23-\frac12\left(\frac23\right)^i$$

    于是

    $$E(X)=\sum_{i=1}^{n}E(Y_i)=\frac{2n}3-1+\left(\frac23\right)^n$$

    $n=3$ 时为 $\frac{35}{27}$(与第 2 问一致),$n=30$ 时 $\approx19.000005$。

    各次得分并不独立,但期望的线性性不需要独立。这一步属于拓展

答案:$E(X)>10$(精确值约 $19.000005$)

易错

第 1 问漏掉“三次互不相邻中奖”($1+1+1$)。第 3 问不要把“$X\ge\xi$”写成“$E(X)\ge10$”就结束,要说明严格大于。

细胞分裂的数量分布

例 42023 山东泰安肥城适应性训练(一)

一种细胞每个周期 $T$ 分裂一次,一个细胞分裂成 1 个新细胞的概率为 $p$,分裂成 2 个的概率为 $1-p$,原细胞消失,各细胞相互独立。从 1 个细胞开始,$p\in\left(\tfrac12,1\right)$。

(1)$2T$ 结束后细胞数为 $\xi$,求 $\xi$ 的分布列和数学期望;

(2)记 $nT$ 结束后细胞数为 $m$ 的概率为 $P_m(n)$。(i)求 $P_2(n)$;(ii)证明 $P_3(n)<\dfrac{8}{27p^2}$。

建模思路

第 1 问按第一个周期的结果分两支画树。第 2 问抓“第几个周期由 1 个变成 2 个”这一分界点分类。

解析

(1)$\xi$ 的分布列与期望

  1. 第一周期:以 $p$ 得 1 个,以 $1-p$ 得 2 个。第二周期再对每个细胞独立分裂,所以 $\xi\in\{1,2,3,4\}$。

  2. $\xi=1$:$1\to1\to1$,$P=p^2$。

    $\xi=2$:$1\to1\to2$ 概率 $p(1-p)$;或 $1\to2$ 后两个都分裂成 1,概率 $(1-p)p^2$。合计 $p-p^3$。

    $p(1-p)+(1-p)p^2=p(1-p)(1+p)=p-p^3$

  3. $\xi=3$:$1\to2$,两个细胞恰有一个分裂成 2:$(1-p)\cdot\mathrm{C}_2^1p(1-p)=2p(1-p)^2$。

    $\xi=4$:$1\to2$,两个都分裂成 2:$(1-p)^3$。

  4. 分布列:

    $\xi$ 1 2 3 4
    $P$ $p^2$ $p-p^3$ $2p(1-p)^2$ $(1-p)^3$

    检查:四项相加恰为 1

  5. 期望:

    $$E(\xi)=p^2+2(p-p^3)+6p(1-p)^2+4(1-p)^3=p^2-4p+4=(2-p)^2$$

    一个细胞平均产生 $1\cdot p+2(1-p)=2-p$ 个;两代之后平均 $(2-p)^2$ 个,是一个好的验算

答案:$E(\xi)=(2-p)^2$

(2)(i)求 $P_2(n)$

  1. $nT$ 后有 2 个 $\iff$ 存在唯一的 $k\ (1\le k\le n)$:前 $k-1$ 个周期都是 $1\to1$,第 $k$ 个周期 $1\to2$,之后 $n-k$ 个周期两个细胞每次都 $1\to1$。

  2. 该情形概率 $p^{k-1}(1-p)\cdot(p^2)^{n-k}$,对 $k$ 求和(互斥):

    $$P_2(n)=(1-p)\sum_{k=1}^{n}p^{2n-k-1}=(1-p)\left(p^{n-1}+p^n+\cdots+p^{2n-2}\right)$$

  3. 等比数列求和:

    $$P_2(n)=(1-p)\cdot\frac{p^{n-1}(1-p^n)}{1-p}=p^{n-1}(1-p^n)$$

    $n=1$:$P_2(1)=1-p$,正确

答案:$P_2(n)=p^{n-1}(1-p^n)$

(2)(ii)证明 $P_3(n)<\dfrac{8}{27p^2}$

  1. $n=1$ 时 $P_3(1)=0$,显然成立。设 $n\ge2$。

  2. 设第 $k\ (1\le k\le n-1)$ 个周期首次 $1\to2$。之后两个细胞中一个始终是 1 个($p^{n-k}$),另一个经 $n-k$ 个周期变成 2 个($P_2(n-k)$),选哪一个有 2 种:

    $$P_3(n)=\sum_{k=1}^{n-1}p^{k-1}(1-p)\cdot2p^{n-k}\cdot p^{n-k-1}\left(1-p^{n-k}\right)$$

  3. 整理并对两个等比数列求和,化简得

    $$P_3(n)=\frac{2p^{n-1}\left(1-p^{n-1}\right)\left(1-p^n\right)}{1+p}$$

    原解析写作 $\dfrac{2p^n(p-p^n)(1-p^n)}{(1+p)p^2}$,与此式相同;已用分支过程逐项枚举验证

  4. 令 $x=p^n\in(0,p)$,则 $p^{n-1}(1-p^{n-1})=\dfrac{x(p-x)}{p^2}$:

    $$P_3(n)=\frac{2x(p-x)(1-x)}{(1+p)p^2}<\frac{2x(1-x)^2}{(1+p)p^2}$$

    $p<1$,所以 $p-x<1-x$

  5. $f(x)=x(1-x)^2$,$f'(x)=(1-x)(1-3x)$,在 $(0,1)$ 上最大值 $f\left(\tfrac13\right)=\tfrac4{27}$。所以

    $$P_3(n)<\frac{8}{27(1+p)p^2}<\frac{8}{27p^2}$$

答案:证毕

易错

$\xi=2$ 漏掉“先分成 2 个、再各自分成 1 个”这一支。求 $P_2(n)$ 时公比是 $\frac1p$ 还是 $p$ 要看清:按上面写法从 $p^{n-1}$ 到 $p^{2n-2}$,公比为 $p$。

课堂小测

课堂小测

已知 $E(X)=2$,$D(X)=3$,则 $E(2X-1)$ 与 $D(2X-1)$ 分别为

查看答案与解析

答案B

解析

$E=2\cdot2-1=3$,$D=2^2\cdot3=12$。

辨析
  • A:$D(2X-1)=2^2\cdot3=12$,常数 $-1$ 不影响方差,不要写成 $4\cdot3-1$。C:系数 $a$ 在方差里要平方,$D(2X-1)=4D(X)$,不是 $2D(X)$。D:期望要减去 1,$E(2X-1)=2E(X)-1=3$。
课堂小测

随机变量 $X$、$Y$ 不独立,$E(X)=1$,$E(Y)=2$,则 $E(X+Y)$

查看答案与解析

答案A

解析

期望的线性性对任何 $X$、$Y$ 都成立,推导只用到联合分布的行和、列和。

辨析
  • B:需要独立的是 $D(X+Y)=D(X)+D(Y)$ 与 $E(XY)=E(X)E(Y)$,不是 $E(X+Y)$。C:$E(X+Y)=E(X)+E(Y)$ 是等式,与相关方向无关。D:$E(XY)$ 才可能与 $E(X)E(Y)=2$ 不同;$E(X+Y)$ 恒为 3。
课堂小测

下列说法正确的是

查看答案与解析

答案C

解析

$D(X)=\sum(x_i-\mu)^2p_i=0$ 要求每个 $p_i>0$ 的 $x_i$ 都等于 $\mu$。

辨析
  • A:$E(X^2)-[E(X)]^2=D(X)\ge0$,一般 $E(X^2)\ge[E(X)]^2$,等号仅当 $X$ 为常数。B:当 $Y=X$ 时(见“线性性”一节),$D(2X)=4D(X)\ne2D(X)$,方差相加需要独立。D:反例是“两端”分布,$E(X)=3$,但 $X$ 只取 1 和 5,$P(X=3)=0$。
专题 06

伯努利与二项分布:$n$ 次独立重复试验里成功几次

每次只有“成功 / 失败”,成功概率都是 $p$,各次互不影响。成功次数 $X$ 的分布由 $n$、$p$ 两个数完全决定。

看见:$n$、$p$ 怎样塑造分布

$X\sim B(n,p)$ 的分布列

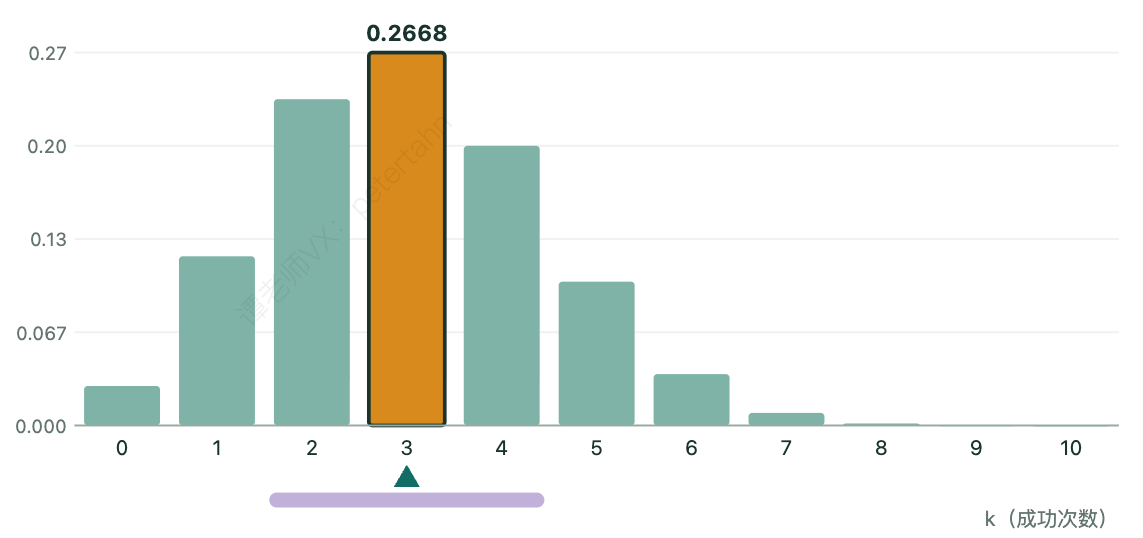
n=10,\ p=0.3 时 X\sim B(n,p) 的分布列:横轴为成功次数 k,柱高为 P(X=k)。橙色柱是最可能的取值(众数 k=3),柱顶标出 P(X=3)\approx0.2668;柱下的绿色三角标出期望 E(X)=np=3,紫色带表示 np\pm\sigma 的范围,分布大部分落在带内
图 1$n=10,\ p=0.3$ 时 $X\sim B(n,p)$ 的分布列:横轴为成功次数 $k$,柱高为 $P(X=k)$。橙色柱是最可能的取值(众数 $k=3$),柱顶标出 $P(X=3)\approx0.2668$;柱下的绿色三角标出期望 $E(X)=np=3$,紫色带表示 $np\pm\sigma$ 的范围,分布大部分落在带内

读数(以 $n=10,\ p=0.3$ 为例)

  • $E(X)=np=3$
  • $D(X)=np(1-p)=2.1$
  • 众数:$3$
  • $P(X=\text{众数})=0.2668$

$$ \begin{aligned} P(X=3)&=\mathrm{C}_{10}^{3}\,0.3^{3}\,(0.7)^{7}\\ &=120\times0.027\times0.082354\approx0.2668 \end{aligned} $$

$$P(X\le 3)\approx0.6496,\qquad P(X\ge 3)\approx0.6172$$

思路

$p=0.5$ 时分布左右对称;$p$ 偏小时“挤在左边、拖向右边”;固定 $p$ 增大 $n$,图形越来越像一口钟,这是下一模块“正态分布”的伏笔。

识别二项分布的三个条件

① 每次只有两个结果;② 每次成功概率都是 $p$;③ 各次相互独立。“不放回抽取”违反 ②③,要用超几何分布。

推导:$P(X=k)$ 与 $E$、$D$

从独立重复试验推出公式

  1. 伯努利试验:一次试验只有成功(概率 $p$)与失败(概率 $q=1-p$)。重复 $n$ 次,各次相互独立,$X$ 为成功次数。

  2. 一条具体的结果序列,例如“前 $k$ 次成功、后 $n-k$ 次失败”:

    $$P(\underbrace{\text{成}\cdots\text{成}}_{k}\underbrace{\text{败}\cdots\text{败}}_{n-k})=p^k q^{n-k}$$

    相互独立 $\Rightarrow$ 积事件的概率 = 各概率之积(独立性模块)

  3. 任何一条恰有 $k$ 次成功的序列,概率都是 $p^kq^{n-k}$——只与成功个数有关,与位置无关。

    乘法交换律:同样 $k$ 个 $p$、$n-k$ 个 $q$

  4. 数序列条数:从 $n$ 个位置中选 $k$ 个放“成功”,共 $\mathrm{C}_n^k$ 条,彼此互斥:

    $$P(X=k)=\mathrm{C}_n^k\,p^k(1-p)^{n-k},\quad k=0,1,\dots,n$$

    下图:每一列是同一个 $k$ 的所有序列,条数 = 组合数

  5. 概率和为 1:

    $$\sum_{k=0}^{n}\mathrm{C}_n^kp^kq^{n-k}=(p+q)^n=1$$

    二项式定理——“二项分布”的名字由此而来

  6. 拆成示性变量:$I_i=1$ 表示第 $i$ 次成功,否则 $I_i=0$,则

    $$X=I_1+I_2+\cdots+I_n$$

  7. 每个 $I_i$ 是两点分布:$E(I_i)=1\cdot p+0\cdot q=p$,$E(I_i^2)=p$,

    $$D(I_i)=p-p^2=p(1-p)$$

  8. 期望:线性性(不需要独立)

    $$E(X)=E(I_1)+\cdots+E(I_n)=np$$

  9. 方差:$I_1,\dots,I_n$ 相互独立,方差可以相加:

    $$D(X)=D(I_1)+\cdots+D(I_n)=np(1-p)$$

    这里用到了独立。对比:超几何分布各次不独立,方差要乘修正因子

把 $2^n$ 条序列按成功次数分列

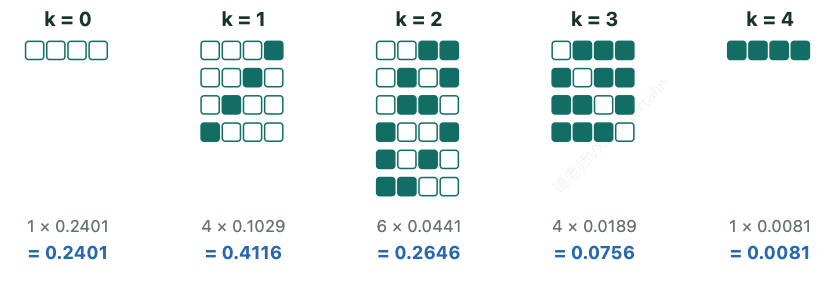
n=4,\ p=0.3 时全部 2^4=16 条结果序列按成功次数 k=0,1,2,3,4 分成五列:实心方块表示成功,空心方块表示失败。每列内的序列概率相同,列底依次给出“条数 × 单条概率 = 该列总概率”:1\times0.2401、4\times0.1029、6\times0.0441、4\times0.0189、1\times0.0081,各列条数恰为组合数 \mathrm{C}_4^k
图 2$n=4,\ p=0.3$ 时全部 $2^4=16$ 条结果序列按成功次数 $k=0,1,2,3,4$ 分成五列:实心方块表示成功,空心方块表示失败。每列内的序列概率相同,列底依次给出“条数 × 单条概率 = 该列总概率”:$1\times0.2401$、$4\times0.1029$、$6\times0.0441$、$4\times0.0189$、$1\times0.0081$,各列条数恰为组合数 $\mathrm{C}_4^k$

$$\sum_{k=0}^{4}\mathrm{C}_{4}^k(0.3)^k(0.7)^{4-k}=(0.3+0.7)^{4}=1$$

$$\text{共 }2^{4}=16\text{ 条序列}$$

模拟:高尔顿板

高尔顿板:每层向右偏的概率为 $p$

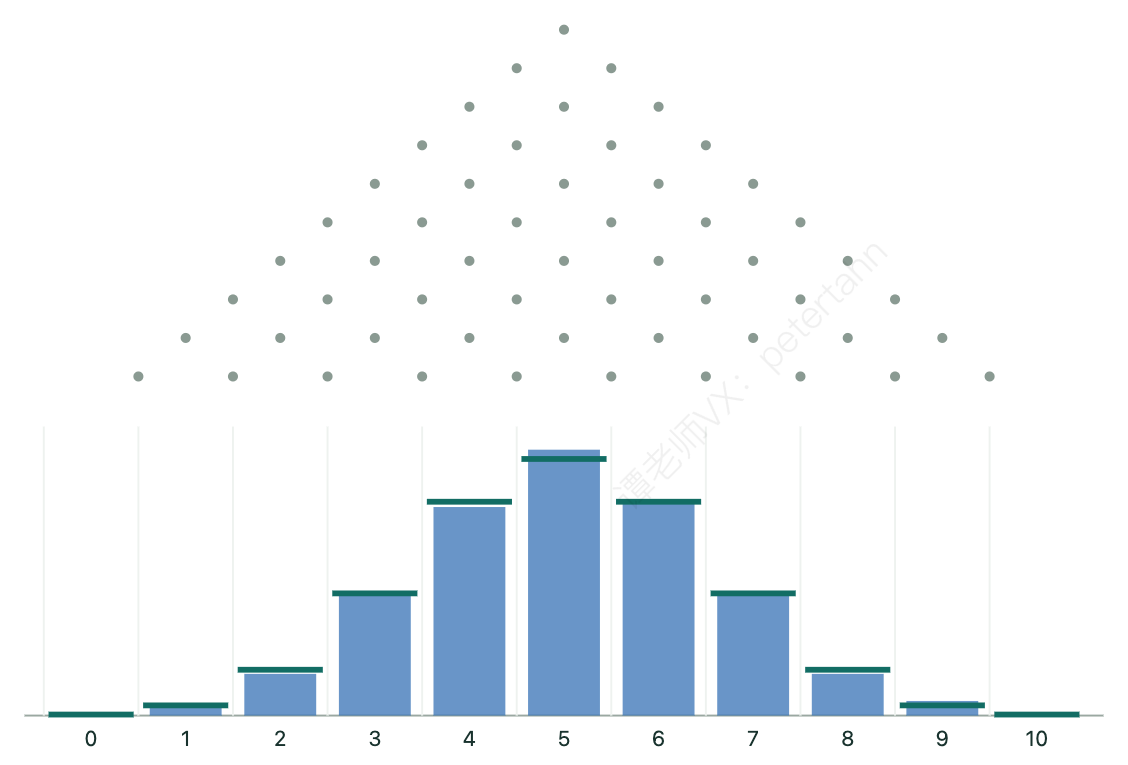
高尔顿板(n=10 层,每层向右概率 p=0.5):上部灰点是钉子,下部 0,1,\dots,10 为落球的格子。蓝色柱是落下 1000 个球后各格的频率,绿色短横线是理论概率 \mathrm{C}_n^kp^k(1-p)^{n-k},两者十分吻合
图 3高尔顿板($n=10$ 层,每层向右概率 $p=0.5$):上部灰点是钉子,下部 $0,1,\dots,10$ 为落球的格子。蓝色柱是落下 1000 个球后各格的频率,绿色短横线是理论概率 $\mathrm{C}_n^kp^k(1-p)^{n-k}$,两者十分吻合

落到第 $k$ 格 $\iff$ 向右 $k$ 次

在这次 1000 个球的模拟中,格号的平均值约为 $5.03$(理论值 $np=5$),格号的方差约为 $2.42$(理论值 $np(1-p)=2.5$)。

  1. 小球每经过一层钉子,独立地以 $p$ 向右、$1-p$ 向左:一层就是一次伯努利试验。
  2. 从左数第 $k$ 格($k=0,\dots,n$)恰好对应“$n$ 层中向右 $k$ 次”,所以格号 $X\sim B(n,p)$。

    向右的先后顺序不影响落点,这就是 $\mathrm{C}_n^k$ 条路径

  3. 柱状图是频率,绿色横线是理论概率 $\mathrm{C}_n^kp^k(1-p)^{n-k}$。球越多,两者越吻合。

探索:最可能的取值

相邻两项之比:先大于 1,后小于 1

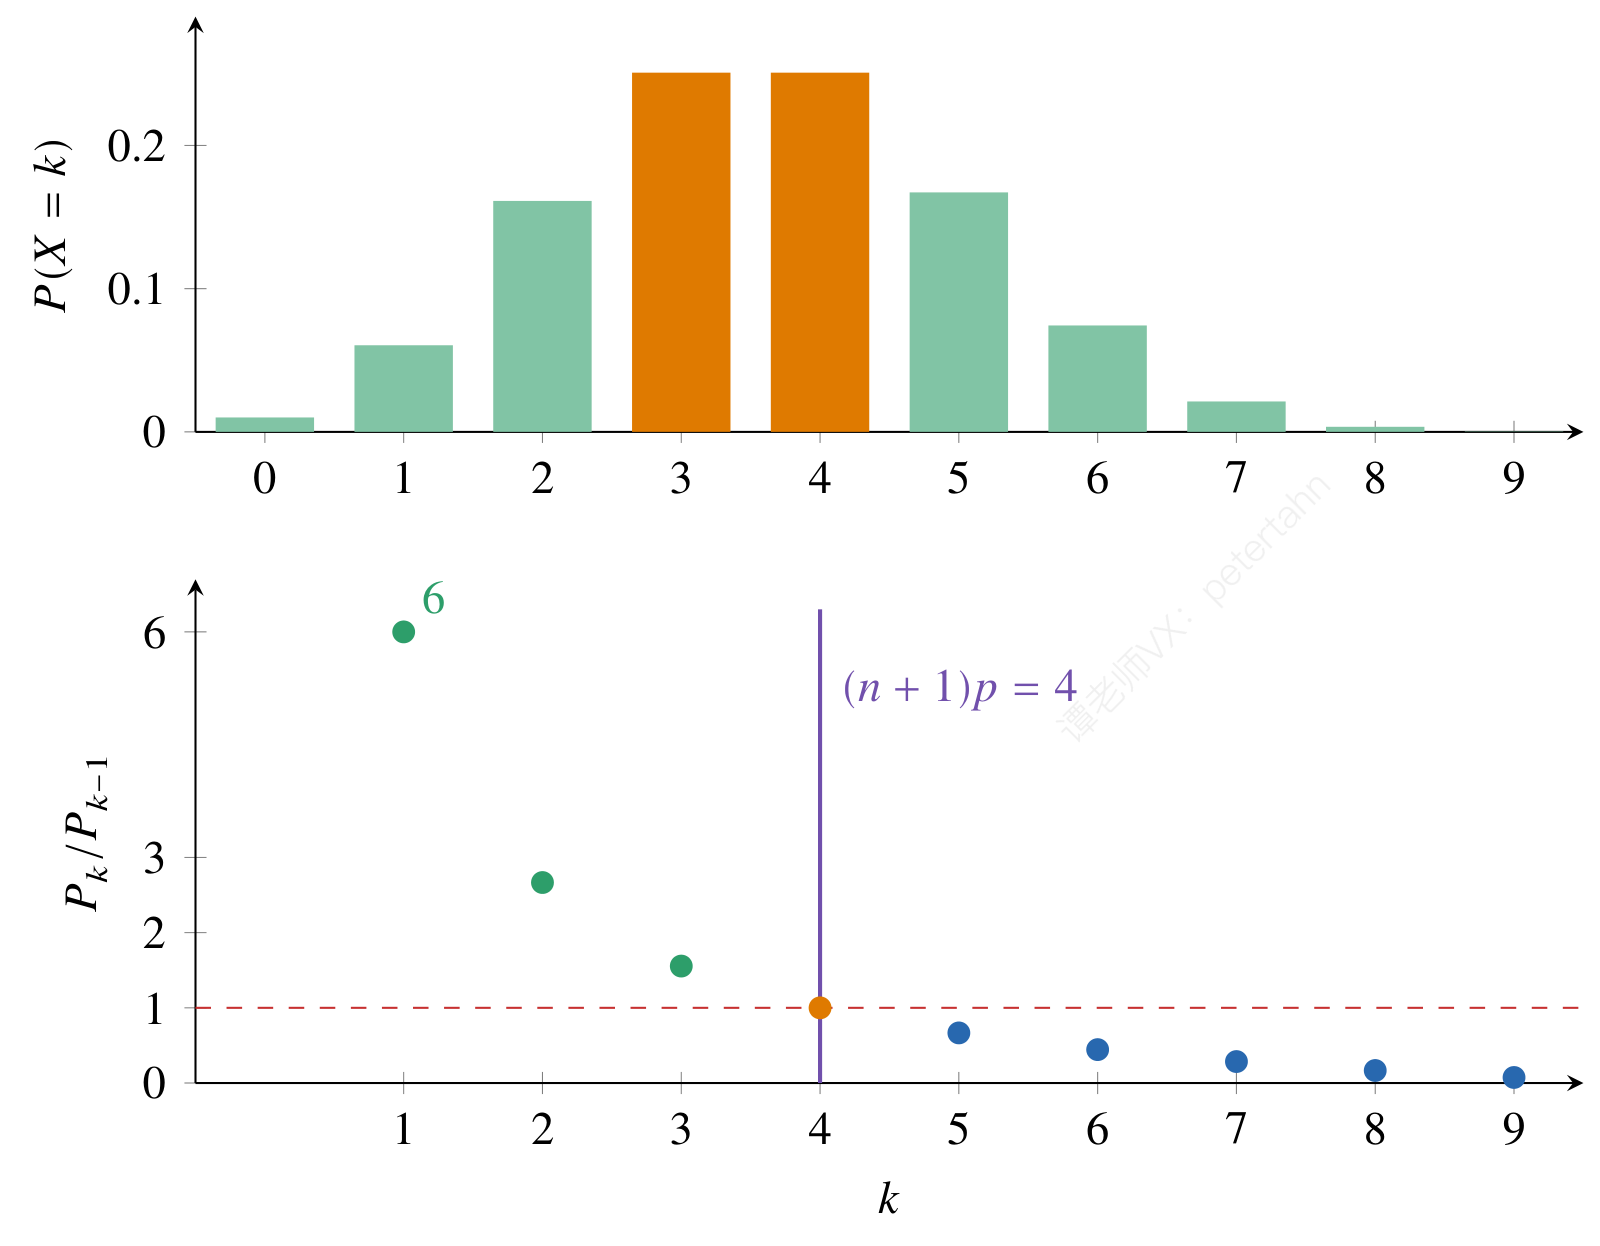
n=9,p=0.4:上图橙柱为众数 k=3,4;下图显示完整比值 P_k/P_{k-1},k=1 时为 6,k=4 时为 1,红虚线标 1,紫线标 (n+1)p=4。
图 4$n=9,p=0.4$:上图橙柱为众数 $k=3,4$;下图显示完整比值 $P_k/P_{k-1}$,$k=1$ 时为 $6$,$k=4$ 时为 $1$,红虚线标 $1$,紫线标 $(n+1)p=4$。

$$(n+1)p=4\ \text{是整数,}P_{3}=P_{4}\approx0.2508\text{,众数为 }3\text{ 和 }4$$

推导众数

  1. 记 $P_k=P(X=k)$,看相邻两项之比($1\le k\le n$):

    $$\frac{P_k}{P_{k-1}}=\frac{\mathrm{C}_n^kp^kq^{n-k}}{\mathrm{C}_n^{k-1}p^{k-1}q^{n-k+1}}=\frac{(n-k+1)\,p}{k\,q}$$

    $\mathrm{C}_n^k/\mathrm{C}_n^{k-1}=(n-k+1)/k$

  2. $$\begin{aligned}\frac{P_k}{P_{k-1}}>1&\iff(n-k+1)p>k(1-p)\\&\iff k<(n+1)p\end{aligned}$$

    展开后 $-kp$ 与 $+kp$ 抵消,只剩 $np+p>k$

  3. 所以 $k<(n+1)p$ 时 $P_k$ 递增,$k>(n+1)p$ 时递减:分布列“先升后降”。

  4. 结论:若 $(n+1)p$ 不是整数,众数为 $\lfloor(n+1)p\rfloor$(唯一);若 $(n+1)p$ 是正整数 $m$,则 $P_{m-1}=P_m$,众数为 $m-1$ 与 $m$ 两个。

    特例:$(n+1)p=n+1$ 不会出现,因为 $p<1$

  5. 众数与期望 $np$ 的关系:$(n+1)p-1<\text{众数}\le(n+1)p$,即众数在 $np-q$ 与 $np+p$ 之间,离期望不到 1。

提示

做题用法:遇到“$P(X=k)$ 最大时 $k$ 为多少”,列不等式组 $P_k\ge P_{k-1}$ 且 $P_k\ge P_{k+1}$,解出 $k$ 的范围再取整数。

例题精讲

随机化回答(全概率反解)

例 12023 深圳一模

袋中 1 黑 2 白,每名员工有放回摸两次。两次颜色不同按方式 I 回答(第一次白画“○”,否则画“×”);否则按方式 II 回答(满意画“○”,否则画“×”)。

(1)某部门 9 人,$X$ 为按方式 I 回答的人数,求 $E(X)$;

(2)所有问卷中“○”与“×”之比为 $4:5$,估计满意度。

建模思路

调查者看不到每个人走的是哪条分支,只看到“○”的总比例。全概率公式把总比例拆成两条路径,其中一条含未知数 $p$——正向用全概率,反向解方程。

解析

(1)$E(X)$

  1. 单人方式 I(两次颜色不同):$P=\tfrac23\cdot\tfrac13+\tfrac13\cdot\tfrac23=\tfrac49$。
  2. 9 人相互独立,$X\sim B\left(9,\tfrac49\right)$,$E(X)=9\times\tfrac49=4$。

答案:$4$

(2)满意度

  1. 设 $A$:方式 I,$\bar A$:方式 II,$C$:画“○”,满意度为 $p=P(C\mid\bar A)$。$P(A)=\tfrac49$,$P(\bar A)=\tfrac59$。

  2. 方式 I 下画“○”= 摸到(白,黑):$P(AC)=\tfrac23\times\tfrac13=\tfrac29$,即 $P(C\mid A)=\tfrac12$。

    不是“$\tfrac12$ 凭感觉”:$AC$ 的实质是摸球结果为(白,黑)

  3. 全概率:

    $$P(C)=P(A)P(C\mid A)+P(\bar A)P(C\mid\bar A)=\tfrac29+\tfrac59p$$

  4. 频率估计 $P(C)=\tfrac{4}{4+5}=\tfrac49$,解 $\tfrac49=\tfrac29+\tfrac59p$ 得 $p=\tfrac25=40\%$。

答案:$40\%$

易错

把“○”占 $\tfrac49$ 直接当成满意度;忘了方式 I 中也有人画“○”。

电子模块(串并联 + 二项比较)

例 22024 温州一模

每个电子模块由 4 个电子元件按图示方式连接,每个元件导通的概率均为 $0.9$,各元件独立。

(1)求每个模块导通的概率 $p$(保留两位有效数字);

(2)某器件由 20 个模块构成,模块彼此独立,当且仅当不低于 50% 的模块导通时器件正常工作。再添加 2 个相同模块,新器件正常工作的概率是增大还是减小?

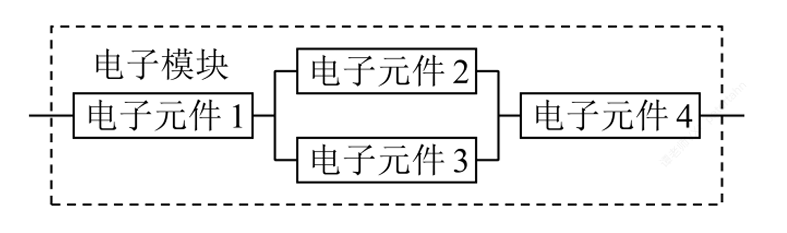
原题电路图:电子元件 1 与由元件 2、3 并联而成的支路串联,再与元件 4 串联,整体构成一个电子模块
图 5原题电路图:电子元件 1 与由元件 2、3 并联而成的支路串联,再与元件 4 串联,整体构成一个电子模块
建模思路

(1) 串联 = 交,并联 = 并,各元件独立 $\to$ 乘法。(2) 不要直接算 22 项求和:以“原来 20 个模块中导通的个数 $X$”为基准,新增 2 个只在 $X=9,10$ 两种临界情形改变结果。

解析

(1)模块导通的概率

  1. 导通 $=E_1\cap(E_2\cup E_3)\cap E_4$。
  2. $P(E_2\cup E_3)=1-0.1^2=0.99$。

    并联用对立:两条都不通才断

  3. $p=0.9\times0.99\times0.9=0.8019\approx0.80$。

    两位有效数字是 $0.80$,不是保留两位小数

答案:$p\approx0.80$

(2)加 2 个模块后正常工作概率的变化

  1. 原器件:$X\sim B(20,p)$,正常 $\iff X\ge10$。新器件 22 个模块,正常 $\iff$ 导通数 $\ge11$。

  2. 以原 20 个的导通数 $X$ 为基准、新增 2 个的导通数为 $Y\sim B(2,p)$(与 $X$ 独立)分类:

    $X$ 新器件正常的条件
    $\ge11$ 一定正常
    $10$ $Y\ge1$,概率 $1-(1-p)^2$
    $9$ $Y=2$,概率 $p^2$
    $\le8$ 不可能
  3. $$\begin{aligned}P_\text{新}&=P(X\ge11)+P(X=10)\big[1-(1-p)^2\big]+P(X=9)\,p^2\\P_\text{旧}&=P(X\ge11)+P(X=10)\\P_\text{新}-P_\text{旧}&=P(X=9)\,p^2-P(X=10)\,(1-p)^2\end{aligned}$$

    $P(X\ge11)$ 两边抵消,只剩临界项

  4. $$\begin{aligned}P_\text{新}-P_\text{旧}&=\mathrm{C}_{20}^9p^{11}(1-p)^{11}-\mathrm{C}_{20}^{10}p^{10}(1-p)^{12}\\&=p^{10}(1-p)^{11}\big[\mathrm{C}_{20}^9p-\mathrm{C}_{20}^{10}(1-p)\big]\end{aligned}$$

  5. $\mathrm{C}_{20}^{10}=\tfrac{11}{10}\mathrm{C}_{20}^9$,代入 $p=0.8$:

    $$\mathrm{C}_{20}^9\Big[0.8-\tfrac{11}{10}\times0.2\Big]=\mathrm{C}_{20}^9\times0.58>0$$

    组合数相邻项之比 $\mathrm{C}_n^{k+1}/\mathrm{C}_n^k=(n-k)/(k+1)$

  6. 所以 $P_\text{新}>P_\text{旧}$,正常工作的概率增大。

    数值验证:原 $\approx0.99944$,新 $\approx0.99965$

答案:增大

易错

第 (2) 问直接写 $\sum_{k=11}^{22}$ 与 $\sum_{k=10}^{20}$ 硬算;或忽略“新增模块与原模块独立”这一前提。

混合零件中来自甲厂的个数

例 32024 深圳二模(节选第 1 问)

甲工厂零件合格率为 $94\%$,乙工厂为 $98\%$,两批零件混合后合格率为 $97\%$。从混合零件中随机抽取 3 个,用频率估计概率,记其中来自甲工厂的个数为 $X$,求 $X$ 的分布列和数学期望。

建模思路

先用全概率公式反求“一个零件来自甲厂”的概率 $p$;“用频率估计概率”意味着每次抽取相互独立、概率都是 $p$,于是 $X\sim B(3,p)$。

解析
  1. 设一个零件来自甲厂的概率为 $x$。全概率公式:

    $$0.94x+0.98(1-x)=0.97\ \Rightarrow\ 0.04x=0.01\ \Rightarrow\ x=\frac14$$

    混合合格率是两厂合格率的加权平均,权重就是各厂占比

  2. 每抽一个零件看作一次伯努利试验(“来自甲厂”为成功),3 次独立、成功概率都是 $\tfrac14$,所以 $X\sim B\left(3,\tfrac14\right)$。

    “用频率估计概率”把从大批量中抽取近似为有放回,这是用二项分布而不是超几何的依据

  3. $P(X=k)=\mathrm{C}_3^k\left(\tfrac14\right)^k\left(\tfrac34\right)^{3-k}$:

    $X$ 0 1 2 3
    $P$ $\frac{27}{64}$ $\frac{27}{64}$ $\frac9{64}$ $\frac1{64}$
  4. $$E(X)=np=3\times\frac14=\frac34$$

    直接用定义也可:$(27+18+3)/64=48/64=3/4$

答案:$X\sim B\left(3,\tfrac14\right)$,$E(X)=\dfrac34$

易错

$X=0$ 与 $X=1$ 概率相等(都是 $\frac{27}{64}$),这正是 $(n+1)p=1$ 为整数时“两个众数”的情形。

二项分布的对称性

例 42023 武汉四月调研

甲、乙各抛一枚均匀硬币。

(1)若两人各抛 3 次,求甲正面次数大于乙正面次数的概率;

(2)若甲抛 $n+1$ 次、乙抛 $n$ 次($n\in\mathbf N^*$),求甲正面次数大于乙正面次数的概率。

建模思路

$p=\tfrac12$ 时 $B(n,\tfrac12)$ 关于 $\tfrac n2$ 对称,甲、乙地位对称:$P(X>Y)=P(X<Y)$。只需算“相等”的概率。

解析

(1)各抛 3 次

  1. $X,Y\sim B\left(3,\tfrac12\right)$ 且相互独立。$P(X=k)=\dfrac{\mathrm{C}_3^k}{8}$。

  2. $$P(X=Y)=\sum_{k=0}^{3}P(X=k)P(Y=k)=\frac{1^2+3^2+3^2+1^2}{64}=\frac{20}{64}=\frac5{16}$$

  3. 甲、乙同分布且独立,交换两人身份,$P(X>Y)=P(X<Y)$。三者之和为 $1$:

    $$P(X>Y)=\frac{1-\frac5{16}}2=\frac{11}{32}$$

    已用 16 种 $(X,Y)$ 组合逐项相加验证

答案:$\dfrac{11}{32}$

(2)甲抛 $n+1$ 次,乙抛 $n$ 次

  1. 把甲拆成“前 $n$ 次”的正面数 $X_n$ 和“第 $n+1$ 次”。$X_n$ 与 $Y$ 同分布 $B\left(n,\tfrac12\right)$,记 $p_1=P(X_n=Y)$,$p_2=P(X_n<Y)$,$p_3=P(X_n>Y)$,由对称性 $p_2=p_3$。

  2. 分类(第 $n+1$ 次与前面独立):

    前 $n$ 次 概率 要甲最终更多
    $X_n=Y$ $p_1$ 第 $n+1$ 次正面,$\tfrac12$
    $X_n<Y$ $p_2$ 不可能(最多追平)
    $X_n>Y$ $p_3$ 一定,$1$

    $X_n<Y$ 意味着 $X_n\le Y-1$,再加 1 也只到 $Y$

  3. $$P=\frac12p_1+p_3=\frac{p_1+p_2+p_3}2=\frac12$$

    用 $p_3=p_2$ 把 $2p_3$ 换成 $p_2+p_3$。结论与 $n$ 无关

答案:$\dfrac12$

易错

对称性要求 $p=\tfrac12$ 且两人试验次数相同。第 2 问次数不同,必须先拆出“多出来的那一次”。

帕斯卡分布(负二项)

例 52023 南京二模

独立重复试验,每次成功概率 $p$。试验进行到恰好出现 $r$ 次成功时结束,$X$ 为试验次数,称 $X\sim NB(r,p)$。

(1)若 $X\sim NB\left(3,\tfrac13\right)$,求 $P(X=5)$;

(2)若 $X\sim NB\left(2,\tfrac12\right)$,$n\ge2$:① 求 $\sum_{i=2}^{n}P(X=i)$;② 要使 $n$ 次内结束试验的概率不小于 $\tfrac34$,求 $n$ 的最小值。

建模思路

“第 $k$ 次恰好是第 $r$ 次成功” = “前 $k-1$ 次恰有 $r-1$ 次成功”(二项分布)且“第 $k$ 次成功”。与二项分布的区别是:最后一次固定。

解析

(1)$P(X=5)$

  1. $X=5$ $\iff$ 前 4 次恰有 2 次成功,且第 5 次成功。两部分独立。
  2. $$P(X=5)=\mathrm{C}_4^2\left(\tfrac13\right)^2\left(\tfrac23\right)^2\cdot\frac13=6\cdot\frac19\cdot\frac49\cdot\frac13=\frac8{81}$$

    不能写成 $\mathrm{C}_5^3\left(\tfrac13\right)^3\left(\tfrac23\right)^2$:那样会把“第 5 次失败”的序列也算进来

答案:$\dfrac8{81}$

(2)① 求和;② $n$ 的最小值

  1. $P(X=i)=\mathrm{C}_{i-1}^1\left(\tfrac12\right)^{i-1}\cdot\tfrac12=\dfrac{i-1}{2^i}$。

  2. 裂项:$\dfrac{i-1}{2^i}=\dfrac{i}{2^{i-1}}-\dfrac{i+1}{2^i}$,累加相消:

    $$\sum_{i=2}^{n}P(X=i)=\frac2{2}-\frac{n+1}{2^n}=1-\frac{n+1}{2^n}$$

    换个看法:$X\le n\iff$ 前 $n$ 次至少 2 次成功,$1-P(0\text{ 次})-P(1\text{ 次})=1-(1+n)/2^n$,二项分布直接得到

  3. ② 要 $1-\dfrac{n+1}{2^n}\ge\dfrac34$,即 $a_n=\dfrac{n+1}{2^n}\le\dfrac14$。

    $$a_{n+1}-a_n=\frac{n+2-2(n+1)}{2^{n+1}}=-\frac{n}{2^{n+1}}<0$$

    所以 $\{a_n\}$ 递减。

  4. $a_4=\dfrac5{16}>\dfrac14$,$a_5=\dfrac6{32}=\dfrac3{16}<\dfrac14$,所以 $n$ 的最小值为 $5$。

答案:① $1-\dfrac{n+1}{2^n}$;② $n_{\min}=5$

易错

第 2 问②只代值不证单调,不能说明“最小”。

课堂小测

课堂小测

$X\sim B(n,p)$,$E(X)=6$,$D(X)=2.4$,则 $n$、$p$ 为

查看答案与解析

答案C

解析

$\dfrac{D}{E}=1-p=0.4$,$p=0.6$,$n=\dfrac{6}{0.6}=10$。

辨析
  • A:$np=6$,但 $np(1-p)=6\times(1-p)=2.4$ 要求 $1-p=0.4$,即 $p=0.6$,不是 $0.4$
  • B:$np(1-p)=12\times0.5\times0.5=3\ne2.4$
  • D:$E=20\times0.3=6$,但 $D=6\times0.7=4.2\ne2.4$。
课堂小测

$X\sim B(10,0.3)$,$P(X=k)$ 最大时 $k=$

查看答案与解析

答案A

解析

$(n+1)p=3.3$ 不是整数,众数为 $\lfloor3.3\rfloor=3$。可验证 $P_3\approx0.267>P_2\approx0.233$、$P_4\approx0.200$。

辨析
  • B:$k$ 必须是整数,$3.3$ 是 $(n+1)p$,不是众数本身
  • C:只有 $(n+1)p$ 为整数时才有两个众数,这里 $3.3$ 不是整数
  • D:$\dfrac{P_4}{P_3}=\dfrac{7\times0.3}{4\times0.7}=0.75<1$,$P_4$ 比 $P_3$ 小。
课堂小测

下列随机变量服从二项分布的是

查看答案与解析

答案C

解析

有放回:每次次品概率都是 $0.3$,且各次独立,$X\sim B(4,0.3)$。

辨析
  • A:不放回,后一次的次品概率依赖前一次结果,各次不独立,是超几何分布
  • B:试验次数不固定,这是几何分布(首次成功所需次数)
  • D:每次成功概率不同,不满足“每次概率都是 $p$”。
专题 07

超几何分布:不放回地抽,抽到几个“红球”

$N$ 个球里有 $K$ 个红球,不放回地取 $n$ 个,红球个数 $X$ 服从超几何分布。和有放回(二项分布)相比,期望相同,方差更小。

看见:与二项分布对比

$X\sim H(N,K,n)$ 与 $B\!\left(n,\frac KN\right)$ 的分布列

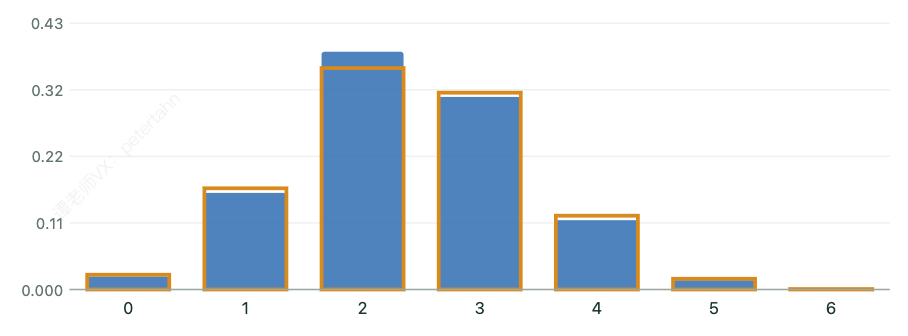
N=20,K=8,n=6:绿色实心柱为超几何分布,橙色空心框为二项分布 B(6,0.4);两者期望相同,不放回时分布更集中。
图 1$N=20,K=8,n=6$:绿色实心柱为超几何分布,橙色空心框为二项分布 $B(6,0.4)$;两者期望相同,不放回时分布更集中。

图中取 $N=20$,$K=8$,$n=6$,两种分布的数字特征如下:

量 公式 数值
期望(两者相同) $E(X)=\dfrac{nK}{N}$ $2.4$
超几何的方差 $D(X)$ $1.0611$
二项的方差 $np(1-p)$ $1.44$
修正因子 $\dfrac{N-n}{N-1}$ $0.7368$

以 $X=2$ 为例:

$$P(X=2)=\frac{\mathrm{C}_{8}^{2}\,\mathrm{C}_{12}^{4}}{\mathrm{C}_{20}^{6}}=\frac{28\times495}{38760}\approx0.3576$$

取值范围:

$$\max\{0,\,6-12\}=0\ \le X\le\ \min\{6,8\}=6$$

思路

不放回时,前面抽到红球越多,袋里红球越少,后面越难再抽到红球:结果被“拉回”中间,所以分布更集中、方差更小。当 $n=N$(全部取出)时,$X$ 只能等于 $K$,方差变成 $0$。

取值范围

$X$ 的取值范围:$\max(0,\,n-(N-K))\le X\le\min(n,K)$。红球不够多时取不到 $n$;白球不够多时至少要抽到几个红球。

推导:P、E、D

用组合计数与示性变量推导

  1. 样本空间:从 $N$ 个球中不放回取 $n$ 个,不计顺序,共 $\mathrm{C}_N^n$ 种,等可能。

    古典概型:每个 $n$ 元子集出现的机会相同

  2. 事件 $X=k$:从 $K$ 个红球中选 $k$ 个,再从 $N-K$ 个白球中选 $n-k$ 个:

    $$P(X=k)=\frac{\mathrm{C}_K^k\,\mathrm{C}_{N-K}^{n-k}}{\mathrm{C}_N^n}$$

    分步乘法计数原理

  3. 概率和为 1:$\sum_k \mathrm{C}_K^k\mathrm{C}_{N-K}^{n-k}=\mathrm{C}_N^n$(范德蒙德恒等式)。

    两边都在数“从 $N$ 个里选 $n$ 个”:左边按其中红球个数 $k$ 分类计数

  4. 示性变量:把 $n$ 个球按抽出的先后排好,$I_i=1$ 表示第 $i$ 个是红球。

    $$X=I_1+I_2+\cdots+I_n$$

  5. 抽签原理:每个位置的球都等可能是 $N$ 个球中的任一个,所以

    $$P(I_i=1)=\frac KN,\qquad E(I_i)=\frac KN$$

    下文“抽签原理”:第 2 次抽到红球的概率用全概率公式算出来也是 $\frac KN$

  6. 期望:线性性不需要独立,

    $$E(X)=n\cdot\frac KN$$

    与有放回的二项分布 $B\!\left(n,\frac KN\right)$ 相同。

  7. 不独立带来的协方差:$i\ne j$ 时 $P(I_i=I_j=1)=\dfrac{K(K-1)}{N(N-1)}$。记 $p=\dfrac KN$,

    $$\operatorname{Cov}(I_i,I_j)=\frac{K(K-1)}{N(N-1)}-p^2=-\frac{p(1-p)}{N-1}<0$$

    抽到一个红球后,下一个是红球的可能变小:负相关

  8. 方差:$n$ 个方差加上 $n(n-1)$ 个协方差:

    $$ \begin{aligned} D(X)&=np(1-p)-n(n-1)\frac{p(1-p)}{N-1}\\ &=np(1-p)\cdot\frac{N-n}{N-1} \end{aligned} $$

    比二项分布多乘一个修正因子 $\dfrac{N-n}{N-1}\le1$

超几何分布 $X\sim H(N,K,n)$

$N$ 个球中有 $K$ 个红球,不放回地取 $n$ 个,红球个数为 $X$:

$$P(X=k)=\frac{\mathrm{C}_K^k\,\mathrm{C}_{N-K}^{n-k}}{\mathrm{C}_N^n},\qquad \max(0,\,n-(N-K))\le k\le\min(n,K)$$

记 $p=\dfrac KN$,则

$$E(X)=np,\qquad D(X)=np(1-p)\cdot\frac{N-n}{N-1}$$

抽签原理:每一次抽到红球的概率都是 $\frac KN$

以第 2 次为例,按第 1 次的结果用全概率公式($N=20$,$K=8$):

$$ \begin{aligned} P(\text{第 2 次红})&=\frac{8}{20}\cdot\frac{7}{19}+\frac{12}{20}\cdot\frac{8}{19}\\ &=\frac{152}{380}=\frac{8}{20} \end{aligned} $$

参数同上(N=20,K=8,n=6),模拟 2000 轮,每轮不放回地抽 6 个。蓝柱是“第 i 次抽到红球”的频率(i=1,\dots,6),橙色框是 \frac KN=0.4。各柱高度都接近 \frac KN,与抽取的先后无关
图 2参数同上($N=20$,$K=8$,$n=6$),模拟 2000 轮,每轮不放回地抽 6 个。蓝柱是“第 $i$ 次抽到红球”的频率($i=1,\dots,6$),橙色框是 $\frac KN=0.4$。各柱高度都接近 $\frac KN$,与抽取的先后无关

模拟:从袋中摸球

袋子里的 $N$ 个球

袋中 $N=20$ 个球,其中红球 $K=8$ 个,每轮不放回地取出 $n=6$ 个,记下其中红球的个数。例如某一轮取出的 6 个球中有 4 个红球。

频率与理论概率

重复摸球 1000 轮,统计结果如下:

量 模拟 理论
红球数平均值 $2.3860$ $\dfrac{nK}{N}=2.4$
红球数方差 $1.0010$ $D(X)=1.0611$
1000 轮摸球中红球个数的频率分布。蓝柱是模拟频率,橙色框是理论概率 P(X=k),k=0,1,\dots,6。两者几乎重合,频率分布贴近超几何分布列
图 31000 轮摸球中红球个数的频率分布。蓝柱是模拟频率,橙色框是理论概率 $P(X=k)$,$k=0,1,\dots,6$。两者几乎重合,频率分布贴近超几何分布列

探索:N 很大时≈二项

固定 $p=\frac KN$ 与 $n$,让 $N$ 变大

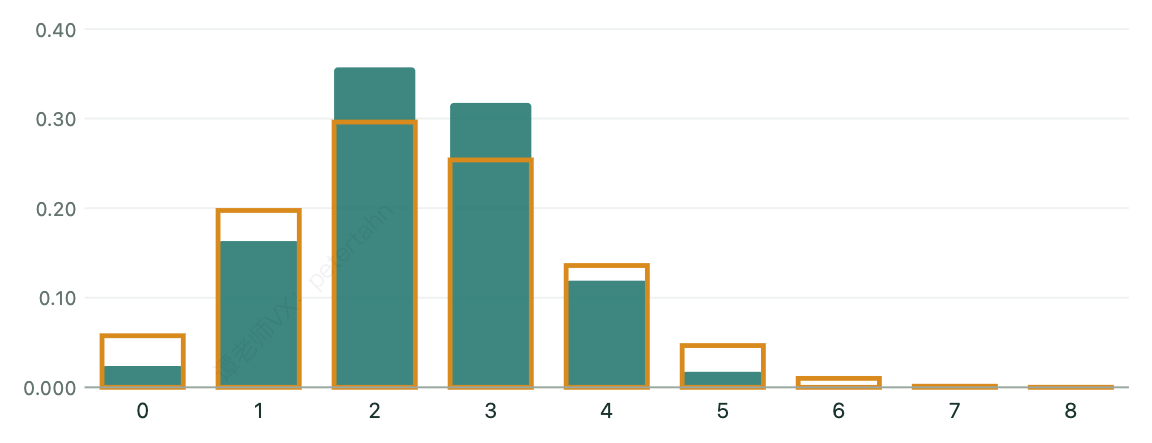
p=0.3,n=8,N=20(K=6)时的分布列。绿色实心柱是超几何分布,橙色空心框是二项分布 B(8,0.3)。此时 \frac nN=0.4,修正因子 \frac{N-n}{N-1}\approx0.6316,两者的最大概率差 \max_k|P_H-P_B|\approx0.0637,差别明显:超几何更集中在 k=2,3,且取不到 7,8
图 4$p=0.3$,$n=8$,$N=20$($K=6$)时的分布列。绿色实心柱是超几何分布,橙色空心框是二项分布 $B(8,0.3)$。此时 $\frac nN=0.4$,修正因子 $\frac{N-n}{N-1}\approx0.6316$,两者的最大概率差 $\max_k|P_H-P_B|\approx0.0637$,差别明显:超几何更集中在 $k=2,3$,且取不到 $7,8$

两种分布的差距随 $N$ 的变化

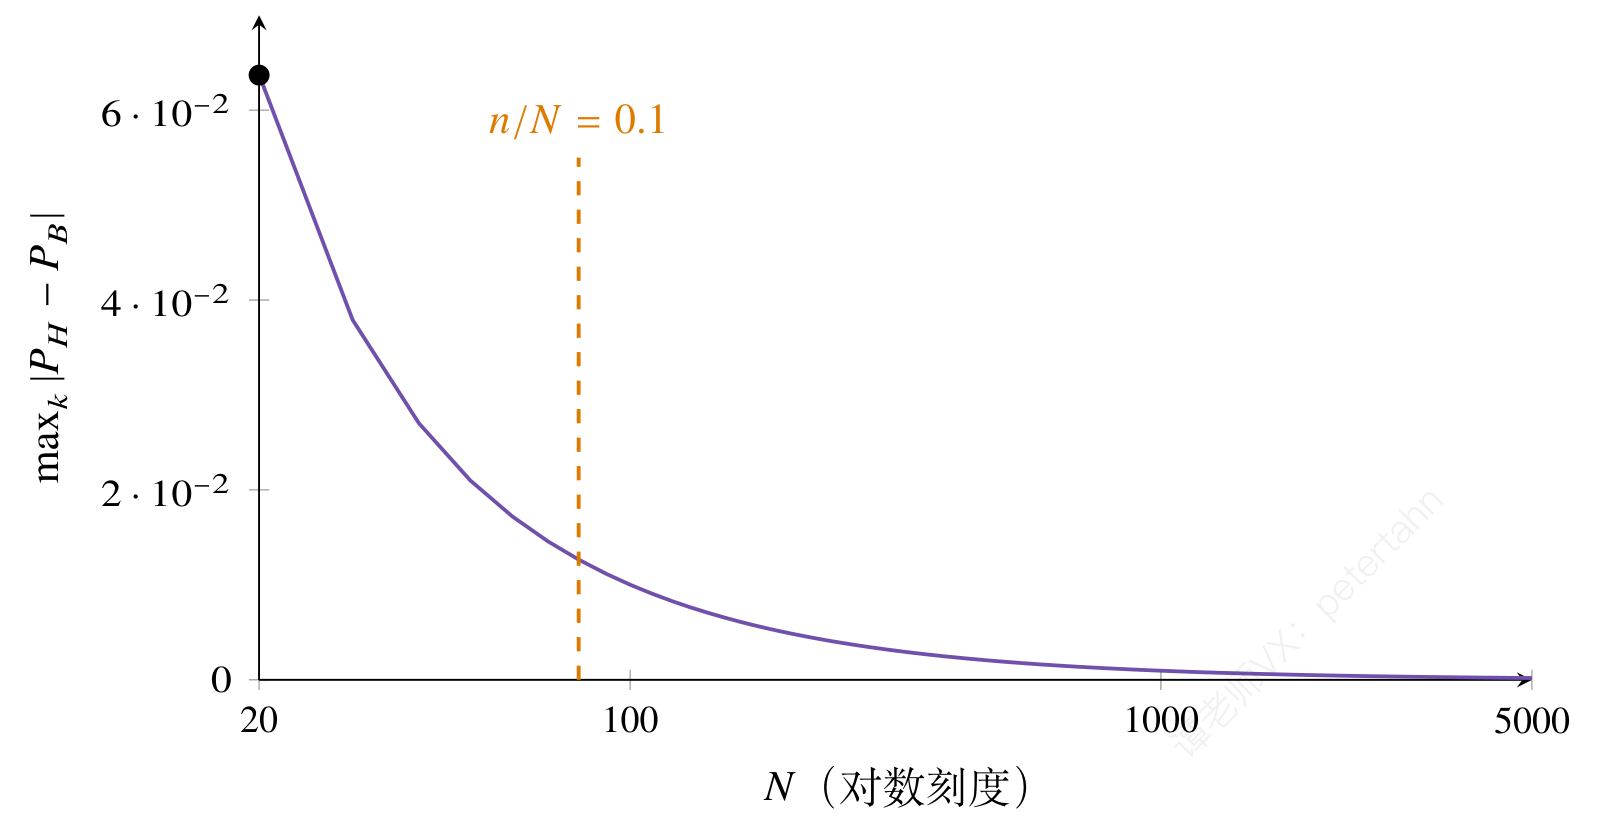
p=0.3、n=8;取 K=0.3N 为整数的 499 个总体规模,最大概率差随 N 增大趋于 0。黑点为 N=20,橙线为 N=80。
图 5$p=0.3$、$n=8$;取 $K=0.3N$ 为整数的 499 个总体规模,最大概率差随 $N$ 增大趋于 0。黑点为 $N=20$,橙线为 $N=80$。
为什么 $N$ 很大时超几何≈二项

把超几何概率改写为

$$ \begin{aligned} \frac{\mathrm{C}_K^k\mathrm{C}_{N-K}^{n-k}}{\mathrm{C}_N^n}=\mathrm{C}_n^k\cdot&\frac{K(K-1)\cdots(K-k+1)}{N(N-1)\cdots(N-k+1)}\\ \cdot&\frac{(N-K)\cdots(N-K-n+k+1)}{(N-k)\cdots(N-n+1)} \end{aligned} $$

固定 $n,k$,令 $N\to\infty$、$\frac KN=p$:分子每个因子约为 $Np$ 或 $N(1-p)$,分母每个因子约为 $N$,所以

$$P(X=k)\to \mathrm{C}_n^kp^k(1-p)^{n-k}$$

实际意义

从一大批产品中抽检少量样品,虽然是不放回,但抽走几件几乎不改变次品率,可以当作二项分布处理。经验上 $\frac nN<0.1$ 时两者已经很接近。

例题精讲

不放回 vs 有放回

例 1原创例题

10 件产品中有 3 件次品。

(1)不放回地任取 4 件,次品数为 $X$,求 $X$ 的分布列、$E(X)$、$D(X)$;

(2)若改为有放回地取 4 次,次品数为 $Y$,求 $E(Y)$、$D(Y)$,并与(1)比较。

建模思路

不放回 → 超几何 $H(N=10,M=3,n=4)$;有放回 → 二项 $B(4,0.3)$。两者期望相同,方差相差一个有限总体修正因子 $\frac{N-n}{N-1}$。

解析

(1)不放回:超几何分布

  1. 从 10 件中取 4 件共 $\mathrm{C}_{10}^4=210$ 种等可能结果。$X=k$ 需从 3 件次品取 $k$ 件、7 件正品取 $4-k$ 件:$P(X=k)=\dfrac{\mathrm{C}_3^k\mathrm{C}_7^{4-k}}{210}$,$k=0,1,2,3$。

  2. 分布列:

    $X$ 0 1 2 3
    $P$ $\frac{35}{210}=\frac16$ $\frac{105}{210}=\frac12$ $\frac{63}{210}=\frac3{10}$ $\frac7{210}=\frac1{30}$

    $35+105+63+7=210$,概率和为 1

  3. $E(X)=0\cdot\tfrac16+1\cdot\tfrac12+2\cdot\tfrac3{10}+3\cdot\tfrac1{30}=\tfrac65$,与公式 $\dfrac{nM}N=\dfrac{4\times3}{10}$ 一致。

  4. $E(X^2)=\tfrac12+4\cdot\tfrac3{10}+9\cdot\tfrac1{30}=2$,

    $$D(X)=E(X^2)-E(X)^2=2-\frac{36}{25}=\frac{14}{25}$$

答案:分布列见上表;$E(X)=\dfrac65$,$D(X)=\dfrac{14}{25}$。

(2)有放回:二项分布,并比较

  1. 有放回时每次抽到次品的概率都是 $0.3$,各次独立,$Y\sim B(4,0.3)$。

  2. $E(Y)=4\times0.3=\tfrac65$,$D(Y)=4\times0.3\times0.7=\tfrac{21}{25}$。

  3. 期望相同,方差 $D(X)<D(Y)$,且

    $$\frac{D(X)}{D(Y)}=\frac{14}{21}=\frac23=\frac{N-n}{N-1}=\frac{10-4}{10-1}$$

    不放回时,前面抽到次品会让后面更难抽到次品,结果更“集中”在平均值附近

答案:$E(Y)=\dfrac65$,$D(Y)=\dfrac{21}{25}$;期望相等,不放回方差更小。

易错

不放回地取 4 件,不是 4 次独立试验,不能用 $\mathrm{C}_4^k0.3^k0.7^{4-k}$。

面试顺序与最后一名的位置

例 22024 广东一模测试(一)

$N$ 名学生来自 A、B、C 三校,其中 A 校 $n$ 人($n>1$)。随机给每人安排面试号码 $1,2,\dots,N$,按号码依次面试,每人 5 分钟。

(1)求 2 号学生来自 A 校的概率;

(2)若 $N=40$,$n=10$,B、C 两校人数比为 $1:2$,求 A 校学生先于另两校完成面试(A 校全部面完时,B、C 两校都还有人未面)的概率;

(3)$X$ 为从第 1 人开始到最后一名 A 校学生面完的时长,证明 $E(X)=\dfrac{5n(N+1)}{n+1}$。

建模思路

只关心“哪些号码给了 A 校”:从 $N$ 个号码中不放回地随机取 $n$ 个,所有 $\mathrm{C}_N^n$ 种取法等可能——这正是超几何的抽样模型。

解析

(1)2 号来自 A 校

  1. A 校占用的号码集合有 $\mathrm{C}_N^n$ 种等可能情况;含 2 号的有 $\mathrm{C}_{N-1}^{n-1}$ 种。

    $$P=\frac{\mathrm{C}_{N-1}^{n-1}}{\mathrm{C}_N^n}=\frac nN$$

    与“抽签与顺序无关”一致:每个位置是 A 校的概率都是 $\frac nN$,这也是超几何 $E=\frac{nM}{N}$ 的来源

答案:$\dfrac nN$。

(2)A 校先于 B、C 完成

  1. 人数:A 10,B 10,C 20。事件发生时,最后一位(40 号)一定不是 A 校。按 40 号属于哪校分类。

  2. 40 号是 B 校(概率 $\tfrac{10}{40}$):此时 B 校一定未在 A 之前完成,还要求 C 校在 A 校之后完成,即 A、C 共 30 人中排最后的是 C 校,条件概率 $\tfrac{20}{30}$。

    固定 40 号后,其余 39 人的顺序仍等可能,A、C 这 30 人中谁排最后也等可能

  3. 40 号是 C 校(概率 $\tfrac{20}{40}$):同理要求 A、B 共 20 人中排最后的是 B 校,条件概率 $\tfrac{10}{20}$。

  4. 由全概率公式,

    $$P=\frac{10}{40}\cdot\frac{20}{30}+\frac{20}{40}\cdot\frac{10}{20}=\frac16+\frac14=\frac5{12}$$

    已用 40 万次随机排列模拟验证,频率 $0.4167$

答案:$\dfrac5{12}$。

(3)证明 $E(X)$ 公式

  1. 设最后一名 A 校学生的号码为 $K$,则 $X=5K$,$K\in\{n,\dots,N\}$。

  2. 超几何视角:$K\le k\iff$ 前 $k$ 个号码中 A 校恰有 $n$ 人,$P(K\le k)=\dfrac{\mathrm{C}_k^n}{\mathrm{C}_N^n}$。相减得

    $$P(K=k)=\frac{\mathrm{C}_k^n-\mathrm{C}_{k-1}^n}{\mathrm{C}_N^n}=\frac{\mathrm{C}_{k-1}^{n-1}}{\mathrm{C}_N^n}$$

    也可直接数:$k$ 号给 A,其余 $n-1$ 个 A 在前 $k-1$ 个号码里

  3. $E(K)=\dfrac1{\mathrm{C}_N^n}\sum\limits_{k=n}^{N}k\mathrm{C}_{k-1}^{n-1}$,而

    $$k\mathrm{C}_{k-1}^{n-1}=k\cdot\frac{(k-1)!}{(n-1)!(k-n)!}=n\cdot\frac{k!}{n!(k-n)!}=n\mathrm{C}_k^n$$

  4. 由 $\mathrm{C}_n^n+\mathrm{C}_{n+1}^n+\cdots+\mathrm{C}_N^n=\mathrm{C}_{N+1}^{n+1}$:

    $$ \begin{aligned} E(K)&=\frac{n\mathrm{C}_{N+1}^{n+1}}{\mathrm{C}_N^n}=n\cdot\frac{(N+1)!}{(n+1)!(N-n)!}\cdot\frac{n!(N-n)!}{N!}\\ &=\frac{n(N+1)}{n+1} \end{aligned} $$

    恒等式由 $\mathrm{C}_{k}^{n}=\mathrm{C}_{k+1}^{n+1}-\mathrm{C}_{k}^{n+1}$ 累加得到

  5. 所以 $E(X)=5E(K)=\dfrac{5n(N+1)}{n+1}$。

    直观:$n$ 个 A 把 $N+1$ 个“间隔”平均分,最后一个 A 平均在 $\frac{n(N+1)}{n+1}$ 处

答案:证毕。

易错

第(2)问容易写成 $P(\text{A 最后一人}<\text{B 最后一人})\cdot P(\text{A 最后一人}<\text{C 最后一人})$,这两个事件并不独立。

有放回抽取号码互不相同

例 32011 湖南高考理科

(1)设 $f(x)=\ln(1+x)-\dfrac{2x}{x+2}$,证明:当 $x>0$ 时 $f(x)>0$;

(2)从编号 1 到 100 的 100 张卡片中每次随机抽取一张后放回,连续抽取 20 次,设 20 个号码互不相同的概率为 $p$,证明:$p<\left(\dfrac9{10}\right)^{19}<\dfrac1{\mathrm e^2}$。

建模思路

有放回时 20 个号码互不相同,相当于“碰巧和不放回一样”。概率等于 $\dfrac{\mathrm{A}_{100}^{20}}{100^{20}}$,衡量有放回与不放回的差别;$N$ 很大而 $n$ 很小时它接近 1,此时两种抽样几乎相同。

解析

(1)$f(x)>0$($x>0$)

  1. 求导:

    $$ \begin{aligned} f'(x)&=\frac1{1+x}-\frac{4}{(x+2)^2}=\frac{(x+2)^2-4(1+x)}{(1+x)(x+2)^2}\\ &=\frac{x^2}{(1+x)(x+2)^2} \end{aligned} $$

  2. $x>-1$ 时 $f'(x)\ge0$,$f$ 在 $(-1,+\infty)$ 上单调递增(仅在 $x=0$ 处导数为 0)。所以 $x>0$ 时 $f(x)>f(0)=0$。

    顺便得到:$-1<x<0$ 时 $f(x)<0$,第(2)问要用

答案:证毕。

(2)$p<\left(\frac9{10}\right)^{19}<\mathrm e^{-2}$

  1. 20 次有放回共 $100^{20}$ 种等可能结果,号码互不相同的有 $\mathrm{A}_{100}^{20}=100\times99\times\cdots\times81$ 种:

    $$p=\frac{100\times99\times\cdots\times81}{100^{20}}=\frac{99\times98\times\cdots\times81}{100^{19}}$$

  2. 分子 19 个因数以 90 为中心首尾配对:$(90+k)(90-k)=90^2-k^2<90^2$($k=1,\dots,9$),中间剩一个 90。所以分子 $<90^{19}$,$p<\left(\tfrac9{10}\right)^{19}$。

  3. 要证 $\left(\tfrac9{10}\right)^{19}<\mathrm e^{-2}$,即 $\ln\tfrac9{10}<-\tfrac2{19}$。由(1)$-1<x<0$ 时 $f(x)<0$,取 $x=-\tfrac1{10}$:

    $$\ln\frac9{10}<\frac{2\cdot\left(-\frac1{10}\right)}{-\frac1{10}+2}=-\frac2{19}$$

    数值:$p\approx0.1304$,$0.9^{19}\approx0.13509$,$\mathrm e^{-2}\approx0.13534$,第二个不等式非常紧

答案:证毕。

易错

分母是 $100^{20}$(每次都有 100 种),约掉首项 100 后剩 19 个 100;不要写成 $\mathrm{C}_{100}^{20}$。

课堂小测

课堂小测

10 件产品中有 3 件次品,不放回地任取 4 件,次品数 $X$ 的期望为

查看答案与解析

答案B

解析

$E(X)=\dfrac{nK}{N}=\dfrac{4\times3}{10}=1.2$,与有放回时相同。

辨析
  • A:$\frac{3}{10}$ 是单件为次品的概率,还要乘以取出件数 4
  • C:不放回不改变期望,只改变方差,不需要乘修正因子
  • D:3 是 $X$ 能取到的最大值,不是期望。
课堂小测

同一题中,不放回的方差 $D_1$ 与有放回的方差 $D_2$ 的关系为

查看答案与解析

答案C

解析

$D_2=4\times0.3\times0.7=0.84$,$D_1=0.84\times\dfrac{10-4}{10-1}=0.56<0.84$。

辨析
  • A:不放回时各次抽取负相关,方差会变小,不会相等
  • B:方向反了,修正因子 $\frac{N-n}{N-1}=\frac69<1$
  • D:两个方差都能具体算出:$0.56$ 和 $0.84$。
课堂小测

袋中 5 个红球、3 个白球,不放回取 6 个,红球个数 $X$ 的可能取值为

查看答案与解析

答案D

解析

$\max(0,\,6-3)=3\le X\le\min(6,5)=5$。

辨析
  • A:只有 3 个白球,取 6 个时至少有 3 个红球,$X$ 不能为 0、1、2
  • B:只有 5 个红球,$X$ 最大为 5,不能为 6
  • C:下限是 $n-(N-K)=6-3=3$,不是 2:取 2 个红球就要 4 个白球,但白球只有 3 个。
专题 08

正态分布:$\mu$ 定位置,$\sigma$ 定胖瘦,面积就是概率

所有正态曲线都是同一条钟形曲线平移、伸缩得到的。会用对称性和 $3\sigma$ 原则,再把任何区间“标准化”成 $Z$,就能求所有正态概率。

看见:$\mu$、$\sigma$ 与 $3\sigma$ 原则

$\mu$、$\sigma$ 与曲线形状;阴影面积 = 区间概率

标准正态曲线 N(0,1)(\mu=0,\ \sigma=1)。绿色实线是密度曲线,绿色虚线是对称轴 x=\mu;橙色阴影是 \mu-\sigma<X<\mu+\sigma 之间曲线下的面积,等于 0.6827,即该区间的概率。灰色虚线(标准正态参照)与绿线重合。
图 1标准正态曲线 $N(0,1)$($\mu=0,\ \sigma=1$)。绿色实线是密度曲线,绿色虚线是对称轴 $x=\mu$;橙色阴影是 $\mu-\sigma<X<\mu+\sigma$ 之间曲线下的面积,等于 $0.6827$,即该区间的概率。灰色虚线(标准正态参照)与绿线重合。

图中 $\mu=0$,$\sigma=1$,阴影面积 $P(\mu-\sigma<X<\mu+\sigma)=0.6827$;标准化后对应的区间是 $-1<Z<1$;峰值 $\dfrac{1}{\sigma\sqrt{2\pi}}\approx0.3989$。灰色虚线表示标准正态 $N(0,1)$,在其他 $\mu$、$\sigma$ 下用作参照。

密度函数与 $3\sigma$ 原则

$$ \varphi_{\mu,\sigma}(x)=\frac{1}{\sigma\sqrt{2\pi}}\,e^{-\frac{(x-\mu)^2}{2\sigma^2}},\quad X\sim N(\mu,\sigma^2) $$

区间 $\mu\pm\sigma$ $\mu\pm2\sigma$ $\mu\pm3\sigma$
概率 0.6827 0.9545 0.9973
思路

$\sigma$ 变化时,$\mu\pm k\sigma$ 区间里的概率不变:曲线变胖,区间也跟着变宽,两者恰好抵消。所以这三个数对所有正态分布通用。

抽样验证:样本落在 $\mu\pm k\sigma$ 内的频率

从正态分布中随机抽样得到的频率直方图(蓝色柱,深蓝柱落在 \mu\pm\sigma 内),叠加理论密度曲线(绿线),横轴按 \mu+k\sigma 标注。柱子的轮廓与曲线大体吻合。
图 2从正态分布中随机抽样得到的频率直方图(蓝色柱,深蓝柱落在 $\mu\pm\sigma$ 内),叠加理论密度曲线(绿线),横轴按 $\mu+k\sigma$ 标注。柱子的轮廓与曲线大体吻合。
区间 样本频率 理论概率
$\mu\pm\sigma$ 0.6720 0.6827
$\mu\pm2\sigma$ 0.9450 0.9545
$\mu\pm3\sigma$ 0.9950 0.9973

样本频率与理论概率接近。

推导:性质与对称性

从密度函数读出性质

  1. 连续型随机变量用面积表示概率: $$P(a<X<b)=\int_a^b\varphi(x)\,dx=\text{曲线下 }[a,b]\text{ 上的面积}$$

    高中不要求计算积分,只要求理解“面积 = 概率”,总面积为 1

  2. 单点概率为 0:$P(X=a)=0$,所以 $P(a<X<b)=P(a\le X\le b)$。

    一条线段没有面积。题目里 $<$ 与 $\le$ 可以随意换

  3. 对称性:指数里是 $(x-\mu)^2$,把 $x=\mu+t$ 与 $x=\mu-t$ 代入得到同一个值,曲线关于 $x=\mu$ 对称。

    所以 $P(X<\mu)=P(X>\mu)=0.5$

  4. 最高点:$(x-\mu)^2\ge0$,指数 $-\dfrac{(x-\mu)^2}{2\sigma^2}\le0$,在 $x=\mu$ 取最大,峰值 $\dfrac{1}{\sigma\sqrt{2\pi}}$。

    $\sigma$ 越小峰越高、曲线越“瘦高”,数据越集中;$\sigma$ 越大越“矮胖”

  5. $\mu$ 只出现在 $x-\mu$ 里:改变 $\mu$ 就是整体平移,形状不变。$\mu=E(X)$,$\sigma^2=D(X)$。
  6. 对称性的两个常用式:设 $x_1+x_2=2\mu$(两点关于 $\mu$ 对称),则 $$P(X<x_1)=P(X>x_2)$$ $$P(X>\mu+c)=\frac{1-P(\mu-c<X<\mu+c)}{2}$$

    两尾面积相等,各占“1 减中间”的一半

  7. 中间一半:$P(\mu<X<\mu+c)=\dfrac12P(\mu-c<X<\mu+c)$。

    例:$P(\mu<X<\mu+2\sigma)=0.9545/2\approx0.4772$

  8. $3\sigma$ 原则的含义:$P(|X-\mu|\ge3\sigma)\approx0.0027$,一次试验几乎不会发生。

    生产中若测得值落在 $(\mu-3\sigma,\ \mu+3\sigma)$ 之外,就认为生产过程可能出现异常

对称性:左尾 = 右尾

以 t=1(c=\sigma)为例:绿色曲线为密度,青绿色区域是 \mu\pm\sigma 之间的中间部分(面积 0.6827),左右两块红色区域是对称的两条尾部,面积都是 0.1587。
图 3以 $t=1$($c=\sigma$)为例:绿色曲线为密度,青绿色区域是 $\mu\pm\sigma$ 之间的中间部分(面积 0.6827),左右两块红色区域是对称的两条尾部,面积都是 0.1587。

$$ \begin{aligned} P(X<\mu-\sigma)&=P(X>\mu+\sigma)\\ &=\tfrac{1-0.6827}{2}=0.1587\\ P(\mu<X<\mu+\sigma)&=\tfrac{0.6827}{2}=0.3413 \end{aligned} $$

典型题

$X\sim N(2,\sigma^2)$,$P(X<4)=0.8$,求 $P(0<X<2)$。
$4$ 与 $0$ 关于 $\mu=2$ 对称:$P(X\le0)=P(X\ge4)=0.2$,所以 $P(0<X<4)=0.6$,再取一半得 $0.3$。
整个过程不需要知道 $\sigma$。

标准化:$Z=\dfrac{X-\mu}{\sigma}$

同一块面积,换一把尺子

上图:X\sim N(50,10^2),横轴是原始单位 x,橙色阴影为 40<X<65。
图 4上图:$X\sim N(50,10^2)$,横轴是原始单位 $x$,橙色阴影为 $40<X<65$。
下图:Z\sim N(0,1),横轴是 z=\dfrac{x-\mu}{\sigma},橙色阴影为 -1<Z<1.5。与上图相比曲线形状与阴影面积完全相同,只是刻度换了。
图 5下图:$Z\sim N(0,1)$,横轴是 $z=\dfrac{x-\mu}{\sigma}$,橙色阴影为 $-1<Z<1.5$。与上图相比曲线形状与阴影面积完全相同,只是刻度换了。

上图刻度是原始单位 $x$,下图刻度是 $z=\dfrac{x-\mu}{\sigma}$。两张图的曲线与阴影完全一样,只是刻度换了。

标准化与查表

  1. 令 $Z=\dfrac{X-\mu}{\sigma}$,则 $$E(Z)=\frac{E(X)-\mu}{\sigma}=0,\qquad D(Z)=\frac{D(X)}{\sigma^2}=1$$ 且 $Z\sim N(0,1)$。

    线性变换 $Z=\frac1\sigma X-\frac\mu\sigma$:平移再伸缩,正态分布仍是正态分布

  2. 事件不变,只是换说法: $$a<X<b\iff \frac{a-\mu}{\sigma}<Z<\frac{b-\mu}{\sigma}$$

    两边同减 $\mu$、同除以 $\sigma$($\sigma>0$,不等号不变向)

  3. 记 $\Phi(z)=P(Z<z)$,则 $$P(a<X<b)=\Phi\Big(\tfrac{b-\mu}\sigma\Big)-\Phi\Big(\tfrac{a-\mu}\sigma\Big)$$
  4. 表里只有 $z\ge0$:用对称性 $\Phi(-z)=1-\Phi(z)$。

算例:$X\sim N(50,10^2)$,求 $P(40<X<65)$

$$ \begin{aligned} z_a&=\frac{40-50}{10}=-1.00,\qquad z_b=\frac{65-50}{10}=1.50\\[4pt] \Phi(1.50)&=0.9332,\qquad \Phi(-1.00)=1-\Phi(1.00)=0.1587\\[4pt] P(40<X<65)&=\Phi(z_b)-\Phi(z_a)\approx0.7745 \end{aligned} $$

不取整 $z$ 的精确值也是 $0.7745$。

$\Phi(z)$ 表(节选)

行表示 $z$ 的整数部分与十分位,列表示百分位;加粗的是本节算例与例题用到的值($z$ 取两位小数)。

$z$ +0.00 +0.01 +0.02 +0.03 +0.04
0.2 0.5793 0.5832 0.5871 0.5910 0.5948
0.5 0.6915 0.6950 0.6985 0.7019 0.7054
1.0 0.8413 0.8438 0.8461 0.8485 0.8508
1.5 0.9332 0.9345 0.9357 0.9370 0.9382
2.0 0.9772 0.9778 0.9783 0.9788 0.9793
$z$ +0.05 +0.06 +0.07 +0.08 +0.09
0.2 0.5987 0.6026 0.6064 0.6103 0.6141
0.5 0.7088 0.7123 0.7157 0.7190 0.7224
1.0 0.8531 0.8554 0.8577 0.8599 0.8621
1.5 0.9394 0.9406 0.9418 0.9429 0.9441
2.0 0.9798 0.9803 0.9808 0.9812 0.9817

同样的标准化,用在后面三道例题的数据上

情境 事件 标准化 查表 概率
例 1①:$X\sim N(1000,30^2)$ $X>994$ $z_a=\dfrac{994-1000}{30}=-0.20$ $\Phi(-0.20)=1-\Phi(0.20)=0.4207$ $P=1-\Phi(z_a)\approx0.5793$
例 1②:$X\sim N(1000,30^2)$ $X\le1016$ $z_b=\dfrac{1016-1000}{30}=0.53$ $\Phi(0.53)=0.7019$ $P=\Phi(z_b)\approx0.7019$(不取整 $z$ 时约 $0.7031$)
例 2(1)改造前:$N(50,0.4^2)$ $49.60<X<50.40$ $z_a=-1.00,\ z_b=1.00$ $\Phi(1.00)=0.8413$,$\Phi(-1.00)=0.1587$ $P\approx0.6826$(精确值 $0.6827$)
例 2(1)改造后:$N(50,0.2^2)$ $49.60<X<50.40$ $z_a=-2.00,\ z_b=2.00$ $\Phi(2.00)=0.9772$,$\Phi(-2.00)=0.0228$ $P\approx0.9544$(精确值 $0.9545$)
例 3:$U\sim N(220,20^2)$ $U\le200$ $z_b=\dfrac{200-220}{20}=-1.00$ $\Phi(-1.00)=1-\Phi(1.00)=0.1587$ $P=\Phi(z_b)\approx0.1587$

二项分布逼近正态

$n$ 变大时,二项分布的柱子贴上了正态曲线

固定 p=0.2,比较 n=20(左)与 n=200(右)的标准化概率柱:横轴 z=(k-np)/\sigma,柱高 \sigma P(X=k),绿线为标准正态密度。n 增大时偏斜减弱,概率柱更贴近绿线;左图对应下文的 B(20,0.2) 数值。
图 6固定 $p=0.2$,比较 $n=20$(左)与 $n=200$(右)的标准化概率柱:横轴 $z=(k-np)/\sigma$,柱高 $\sigma P(X=k)$,绿线为标准正态密度。$n$ 增大时偏斜减弱,概率柱更贴近绿线;左图对应下文的 $B(20,0.2)$ 数值。

图中 $n=20$,$p=0.2$:$\mu=np=4$,$\sigma=\sqrt{np(1-p)}\approx1.789$;取 $k=4$ 时,精确值 $P(X\le k)=0.6296$,正态近似 $\Phi\Big(\dfrac{k-\mu}{\sigma}\Big)=0.5000$,连续性修正 $\Phi\Big(\dfrac{k+0.5-\mu}{\sigma}\Big)=0.6101$。

为什么能用正态近似

  1. $X\sim B(n,p)$ 是 $n$ 个独立的 0-1 变量之和:$X=X_1+\cdots+X_n$,$E(X)=np$,$D(X)=np(1-p)$。
  2. 棣莫弗–拉普拉斯定理:$n$ 较大时,$X$ 近似服从 $N\big(np,\ np(1-p)\big)$。

    大量独立小因素叠加,总和近似正态(中心极限定理,大学内容)。高中题目会直接给出这一结论

  3. 使用方法:先算 $\mu=np$、$\sigma=\sqrt{np(1-p)}$,再标准化查表。

    例 1:$n=10000$,$p=0.1$,$\mu=1000$,$\sigma=30$

  4. 何时近似好:$np$ 与 $n(1-p)$ 都比较大(经验上都不小于 5)。$p$ 接近 0 或 1 时柱子偏斜,需要更大的 $n$。

    对比 $p=0.05$ 时 $n=20$ 与 $n=200$ 的柱状图

固定 p=0.05 的标准化对比:n=20(左)明显右偏,n=200(右)更贴近同一条标准正态密度曲线(绿线)。横轴 z=(k-np)/\sigma,柱高为 \sigma P(X=k);较小的 p 需要更大的 n 才能获得较好的正态近似。
图 7固定 $p=0.05$ 的标准化对比:$n=20$(左)明显右偏,$n=200$(右)更贴近同一条标准正态密度曲线(绿线)。横轴 $z=(k-np)/\sigma$,柱高为 $\sigma P(X=k)$;较小的 $p$ 需要更大的 $n$ 才能获得较好的正态近似。
思路

把横轴换成 $z=\dfrac{k-np}{\sigma}$、柱高乘 $\sigma$ 之后,无论 $n$、$p$ 取多少,柱子都向同一条标准正态曲线靠拢。

注意

上面的“修正”是连续性修正(把 $k$ 换成 $k+0.5$),近似更准,属于大学内容;高中题目按题给方法直接用 $\Phi\Big(\dfrac{k-\mu}{\sigma}\Big)$。

例题精讲

例 12021 福建师大附中模拟

阅览室座位(二项近似正态)
某高校共有 10000 名学生,阅览室共有 994 个座位。各学生是否去自习相互独立,每人每晚去自习的概率均为 0.1。
(1)记每晚去自习的人数为 $X$,求 $E(X)$、$D(X)$;
(2)$n$ 较大时二项分布可视为正态分布;若 $Y\sim N(\mu,\sigma^2)$,令 $Z=\dfrac{Y-\mu}{\sigma}$,则 $Z\sim N(0,1)$,记 $\Phi(a)=P(Z<a)$。标准正态分布表(节选):

$a$ 0.00 0.01 0.02 0.03 0.04
0.2 0.5793 0.5832 0.5871 0.5910 0.5948
0.5 0.6915 0.6950 0.6985 0.7019 0.7054

① 求座位不够用的概率;② 若要使座位够用的概率高于 0.7,至少需要添加多少个座位?

建模思路

$X\sim B(10000,0.1)$,$n$ 很大 $\Rightarrow$ 近似 $N\big(np,np(1-p)\big)$。“不够用”“够用”翻译成 $X$ 的不等式,再标准化查表。

解析

(1)$E(X)$ 与 $D(X)$

  1. 每个学生去或不去是一次伯努利试验,10000 次独立重复,$X\sim B(10000,\,0.1)$。
  2. $$E(X)=np=1000,\qquad D(X)=np(1-p)=1000\times0.9=900$$

答案:$E(X)=1000$,$D(X)=900$

(2)① 座位不够用的概率

  1. 近似 $X\sim N(1000,\,30^2)$,$\sigma=\sqrt{900}=30$。

    查表要用标准差 $\sigma=30$,不是方差 900

  2. 座位不够用 $\iff X>994$。标准化: $$P(X>994)=P\Big(Z>\frac{994-1000}{30}\Big)=P(Z>-0.2)$$
  3. 表里没有负数,用对称性:$P(Z>-0.2)=P(Z<0.2)=\Phi(0.20)=0.5793$。

    标准正态曲线关于 $z=0$ 对称,右尾 $z>-0.2$ 与左侧 $z<0.2$ 面积相同

答案:约 $0.5793$

(2)② 至少添加多少个座位

  1. 设座位总数为 $m$,要求 $P(X\le m)>0.7$,即 $\Phi\Big(\dfrac{m-1000}{30}\Big)>0.7$。
  2. 查表:$\Phi(0.52)=0.6985<0.7$,$\Phi(0.53)=0.7019>0.7$,$\Phi$ 单调递增,所以需要 $\dfrac{m-1000}{30}\ge0.53$。

    “高于 0.7”要取第一个超过 0.7 的值 0.53,不能取 0.52

  3. $m\ge1000+30\times0.53=1015.9$,$m$ 为整数,$m_{\min}=1016$。
  4. 需添加 $1016-994=22$ 个座位。

    验算(精确二项分布):$P(X\le1015)\approx0.6984$,$P(X\le1016)\approx0.7099$,结论同样是 1016

答案:至少添加 22 个座位

易错

易错点:① 把 $\sigma$ 写成 900;② 正态近似只是近似:用二项分布精确计算 $P(X>994)\approx0.571$,与 0.5793 略有差别,题目要求按正态近似作答。

例 22024 武汉五月模拟

优品率与系统可靠性
某零部件质量指标介于 $(49.6,50.4)$ 为优品。技术改造前质量指标服从 $N(50,0.16)$,改造后服从 $N(50,0.04)$。附:$P(|X-\mu|<\sigma)=0.6827$,$P(|X-\mu|<2\sigma)=0.9545$。
(1)求改造后与改造前的优品率之差;
(2)控制系统中每个元件正常工作的概率都是 $p\ (0<p<1)$,相互独立,超过一半的元件正常工作系统就能正常工作(其概率称为可靠性)。
① 原有 4 个元件,求可靠性,并判断增加一个元件后可靠性是否提高;
② 系统有 $n\ (n\ge3)$ 个元件,再增加一个元件是否一定提高可靠性?证明你的结论。

建模思路

第(1)问:把区间端点写成 $\mu\pm k\sigma$。注意 $N(50,0.16)$ 里 0.16 是方差,$\sigma=0.4$。第(2)问:把“新增元件”单独拿出来,按它正常与否分类。

解析

(1)优品率之差

  1. 改造前 $\sigma_1=\sqrt{0.16}=0.4$,$(49.6,50.4)=(\mu-\sigma_1,\mu+\sigma_1)$,优品率 $0.6827$。
  2. 改造后 $\sigma_2=\sqrt{0.04}=0.2$,$(49.6,50.4)=(\mu-2\sigma_2,\mu+2\sigma_2)$,优品率 $0.9545$。

    区间不变、$\sigma$ 变小,同一区间相当于更多个 $\sigma$,概率变大:$\sigma$ 小 = 质量更稳定

  3. 差:$0.9545-0.6827=0.2718$。

答案:$0.2718$

(2)① 4 个元件与 5 个元件

  1. 正常元件数 $X\sim B(n,p)$。$n=4$ 要 $X\ge3$: $$P_4=\mathrm{C}_4^3p^3(1-p)+p^4=p^3(4-3p)$$
  2. $n=5$ 也要 $X\ge3$: $$P_5=\mathrm{C}_5^3p^3(1-p)^2+\mathrm{C}_5^4p^4(1-p)+p^5$$
  3. 作差(展开整理): $$P_5-P_4=6p^3(1-p)^2>0$$

    也可用下面②的方法:5 个 = 前 4 个 + 新元件,$P_5-P_4=p\cdot P(\text{前 4 个恰 2 个正常})=p\cdot6p^2(1-p)^2$

答案:$P_4=p^3(4-3p)$;增加一个元件后可靠性提高

(2)② $n$ 个元件再加一个

  1. 记前 $n$ 个中正常个数为 $X\sim B(n,p)$。新系统正常个数 $Y=X+\xi$,$\xi$ 表示新元件是否正常,$P(\xi=1)=p$,与 $X$ 独立。
  2. 关键式:对整数 $m$, $$P(Y\ge m)=P(X\ge m)+P(X=m-1)\cdot p$$

    要么前 $n$ 个已有 $m$ 个正常(新元件无所谓),要么前 $n$ 个恰好 $m-1$ 个、新元件正常

  3. $n=2k$(偶数,$k\ge2$):原系统要 $X\ge k+1$;新系统 $2k+1$ 个也要 $Y\ge k+1$。 $$P(Y\ge k+1)-P(X\ge k+1)=p\,\mathrm{C}_{2k}^kp^k(1-p)^k>0$$ 可靠性提高。
  4. $n=2k-1$(奇数,$k\ge2$):原系统要 $X\ge k$;新系统 $2k$ 个要 $Y\ge k+1$。 $$\begin{aligned}P(Y\ge k+1)-P(X\ge k)&=p\,P(X=k)-P(X=k)\\&=-(1-p)\,\mathrm{C}_{2k-1}^kp^k(1-p)^{k-1}<0\end{aligned}$$ 可靠性下降。

    用 $P(X\ge k)=P(X\ge k+1)+P(X=k)$ 消去公共部分

  5. 结论:不一定。$n$ 为偶数时加一个元件提高可靠性;$n$ 为奇数时反而降低。

    直观:奇数变偶数时“超过一半”的门槛多了 1 个,而新元件只有概率 $p$ 能补上

答案:不一定:$n$ 为偶数时提高,$n$ 为奇数时降低

易错

易错点:$N(50,0.16)$ 的第二个参数是方差 $\sigma^2$,误把 $\sigma$ 当作 0.16 会使区间对不上 $\mu\pm k\sigma$。

例 32024 南京盐城一模

电压状态与不合格品
机器电源电压 $U\sim N(220,20^2)$(单位:V)。电压有三种状态:① 不超过 200 V;② 200 V~240 V 之间;③ 超过 240 V。三种状态下生产的零件为不合格品的概率分别为 0.15、0.05、0.2。
(1)求该机器生产的零件为不合格品的概率;
(2)随机抽取 $n\ (n\ge2)$ 件,记恰有 2 件不合格品的概率为 $p_n$,求 $p_n$ 取最大值时 $n$ 的值。附:$P(\mu-\sigma<Z<\mu+\sigma)=0.68$,$P(\mu-2\sigma<Z<\mu+2\sigma)=0.95$。

建模思路

正态分布给出三种状态的概率(对称性),全概率公式合成不合格率;第(2)问用相邻项比值找数列最大项。

解析

(1)不合格品的概率

  1. $\mu=220$,$\sigma=20$:$(200,240)=(\mu-\sigma,\mu+\sigma)$,$P=0.68$。
  2. 两尾对称:$P(U\le200)=P(U>240)=\dfrac{1-0.68}{2}=0.16$。
  3. 全概率公式: $$P(D)=0.16\times0.15+0.68\times0.05+0.16\times0.2=0.024+0.034+0.032=0.09$$

    三种状态构成样本空间的一个划分

答案:$0.09$

(2)$p_n$ 最大时的 $n$

  1. 各件独立,不合格件数 $\sim B(n,0.09)$:$p_n=\mathrm{C}_n^2\,0.09^2\,0.91^{n-2}$。
  2. 相邻项比值: $$\frac{p_{n+1}}{p_n}=\frac{\mathrm{C}_{n+1}^2}{\mathrm{C}_n^2}\cdot0.91=\frac{n+1}{n-1}\cdot0.91$$

    $\dfrac{\mathrm{C}_{n+1}^2}{\mathrm{C}_n^2}=\dfrac{(n+1)n/2}{n(n-1)/2}=\dfrac{n+1}{n-1}$

  3. $\dfrac{p_{n+1}}{p_n}>1\iff0.91(n+1)>n-1\iff n<\dfrac{1.91}{0.09}=\dfrac{191}{9}\approx21.2$。
  4. 所以 $2\le n\le21$ 时 $p_{n+1}>p_n$;$n\ge22$ 时 $p_{n+1}<p_n$: $$p_2<\cdots<p_{21}<p_{22}>p_{23}>\cdots$$

    验算:$p_{21}\approx0.28346$,$p_{22}\approx0.28374$,$p_{23}\approx0.28280$

答案:$n=22$

易错

易错点:比值与 1 比较后,要把“$n\le21$ 时 $p_{n+1}>p_n$”翻译成“$p_{22}$ 最大”,不要误答 21。

课堂小测

课堂小测

已知 $X\sim N(2,\sigma^2)$,$P(X<4)=0.8$,则 $P(0<X<2)=$

查看答案与解析

答案B

解析

$P(X\le0)=P(X\ge4)=0.2$,$P(0<X<4)=0.6$,关于 $\mu=2$ 对称,取一半得 $0.3$。

辨析
  • A:$0.2$ 是 $P(X\ge4)$,也等于 $P(X\le0)$,是尾部面积,不是所求的中间一半
  • C:$0.4$ 把 $P(0<X<2)$ 当成了 $0.8-0.4$ 之类的拼凑,没有利用对称轴 $x=2$
  • D:$0.6$ 是 $P(0<X<4)$,还要取一半。
课堂小测

$X_1\sim N(\mu_1,\sigma_1^2)$、$X_2\sim N(\mu_2,\sigma_2^2)$ 的密度曲线中,$X_1$ 的曲线更“瘦高”,且对称轴在 $X_2$ 的左边。则

查看答案与解析

答案C

解析

对称轴靠左 $\Rightarrow$ $\mu$ 小;瘦高 $\Rightarrow$ $\sigma$ 小。

辨析
  • A:瘦高说明峰值 $\frac1{\sigma\sqrt{2\pi}}$ 大,$\sigma$ 小,所以 $\sigma_1<\sigma_2$,不是大于
  • B:对称轴 $x=\mu$ 在左边说明 $\mu_1<\mu_2$,不是大于
  • D:$\mu$ 与 $\sigma$ 都判断反了:$\mu$ 看对称轴位置,$\sigma$ 看胖瘦。
课堂小测

某次考试成绩 $X\sim N(100,10^2)$。取 $P(|X-\mu|<2\sigma)=0.9545$,则成绩超过 120 分的概率约为

查看答案与解析

答案B

解析

$120=\mu+2\sigma$,$P(X>120)=\dfrac{1-0.9545}{2}=0.02275$。

辨析
  • A:$0.0455$ 是两尾之和 $P(|X-100|\ge20)$,只要右尾,再除以 2
  • C:$0.00135$ 对应 $\mu+3\sigma=130$ 以上,而 120 只是 $\mu+2\sigma$
  • D:$0.1587$ 对应 $\mu+\sigma=110$ 以上。
专题 09

概率递推与马尔可夫链:下一步只看这一步

“下一次的状态只依赖这一次的状态”——抓住这一点,就能写出 $p_{n+1}$ 与 $p_n$ 的递推式。用不动点法把它变成等比数列,通项、极限、期望都随之而来。

看见:状态转移与分布演化

状态转移图:圆圈表示状态,箭头上的数是转移概率;每个状态发出的箭头上的概率之和为 1。分布演化图:每个柱子是某一步各状态所占的概率(自下而上叠放),虚线是平稳分布的分界线。下面用三个模型来看:投篮换人、传球、摸球交换。

投篮换人(第 24 题)

甲投与乙投的状态转移;每个状态发出的概率之和为 1。
图 1甲投与乙投的状态转移;每个状态发出的概率之和为 1。
甲投(下层绿)与乙投(上层蓝)的概率演化;绿虚线为平稳概率 1/3。
图 2甲投(下层绿)与乙投(上层蓝)的概率演化;绿虚线为平稳概率 $1/3$。

甲命中就继续投(甲→甲),未命中换乙(甲→乙);乙同理。取甲命中率 $a=0.6$,乙命中率 $b=0.8$,第 1 次甲投的概率 $p_1=0.5$。转移概率:

从\到 甲投 乙投
甲投 $\frac35$ $\frac25$
乙投 $\frac15$ $\frac45$
递推与通项

$$ \begin{aligned} p_{n+1}&=\tfrac35\,p_n+\tfrac15(1-p_n)=0.40\,p_n+0.20\\ x^*&=\frac{0.20}{1-0.40}=\frac13,\qquad p_n=\frac13+\Big(\frac12-\frac13\Big)(0.40)^{n-1} \end{aligned} $$

“甲投”的概率 $p_n$ 的演化:

第 $n$ 次 1 2 5 10
$P(\text{甲投})$ $\frac12$ $\frac25$ $\frac{211}{625}$ $\approx0.3334$

平稳概率 $\pi=\dfrac{1-b}{2-a-b}=\dfrac13$。

思路

不管第 1 次是谁投,几次之后“甲投”的概率都稳定在 $\pi=\dfrac{1-b}{2-a-b}$。乙命中率高,乙“占住”球权的时间长,所以 $\pi<\dfrac12$。

传球

甲持球与他人持球的状态转移;每个状态发出的概率之和为 1。
图 3甲持球与他人持球的状态转移;每个状态发出的概率之和为 1。
甲持球(下层绿)与他人持球(上层蓝)的概率演化;绿虚线为平稳概率 1/3。
图 4甲持球(下层绿)与他人持球(上层蓝)的概率演化;绿虚线为平稳概率 $1/3$。

球从甲开始,每次等可能传给其余 $m-1$ 人之一。只关心“球在不在甲手里”,把其余人合并成一个状态:甲持球 → 他人持球的概率为 1;他人持球 → 传回甲的概率为 $\dfrac1{m-1}$,仍在他人手中的概率为 $\dfrac{m-2}{m-1}$。

递推与通项

$$ \begin{aligned} p_{n+1}&=\frac1{m-1}(1-p_n),\qquad x^*=\frac1m\\ p_n&=\frac1m+\frac{m-1}{m}\Big(-\frac1{m-1}\Big)^{n}\quad(p_0=1) \end{aligned} $$

以 $m=3$(三人传球)为例,传 $n$ 次后球在甲手中的概率:

传球次数 $n$ 0 1 4 9
$P(\text{甲持球})$ $1$ $0$ $\frac38$ $\frac{85}{256}$

平稳概率 $\pi=\dfrac13$。

思路

$A=-\dfrac1{m-1}<0$:$p_n$ 在 $\dfrac1m$ 两侧来回摆动——上一次球在甲手里,这一次一定不在。

摸球交换(第 25 题)

甲袋 3 球、乙袋 3 球,共 2 黑 4 白;初始甲袋 2 黑 1 白,乙袋 3 白。每次各取一球交换。状态 = 甲袋黑球数(0、1、2),每次只能变化 1 个。

摸球交换的状态转移图:三个圆圈依次是“甲 0 黑”(绿)、“甲 1 黑”(蓝)、“甲 2 黑”(橙);箭头上的数是转移概率:0→0 为 \frac13,0→1 为 \frac23,1→0 为 \frac29,1→1 为 \frac59,1→2 为 \frac29,2→1 为 \frac23,2→2 为 \frac13;0 与 2 之间没有箭头。
图 5摸球交换的状态转移图:三个圆圈依次是“甲 0 黑”(绿)、“甲 1 黑”(蓝)、“甲 2 黑”(橙);箭头上的数是转移概率:0→0 为 $\frac13$,0→1 为 $\frac23$,1→0 为 $\frac29$,1→1 为 $\frac59$,1→2 为 $\frac29$,2→1 为 $\frac23$,2→2 为 $\frac13$;0 与 2 之间没有箭头。
摸球交换的分布演化:横轴是交换次数 n=0,1,\dots,15,每根柱自下而上叠放甲袋 0 黑(绿)、1 黑(蓝)、2 黑(橙)的概率;蓝色虚线在 0.8、绿色虚线在 0.2,是平稳分布的分界线。n=0 时全是橙色(甲袋必为 2 黑),几步之后各色块高度就不再变化。
图 6摸球交换的分布演化:横轴是交换次数 $n=0,1,\dots,15$,每根柱自下而上叠放甲袋 0 黑(绿)、1 黑(蓝)、2 黑(橙)的概率;蓝色虚线在 0.8、绿色虚线在 0.2,是平稳分布的分界线。$n=0$ 时全是橙色(甲袋必为 2 黑),几步之后各色块高度就不再变化。
递推与期望

$$ \begin{aligned} p_n&=\tfrac13p_{n-1}+\tfrac29q_{n-1},\quad q_n=\tfrac23p_{n-1}+\tfrac59q_{n-1}+\tfrac23(1-p_{n-1}-q_{n-1})\\ E(X_n)&=2p_n+q_n=\tfrac13E(X_{n-1})+\tfrac23\ \Rightarrow\ E(X_n)=1+\Big(\tfrac13\Big)^n \end{aligned} $$

前几步的取值:$E(X_1)=\dfrac43$,$E(X_2)=\dfrac{10}9$,$E(X_3)=\dfrac{28}{27}$;$p_2=\dfrac7{27}$,$q_2=\dfrac{16}{27}$。平稳分布为 $(0.2,\ 0.6,\ 0.2)$。

思路

平稳分布 $(0.2,0.6,0.2)$ 恰好是“从 6 球(2 黑)中随机取 3 球放进甲袋”的超几何分布:交换足够多次后,球被充分打乱。

推导:不动点法

从转移概率到通项:$p_{n+1}=Ap_n+B$

  1. 以投篮为例,记 $p_n=P(\text{第 }n\text{ 次甲投})$。第 $n+1$ 次是甲投,按第 $n$ 次是谁投分两类:

    $$p_{n+1}=p_n\cdot a+(1-p_n)(1-b)$$

    全概率公式:“第 $n$ 次甲投”“第 $n$ 次乙投”是一个划分。$a$ = 甲命中率(甲继续),$1-b$ = 乙未命中(换成甲)

  2. 整理成一阶线性递推:

    $$p_{n+1}=\underbrace{(a+b-1)}_{A}\,p_n+\underbrace{(1-b)}_{B}$$

    第 24 题:$a=0.6$,$b=0.8$,得 $p_{n+1}=0.4p_n+0.2$

  3. 不动点:若数列收敛到 $x^*$,则 $x^*=Ax^*+B$,

    $$x^*=\frac{B}{1-A}\quad(A\neq1)$$

    第 24 题:$x^*=0.2/0.6=\frac13$

  4. 两式相减,常数 $B$ 消掉:

    $$p_{n+1}-x^*=A\,(p_n-x^*)$$

    这就是“待定系数 $\lambda$”的本质:$\lambda=-x^*$。不动点法省去了解方程的过程

  5. 所以 $\{p_n-x^*\}$ 是公比为 $A$ 的等比数列(首项不为 0 时):

    $$p_n=x^*+(p_1-x^*)A^{\,n-1}$$

  6. 第 24 题:$p_1=\tfrac12$,

    $$p_n=\frac13+\frac16\Big(\frac25\Big)^{n-1}$$

  7. 收敛与振荡:$|A|<1$ 时 $A^{n-1}\to0$,$p_n\to x^*$,与初值无关。$A>0$ 单调趋近;$A<0$ 在 $x^*$ 两侧来回摆动。

    转移概率都在 $(0,1)$ 内时 $|A|=|a+b-1|<1$ 自动成立

  8. 求期望:若 $Y$ 为前 $n$ 次中甲投篮次数,$Y=\sum X_i$($X_i$ 为第 $i$ 次是否甲投),

    $$E(Y)=\sum_{i=1}^n p_i=\frac n3+\frac16\cdot\frac{1-(2/5)^n}{1-2/5}=\frac n3+\frac5{18}\Big[1-\Big(\frac25\Big)^n\Big]$$

    期望的线性性:不必求 $Y$ 的分布,把每一次的概率加起来

蛛网图:迭代 $p_{n+1}=Ap_n+B$ 走向不动点

蛛网迭代:左图 p_{n+1}=0.4p_n+0.2,从 p_1=0.5 趋向 1/3;右图 p_{n+1}=-0.7p_n+0.8,从 p_1=0.95 交替趋向 8/17。灰虚线为 y=x,蓝线为九步迭代,橙点为不动点。
图 7蛛网迭代:左图 $p_{n+1}=0.4p_n+0.2$,从 $p_1=0.5$ 趋向 $1/3$;右图 $p_{n+1}=-0.7p_n+0.8$,从 $p_1=0.95$ 交替趋向 $8/17$。灰虚线为 $y=x$,蓝线为九步迭代,橙点为不动点。

$$ \begin{array}{l} A=a+b-1=0.40,\quad B=1-b=0.20\\[4pt] x^*=\dfrac{B}{1-A}=0.3333\\[4pt] p_1,\dots,p_6:\ 0.500,\ 0.400,\ 0.360,\ 0.344,\ 0.338,\ 0.335 \end{array} $$

A<0 的情形

取 $a=0.1,\ b=0.2$:$A=-0.70<0$,$B=0.80$,$x^*=\dfrac{0.8}{1.7}\approx0.4706$。从 $p_1=0.95$ 出发,$p_2,\dots,p_6\approx0.135,\ 0.706,\ 0.306,\ 0.586,\ 0.390$,在 $x^*$ 两侧来回摆动,蛛网呈螺旋状收敛。

模拟:多条轨迹的收敛

取 $a=0.6$,$b=0.8$,第 1 次由抽签决定(甲、乙各 0.5)。

2000 场投篮,每场 30 次:每一行是一条轨迹

2000 场投篮模拟中的前 40 条轨迹:每行是一场,每列是该场的第 n 次投篮(列号 1—30),深绿格 = 甲投,浅蓝格 = 乙投。每一行里深绿与浅蓝来回交替、永不停止,但整体上浅蓝格明显多于深绿格。
图 82000 场投篮模拟中的前 40 条轨迹:每行是一场,每列是该场的第 $n$ 次投篮(列号 1—30),深绿格 = 甲投,浅蓝格 = 乙投。每一行里深绿与浅蓝来回交替、永不停止,但整体上浅蓝格明显多于深绿格。

每一列里“甲投”的比例 vs 理论 $p_n$

每一列中“甲投”的比例与理论值的对比:绿线是理论 p_n,蓝点是 2000 条轨迹中第 n 次由甲投的比例,橙色虚线是平稳概率 \pi=\frac13。蓝点紧贴绿线,几步之后就稳定在 \pi 附近。
图 9每一列中“甲投”的比例与理论值的对比:绿线是理论 $p_n$,蓝点是 2000 条轨迹中第 $n$ 次由甲投的比例,橙色虚线是平稳概率 $\pi=\frac13$。蓝点紧贴绿线,几步之后就稳定在 $\pi$ 附近。
  • 平稳概率 $\pi=\dfrac{1-b}{2-a-b}=\dfrac13$。
  • 一次模拟的结果:第 30 次甲投的频率为 $0.3295$;一条长轨迹(1 万次)中甲投的比例为 $0.3341$。
思路

每一条轨迹都在甲、乙之间随机跳来跳去,永不停止;但同一时刻看 2000 条轨迹,“甲投”的比例很快稳定在 $\pi$。分布收敛,不是轨迹收敛。

思路

无论第 1 次是甲先投($p_1=1$)、乙先投($p_1=0$)还是抽签($p_1=0.5$),曲线起点不同,但几步之后都贴到同一条 $\pi$ 线上——初始状态的影响以 $A^{n-1}$ 的速度被“遗忘”。

吸收型递推(第 23 题)

甲药累计得分的随机游走:到 0 或 8 就停止

甲药累计得分的随机游走:状态 0—8 排成一行,左端 0(红)表示“判乙更有效”,右端 8(绿)表示“判甲更有效”,两端是吸收状态;金色圆圈 4 是起点,向右走一格(得 1 分)的概率 c=\frac1{10},向左走一格(得 -1 分)的概率 a=\frac25,原地不动的概率 b=\frac12。
图 10甲药累计得分的随机游走:状态 0—8 排成一行,左端 0(红)表示“判乙更有效”,右端 8(绿)表示“判甲更有效”,两端是吸收状态;金色圆圈 4 是起点,向右走一格(得 1 分)的概率 $c=\frac1{10}$,向左走一格(得 $-1$ 分)的概率 $a=\frac25$,原地不动的概率 $b=\frac12$。
从各状态出发、最终判甲更有效的概率 p_i:柱 = 理论值,绿点 = 模拟频率,柱下依次标出 p_0,\dots,p_8 的理论值(p_4=0.0039 用橙色强调)。p_1,\dots,p_4 小到几乎看不见柱高,p_i 随 i 增大而迅速上升,在 p_8=1 处达到最大。
图 11从各状态出发、最终判甲更有效的概率 $p_i$:柱 = 理论值,绿点 = 模拟频率,柱下依次标出 $p_0,\dots,p_8$ 的理论值($p_4=0.0039$ 用橙色强调)。$p_1,\dots,p_4$ 小到几乎看不见柱高,$p_i$ 随 $i$ 增大而迅速上升,在 $p_8=1$ 处达到最大。
  • 一轮得分的概率:$a=P(X=-1)=\dfrac25$,$b=P(X=0)=\dfrac12$,$c=P(X=1)=\dfrac1{10}$。
  • 理论 $p_4$(判甲更有效):$\dfrac1{257}\approx0.0039$。
  • 一次模拟(每个起点 2 万次):$p_4$ 的频率为 $0.0036$;从 4 出发平均进行 13.4 轮。

二阶递推 → 相邻差成等比

  1. 一轮中甲药得分 $X$:$P(X=1)=\alpha(1-\beta)=c$,$P(X=-1)=(1-\alpha)\beta=a$,$P(X=0)=b=1-a-c$。

  2. $p_i$:甲累计 $i$ 分时最终判甲更有效的概率。按下一轮得分分类:

    $$p_i=a\,p_{i-1}+b\,p_i+c\,p_{i+1}\quad(1\le i\le7)$$

    边界:$p_0=0,\ p_8=1$。

    两端是“吸收状态”:到达就停止,所以 $p_0$、$p_8$ 已知

  3. 用 $b=1-a-c$ 代入并移项:$(a+c)p_i=ap_{i-1}+cp_{i+1}$,即

    $$c\,(p_{i+1}-p_i)=a\,(p_i-p_{i-1})$$

    把 $p_i$ 拆成 $a\,p_i+c\,p_i$,分别与两边配对

  4. $\{p_{i+1}-p_i\}$ 是公比 $r=\dfrac ac$ 的等比数列。累加:

    $$p_i=(p_1-p_0)(1+r+\cdots+r^{i-1})=p_1\cdot\frac{r^i-1}{r-1}$$

  5. 用 $p_8=1$ 定出 $p_1$:$p_1=\dfrac{r-1}{r^8-1}$,所以

    $$p_i=\frac{r^i-1}{r^8-1}\quad(r\neq1)$$

  6. $\alpha=0.5,\ \beta=0.8$:$a=0.4,\ c=0.1,\ r=4$,

    $$p_4=\frac{4^4-1}{4^8-1}=\frac{1}{4^4+1}=\frac1{257}\approx0.0039$$

    平方差:$4^8-1=(4^4-1)(4^4+1)$

  7. 含义:乙药明显更好时,方案错判“甲更有效”的概率只有约 $0.39\%$,方案合理。

特例:两药一样好

当 $\alpha=\beta$ 时,$r=1$,$p_i=\dfrac i8$,$p_4=\dfrac12$——两药一样好时,判谁更有效都是 $50\%$,也合理。

例题精讲

例 12023 新课标 I 卷

甲、乙两人投篮,每次由其中一人投篮:若命中则此人继续投篮,若未命中则换为对方投篮。甲每次命中率均为 $0.6$,乙均为 $0.8$。第 1 次投篮的人是甲、乙的概率各为 $0.5$。

(1)求第 2 次投篮的人是乙的概率;

(2)求第 $i$ 次投篮的人是甲的概率;

(3)已知:若 $X_i$ 服从两点分布,$P(X_i=1)=q_i$,则 $E\big(\sum_{i=1}^nX_i\big)=\sum_{i=1}^nq_i$。记前 $n$ 次中甲投篮的次数为 $Y$,求 $E(Y)$。

建模思路

状态 = 这一次谁投。下一次谁投只取决于这一次谁投、投没投中——两状态马尔可夫链。全概率公式给出 $p_{i+1}$ 与 $p_i$ 的线性递推。

解析

(1)第 2 次是乙投

  1. 记 $A_i$:第 $i$ 次甲投,$B_i$:第 $i$ 次乙投。按第 1 次谁投分类(全概率公式):

    $$P(B_2)=P(A_1)P(B_2\mid A_1)+P(B_1)P(B_2\mid B_1)$$

  2. $P(B_2\mid A_1)$ = 甲未命中 $=0.4$;$P(B_2\mid B_1)$ = 乙命中 $=0.8$。

    $$P(B_2)=0.5\times0.4+0.5\times0.8=0.6$$

答案:$0.6$

(2)第 $i$ 次是甲投的概率

  1. 记 $p_i=P(A_i)$。第 $i+1$ 次甲投:第 $i$ 次甲投且命中,或第 $i$ 次乙投且未命中:

    $$p_{i+1}=0.6\,p_i+0.2\,(1-p_i)=\frac25p_i+\frac15$$

    乙未命中的概率是 $1-0.8=0.2$,这一项最容易漏

  2. 不动点:$x=\frac25x+\frac15\Rightarrow x^*=\frac13$。两式相减:

    $$p_{i+1}-\frac13=\frac25\Big(p_i-\frac13\Big)$$

  3. $p_1-\frac13=\frac16\neq0$,所以 $\{p_i-\frac13\}$ 是首项 $\frac16$、公比 $\frac25$ 的等比数列:

    $$p_i=\frac13+\frac16\Big(\frac25\Big)^{i-1}$$

    验算:$p_2=\frac13+\frac1{15}=0.4$,与(1)中 $P(B_2)=0.6$ 吻合

答案:$p_i=\dfrac13+\dfrac16\Big(\dfrac25\Big)^{i-1}$

(3)$E(Y)$

  1. 令 $X_i=1$ 表示第 $i$ 次甲投,否则 $X_i=0$。$X_i$ 服从两点分布,$P(X_i=1)=p_i$,且 $Y=\sum_{i=1}^nX_i$。

  2. 由题给结论:

    $$E(Y)=\sum_{i=1}^np_i=\frac n3+\frac16\cdot\frac{1-(2/5)^n}{1-2/5}=\frac n3+\frac5{18}\Big[1-\Big(\frac25\Big)^n\Big]$$

    各 $X_i$ 并不独立,但期望的线性性不需要独立;验算 $n=2$:$0.5+0.4=0.9$,公式 $\frac23+\frac5{18}\cdot\frac{21}{25}=0.9$

答案:$E(Y)=\dfrac{5}{18}\Big[1-\Big(\dfrac25\Big)^n\Big]+\dfrac n3$

易错点

递推式漏掉“乙未命中换甲”的一项,写成 $p_{i+1}=0.6p_i$;或把首项下标搞错($p_1=\frac12$,指数是 $i-1$)。

例 22020 江苏卷

甲口袋中装有 2 个黑球和 1 个白球,乙口袋中装有 3 个白球。现从甲、乙两口袋中各任取一个球交换放入另一口袋,重复 $n$ 次这样的操作。记甲口袋中黑球个数为 $X_n$,恰有 2 个黑球的概率为 $p_n$,恰有 1 个黑球的概率为 $q_n$。

(1)求 $p_1,q_1$ 和 $p_2,q_2$;

(2)求 $2p_n+q_n$ 与 $2p_{n-1}+q_{n-1}$ 的递推关系式和 $E(X_n)$。

建模思路

状态 = 甲袋黑球数 $\in\{0,1,2\}$。黑球总数是 2,甲袋有 $k$ 个黑球时乙袋有 $2-k$ 个,先算出 9 个转移概率,再按上一次的状态分类。

解析

(1)$p_1,q_1,p_2,q_2$

  1. 先列转移概率(甲袋 $k$ 黑 $3-k$ 白,乙袋 $2-k$ 黑 $1+k$ 白):

    • $2\to2$:甲出白、乙出白:$\frac13\times1=\frac13$;$2\to1$:甲出黑:$\frac23$。
    • $1\to2$:甲出白、乙出黑:$\frac23\times\frac13=\frac29$;$1\to0$:甲出黑、乙出白:$\frac13\times\frac23=\frac29$;$1\to1$:$1-\frac29-\frac29=\frac59$。
    • $0\to1$:乙出黑:$\frac23$;$0\to0$:$\frac13$。

    $1\to1$ 有两种:甲白乙白 $(\frac23\cdot\frac23)$ 或甲黑乙黑 $(\frac13\cdot\frac13)$,合计 $\frac59$

  2. 初始为 2 黑:$p_1=\frac13$,$q_1=\frac23$。

  3. 按第 1 次后的状态分类,计算第 2 次:

    $$ \begin{aligned} p_2&=\frac13p_1+\frac29q_1=\frac19+\frac4{27}=\frac7{27}\\ q_2&=\frac23p_1+\frac59q_1=\frac29+\frac{10}{27}=\frac{16}{27} \end{aligned} $$

    第 1 次后甲袋不可能是 0 黑,所以 $q_2$ 里没有 $0\to1$ 这一项

答案:$p_1=\dfrac13,\ q_1=\dfrac23;\ p_2=\dfrac7{27},\ q_2=\dfrac{16}{27}$

(2)递推关系与 $E(X_n)$

  1. 按第 $n-1$ 次后的状态分类:

    $$ \begin{aligned} p_n&=\frac13p_{n-1}+\frac29q_{n-1}\\ q_n&=\frac23p_{n-1}+\frac59q_{n-1}+\frac23(1-p_{n-1}-q_{n-1})=-\frac19q_{n-1}+\frac23 \end{aligned} $$

    甲袋 0 黑的概率是 $1-p-q$,从 0 黑变 1 黑的概率是 $\frac23$

  2. 组合:

    $$2p_n+q_n=\frac23p_{n-1}+\frac49q_{n-1}-\frac19q_{n-1}+\frac23=\frac13(2p_{n-1}+q_{n-1})+\frac23$$

  3. 令 $e_n=2p_n+q_n$,不动点 $x^*=\frac{2/3}{1-1/3}=1$:$e_n-1=\frac13(e_{n-1}-1)$,$e_1-1=\frac23+\frac23-1=\frac13$,

    $$e_n=1+\Big(\frac13\Big)^n$$

  4. $X_n$ 的分布:$P(X_n=2)=p_n$,$P(X_n=1)=q_n$,$P(X_n=0)=1-p_n-q_n$,

    $$E(X_n)=2p_n+q_n=1+\frac1{3^n}$$

    题目让求的 $2p_n+q_n$ 恰好就是期望。$n\to\infty$ 时 $E\to1$:两个黑球平均分在两袋

答案:$2p_n+q_n=\dfrac13(2p_{n-1}+q_{n-1})+\dfrac23$;$E(X_n)=1+\dfrac1{3^n}$

易错点

乙袋的黑球数随甲袋变化(乙袋黑球 $=2-$ 甲袋黑球),不能一直按“乙袋全白”计算。

例 32019 新课标 I 卷

每轮选两只白鼠,随机一只施甲药、另一只施乙药。当一种药治愈的白鼠比另一种多 4 只时停止试验,认为治愈多的药更有效。每轮:甲愈乙未愈则甲药得 1 分、乙药得 $-1$ 分;乙愈甲未愈则甲药得 $-1$ 分;都愈或都未愈均得 0 分。甲、乙治愈率分别为 $\alpha$、$\beta$,一轮中甲药得分为 $X$。

(1)求 $X$ 的分布列;

(2)甲、乙药开始都赋予 4 分,$p_i\ (i=0,1,\dots,8)$ 表示“甲药累计得分为 $i$ 时,最终认为甲药更有效”的概率,则 $p_0=0$,$p_8=1$,$p_i=ap_{i-1}+bp_i+cp_{i+1}\ (i=1,\dots,7)$,其中 $a=P(X=-1)$,$b=P(X=0)$,$c=P(X=1)$。设 $\alpha=0.5$,$\beta=0.8$。

(i) 证明 $\{p_{i+1}-p_i\}\ (i=0,1,\dots,7)$ 为等比数列;

(ii) 求 $p_4$,并根据 $p_4$ 的值解释这种试验方案的合理性。

建模思路

甲药累计得分在 0~8 之间随机游走,到 0 或 8 就停(吸收)。二阶递推 $p_i=ap_{i-1}+bp_i+cp_{i+1}$ 用 $a+b+c=1$ 化成相邻差的等比关系。

解析

(1)$X$ 的分布列

  1. $X=1$:甲愈且乙未愈,$\alpha(1-\beta)$;$X=-1$:乙愈且甲未愈,$(1-\alpha)\beta$。

  2. $X=0$:都愈或都未愈,$\alpha\beta+(1-\alpha)(1-\beta)$。

    $X$ $-1$ $0$ $1$
    $P$ $(1-\alpha)\beta$ $\alpha\beta+(1-\alpha)(1-\beta)$ $\alpha(1-\beta)$

答案:分布列见上表。

(2)(i) 证明等比;(ii) 求 $p_4$

  1. 代入 $\alpha=0.5,\beta=0.8$:$a=0.5\times0.8=0.4$,$b=0.5\times0.8+0.5\times0.2=0.5$,$c=0.5\times0.2=0.1$。

  2. $p_i=0.4p_{i-1}+0.5p_i+0.1p_{i+1}$,把左边 $p_i$ 写成 $0.4p_i+0.1p_i+0.5p_i$,移项:

    $$0.1(p_{i+1}-p_i)=0.4(p_i-p_{i-1})\ \Rightarrow\ p_{i+1}-p_i=4(p_i-p_{i-1})$$

    利用 $a+b+c=1$;$i=1,\dots,7$ 都成立

  3. $p_1-p_0=p_1\neq0$(否则各差全为 0,与 $p_8=1$ 矛盾),所以 $\{p_{i+1}-p_i\}$ 是首项 $p_1$、公比 4 的等比数列。

  4. 累加:$p_8=p_8-p_0=\sum_{i=0}^7(p_{i+1}-p_i)=p_1\cdot\dfrac{4^8-1}{3}=1$,$p_1=\dfrac{3}{4^8-1}$。

  5. 于是

    $$p_4=p_1\cdot\frac{4^4-1}{3}=\frac{4^4-1}{4^8-1}=\frac{1}{4^4+1}=\frac1{257}\approx0.0039$$

    验算:直接迭代求解线性方程组、20 万次模拟均得 $p_4\approx0.0039$

  6. 解释:甲治愈率 0.5 明显低于乙 0.8,此方案得出“甲药更有效”这一错误结论的概率仅约 $0.39\%$,说明方案是合理的。

答案:$p_4=\dfrac1{257}$,错判概率很小,方案合理。

易错点

化简时忘了 $b=1-a-c$,硬解三项递推;或误认为 $\{p_i\}$ 本身是等比数列。

课堂小测

课堂小测

数列满足 $p_{n+1}=0.4p_n+0.2$,$p_1=0.5$。当 $n\to\infty$ 时 $p_n$ 趋于

查看答案与解析

答案B

解析

解 $x=0.4x+0.2$ 得 $x^*=\frac13$;$|A|=0.4<1$,$p_n\to\frac13$,与 $p_1$ 无关。

辨析
  • A:$0.2$ 是常数项 $B$,不是不动点,不动点要解 $x=0.4x+0.2$
  • C:$0.5$ 是初值,$|A|<1$ 时初值的影响会以 $0.4^n$ 的速度消失
  • D:$|A|=0.4<1$,$A^{n-1}\to0$,极限存在。
课堂小测

甲、乙、丙三人传球,从甲开始,每次持球人等可能地传给另外两人之一。传 3 次后球回到甲手中的概率是

查看答案与解析

答案A

解析

$p_{n+1}=\frac12(1-p_n)$:$p_0=1,\ p_1=0,\ p_2=\frac12,\ p_3=\frac14$。

辨析
  • B:$\frac13$ 是极限(平稳概率),不是第 3 次的值
  • C:$\frac38$ 是传 4 次后的概率 $p_4=\frac12\big(1-\frac14\big)$
  • D:$\frac12$ 是传 2 次后的概率 $p_2$。
课堂小测

把 $p_{n+1}=\dfrac25p_n+\dfrac15$ 化为等比数列,正确的是

查看答案与解析

答案C

解析

不动点 $x^*=\frac{1/5}{1-2/5}=\frac13$,两式相减得公比 $\frac25$。

辨析
  • A:把常数项 $\frac15$ 当成了不动点;验证:代入后常数项是 $\frac15\big(1-\frac25\big)=\frac3{25}\neq\frac15$
  • B:符号反了,展开得 $p_{n+1}=\frac25p_n-\frac15$
  • D:公比应为 $A=\frac25$,展开得 $p_{n+1}=\frac15p_n+\frac4{15}$,与原式不同。
专题 10

期望决策:把每个方案的“平均代价”算出来再比较

每个方案对应一个随机变量(费用或收益)。以期望为依据,就是比较这些随机变量的均值;参数一变,最优方案可能在某个切换点换人。期望之外,方差衡量风险。

看见:检不检?切换点在哪

一箱 200 件,已检 20 件,余下 180 件检还是不检(第 13 题)

设每件检验费为 $c$ 元,不合格品每件赔偿 $r$ 元,余下 180 件的不合格率为 $p$。两个方案的费用为:

  • 不检余下:$E=20c+180\,r\,p$;
  • 全部检验:$200c$。
不检与全检的期望费用随不合格率 p 变化(取 c=2,\ r=25):红线为不检余下的期望费用 20c+180rp,绿线为全检费用 200c;橙点为两线交点,即切换点 p^*=c/r=0.08,左侧粉色区域不检更省,右侧绿色区域全检更省;红点、绿点标出 p=0.1 时的 490 元与 400 元
图 1不检与全检的期望费用随不合格率 $p$ 变化(取 $c=2,\ r=25$):红线为不检余下的期望费用 $20c+180rp$,绿线为全检费用 $200c$;橙点为两线交点,即切换点 $p^*=c/r=0.08$,左侧粉色区域不检更省,右侧绿色区域全检更省;红点、绿点标出 $p=0.1$ 时的 490 元与 400 元

切换点为 $p^*=\dfrac cr=0.08$。当 $p=0.1$ 时,不检余下的期望费用 $E=490$ 元,全检费用 $400$ 元,$E(\text{不检})-\text{全检}=90$ 元 $>0$:应全检。

“不检”的费用是随机的:看它的分布

p=0.1 时“不检”方案费用 X 的分布(直方图):绿色柱对应 X<400(不检反而比全检更省),红色柱对应 X>400;绿色虚线为全检费用 400 元,红色虚线为期望 E(X)=490 元
图 2$p=0.1$ 时“不检”方案费用 $X$ 的分布(直方图):绿色柱对应 $X<400$(不检反而比全检更省),红色柱对应 $X>400$;绿色虚线为全检费用 400 元,红色虚线为期望 $E(X)=490$ 元

此时 $X$ 的标准差 $\sigma(X)\approx100.62$ 元;“不检反而更省”的概率 $P(X<400)\approx0.1943$;费用超过 $E(X)+100$ 的概率 $P(X>E(X)+100)\approx0.1330$。

思路

期望是“很多箱平均下来”每箱的费用。对某一箱来说,不检也可能运气好、花得更少;但工厂每天处理大量箱子,按期望决策,长期总费用最低。

不检方案的费用

$X=20c+rY$,$Y\sim B(180,p)$:

$$E(X)=20c+180rp,\qquad D(X)=r^2\cdot180p(1-p)$$

推导:决策的一般步骤

期望决策的四步

  1. 列方案:明确有哪几个可选方案,以及决策依据是“费用期望最小”还是“收益期望最大”。

    第 13 题:方案一不检余下,方案二全检;依据是“检验费 + 赔偿费”的期望

  2. 设随机变量:每个方案的费用写成随机变量。常见结构:

    $$X=\text{固定部分}+\text{单价}\times\text{随机件数}$$

    $X=20c+rY$,$Y$ 为余下 180 件中的不合格品数

  3. 求期望:用线性性 $E(aY+b)=aE(Y)+b$,配合二项分布 $E(Y)=np$,往往不必列分布列。

    $$E(X)=20c+r\cdot180p$$

  4. 比较:全检费用 $200c$ 是确定的。

    $$E(X)>200c\iff 180rp>180c\iff p>\frac cr$$

    两边公共的 $20c$ 约掉;不合格率超过“检验费 / 赔偿费”就该全检

  5. 第 13 题:$c=2$,$r=25$,$p^*=0.08$;$p_0=0.1>0.08$,应全检。$E(X)=40+25\times18=490>400$。

  6. 参数从哪来:$p$ 未知时,用样本估计。20 件中 2 件不合格,让 $f(p)=\mathrm{C}_{20}^2p^2(1-p)^{18}$ 最大的 $p_0=0.1$ 就是“最能解释观测结果”的值。

    这是极大似然估计的思想(见下图)。不论 $k$ 取多少,最大值点都是样本比例 $k/20$

  7. 切换点的意义:决策结论依赖参数。报告“在 $p>p^*$ 时选方案二”比只给一个答案更有用。

样本中 $k$ 件不合格,$p$ 取多少最“像”?

20 件样本中恰有 2 件不合格时的似然函数 f(p)=\mathrm{C}_{20}^2p^2(1-p)^{18}(紫色曲线):橙点为最大值点 p_0=0.1,恰好等于样本不合格率 2/20
图 320 件样本中恰有 2 件不合格时的似然函数 $f(p)=\mathrm{C}_{20}^2p^2(1-p)^{18}$(紫色曲线):橙点为最大值点 $p_0=0.1$,恰好等于样本不合格率 $2/20$

$$ \begin{aligned} f(p)&=\mathrm{C}_{20}^{2}p^{2}(1-p)^{18}\\ f'(p)&=\mathrm{C}_{20}^{2}\,p(1-p)^{17}(2-20p)\\ p_0&=\frac{2}{20}=0.1,\quad f(p_0)\approx0.2852 \end{aligned} $$

一般地,20 件中有 $k$ 件不合格时,$f(p)=\mathrm{C}_{20}^{k}p^{k}(1-p)^{20-k}$ 的最大值点总是样本比例 $p_0=\dfrac k{20}$;$k=0$ 时 $f(p)=(1-p)^{20}$ 单调递减,最大值点在 $p\to0$ 处。

混检:$k$ 取多少最省

每 $k$ 人混检一次:人均检测次数

阳性率 p=0.02 时,每 k 人一组混检的人均检测次数 e(k)(k=1 即逐个检测):红色虚线为逐个检测的 1 次;橙色柱为最优组大小 k^*=8,此时人均期望次数 e(8)\approx0.2742,1000 人期望总次数约 274.2
图 4阳性率 $p=0.02$ 时,每 $k$ 人一组混检的人均检测次数 $e(k)$($k=1$ 即逐个检测):红色虚线为逐个检测的 1 次;橙色柱为最优组大小 $k^*=8$,此时人均期望次数 $e(8)\approx0.2742$,1000 人期望总次数约 274.2
最优组大小 k^* 随阳性率 p 变化的阶梯曲线(纵轴 1 表示逐个检):p 越小,最优组越大;橙点为 p=0.02 时的 k^*=8;红色虚线为 p\approx0.307,此后混检不再优于逐个检
图 5最优组大小 $k^*$ 随阳性率 $p$ 变化的阶梯曲线(纵轴 1 表示逐个检):$p$ 越小,最优组越大;橙点为 $p=0.02$ 时的 $k^*=8$;红色虚线为 $p\approx0.307$,此后混检不再优于逐个检

推导与模拟

  1. 一组 $k$ 人,组内全阴的概率 $(1-p)^k$。该组次数 $\xi\in\{1,\ k+1\}$:

    $$ \begin{aligned} E(\xi)&=(1-p)^k+(k+1)\big[1-(1-p)^k\big]\\ &=k+1-k(1-p)^k \end{aligned} $$

  2. 人均:

    $$e(k)=\frac{E(\xi)}{k}=1+\frac1k-(1-p)^k$$

    $\dfrac1k$:混检那 1 次分摊到每人;$1-(1-p)^k$:自己被迫再单检一次的概率

  3. 两种力量拉扯:$k$ 大,$\dfrac1k$ 小(省混检);但 $(1-p)^k$ 也变小(更容易整组重检)。所以存在最优 $k$。

  4. 混检优于逐个检 $\iff e(k)<1\iff (1-p)^k>\dfrac1k$。$k=3$ 时最宽松,得 $p<1-\sqrt[3]{1/3}\approx0.3066$;超过它就应逐个检。

    $k=2$ 时要 $(1-p)^2>\tfrac12$,即 $p<0.293$;$k=3$ 时 $p<0.3066$;$k=4$ 与 $k=2$ 相同;$k\ge5$ 时更严

一次模拟:1000 人排成 50×20 的方格,每格一人,p=0.02,每 8 人一组混检。红格为阳性者,橙格为所在组混检呈阳性、需逐个重检的阴性者,浅绿格为混检阴性的组;绝大多数组一次检测即可放行,总检测次数在理论期望 274.2 次附近波动
图 6一次模拟:1000 人排成 50×20 的方格,每格一人,$p=0.02$,每 8 人一组混检。红格为阳性者,橙格为所在组混检呈阳性、需逐个重检的阴性者,浅绿格为混检阴性的组;绝大多数组一次检测即可放行,总检测次数在理论期望 274.2 次附近波动

辨析:期望大,风险也大

两种投资方案(单位:万元)

稳健方案 A 激进方案 B($q=0.5$)
结果 盈利 2(0.9),亏损 1(0.1) 盈利 8(0.5),亏损 4(0.5)
期望 $E$ 1.7 2.00
方差 $D$ 0.81 36.00
亏损概率 0.1 0.5

只看期望选 B(多 0.30),但 B 的方差是 A 的 44 倍。

30 人各按方案 A、方案 B 连续投资 10 年的累计收益模拟(q=0.5,每人一条折线):蓝线为 B,绿线为 A,右端标出两组末期平均值;蓝线散得很开,绿线则挤在一起。第 10 年末累计亏损的人数:A 为 0/30,B 为 3/30
图 730 人各按方案 A、方案 B 连续投资 10 年的累计收益模拟($q=0.5$,每人一条折线):蓝线为 B,绿线为 A,右端标出两组末期平均值;蓝线散得很开,绿线则挤在一起。第 10 年末累计亏损的人数:A 为 0/30,B 为 3/30

期望之外,还要看方差

  1. A:$E(A)=2\times0.9+(-1)\times0.1=1.7$,$D(A)=(2-1.7)^2\times0.9+(-1-1.7)^2\times0.1=0.81$。
  2. B:$E(B)=8q-4(1-q)=12q-4$,$D(B)=(8-(-4))^2q(1-q)=144q(1-q)$。

    两点分布 $X\in\{x_1,x_2\}$:$D(X)=(x_1-x_2)^2q(1-q)$

  3. 切换点:$E(B)>E(A)\iff12q-4>1.7\iff q>0.475$。

    只看期望,$q$ 超过 0.475 就选 B

  4. 但 $q=0.5$ 时 $E(B)=2$ 只比 1.7 多一点,$D(B)=36$ 却是 $D(A)$ 的 44 倍,亏损概率 0.5 对 0.1。
  5. 决策原则:题目说“以期望为依据”就只比期望;期望相同或接近时,比较方差,方差小的更稳定、风险小;若承受不起亏损,宁可放弃少量期望收益。
注意

上图的模拟中,蓝线(B)末端散得很开,有人赚得多,也有人亏得多;绿线(A)挤在一起,几乎都稳定增长。两组平均值接近,体验完全不同。

例题精讲

投篮两阶段(2024 新课标 II 卷)

例 12024 新课标全国 II 卷

第一阶段由一名队员投 3 次,3 次都不中则淘汰(0 分);至少中 1 次则进入第二阶段,由另一名队员投 3 次,每中一次得 5 分。甲每次投中概率 $p$,乙为 $q$,各次独立。

(1)$p=0.4,\ q=0.5$,甲打第一阶段,求成绩不少于 5 分的概率;

(2)设 $0<p<q$:(i) 要使得 15 分的概率最大,谁打第一阶段?(ii) 要使成绩期望最大,谁打第一阶段?

建模思路

两阶段相互独立 → 概率相乘。“至少中一次”用对立事件 $1-(1-p)^3$。比较两种安排:作差、因式分解、判断每个因子的符号。

解析

(1)成绩不少于 5 分

  1. 进入第二阶段:$1-0.6^3=0.784$。
  2. 第二阶段至少中 1 次:$1-0.5^3=0.875$。

    “不少于 5 分”= 第二阶段至少中一次

  3. 两阶段独立:$P=0.784\times0.875=0.686$。

答案:$0.686$

(2)(i) 15 分的概率

  1. 甲先:$P_\text{甲}=[1-(1-p)^3]\,q^3$;乙先:$P_\text{乙}=[1-(1-q)^3]\,p^3$。

  2. 展开 $1-(1-p)^3=3p-3p^2+p^3$,$p^3q^3$ 项两边相同,作差后抵消:

    $$P_\text{甲}-P_\text{乙}=q^3(3p-3p^2)-p^3(3q-3q^2)$$

  3. 整理:

    $$ \begin{aligned} P_\text{甲}-P_\text{乙}&=3pq\big[q^2(1-p)-p^2(1-q)\big]\\ &=3pq\big[(q^2-p^2)-pq(q-p)\big]\\ &=3pq(q-p)(p+q-pq) \end{aligned} $$

    与参考答案中的写法 $3pq(p-q)(pq-p-q)$ 是同一个式子

  4. $q-p>0$;$p+q-pq=1-(1-p)(1-q)>0$。所以差为正,甲打第一阶段。

答案:甲参加第一阶段

(2)(ii) 成绩的期望

  1. 第二阶段若由乙投,得分 $5Y$,$Y\sim B(3,q)$,期望 $15q$。所以 $E_\text{甲先}=15q\,[1-(1-p)^3]$。

    先算条件期望,再乘进入第二阶段的概率

  2. 同理 $E_\text{乙先}=15p\,[1-(1-q)^3]$。作差:

    $$ \begin{aligned} E_\text{甲先}-E_\text{乙先}&=15pq\big[(3-3p+p^2)-(3-3q+q^2)\big]\\ &=15pq(q-p)(3-p-q) \end{aligned} $$

  3. $q-p>0$,$3-p-q>1>0$,差为正,甲打第一阶段。

答案:甲参加第一阶段

易错

漏掉“必须先通过第一阶段”;或把 15 分写成 3 次中至少 1 次。直觉:命中率低的人去“拿门票”,命中率高的人去“拿分”。

亚运盲盒(有放回计数 + 期望决策)

例 22024 广州调研 (B)

盲盒 19 元一个,随机装三款吉祥物之一(等可能);直接购买 30 元一个。

(1)逐个购买盲盒,首次出现相同款式时的购买次数为 $X$,求 $X$ 的分布列;

(2)为集齐三款,先一次性买不超过 3 个盲盒,未集齐再直接购买。以期望费用为依据,应买几个盲盒?

建模思路

买 $n$ 个盲盒 = 有放回抽 $n$ 次,等可能的样本点是长度为 $n$ 的款式序列,$n(\Omega)=3^n$。

解析

(1)$X$ 的分布列

  1. $X\in\{2,3,4\}$:只有 3 款,第 4 个必然与前面重复。

    抽屉原理

  2. $P(X=2)$:第 2 个与第 1 个相同,$\dfrac{3\times1}{3^2}=\dfrac13$。

  3. $P(X=3)$:前两个不同、第三个与其中之一相同,$\dfrac{\mathrm{A}_3^2\times2}{3^3}=\dfrac49$。

  4. $P(X=4)$:前三个各不相同,$\dfrac{\mathrm{A}_3^3}{3^3}=\dfrac29$。

    $X$ 2 3 4
    $P$ $\frac13$ $\frac49$ $\frac29$

(2)买几个盲盒

  1. 买 0 个:$90$ 元;买 1 个:$19+60=79$ 元。
  2. 买 2 个:不同款 $\dfrac{\mathrm{A}_3^2}{9}=\dfrac23$,花 $38+30=68$ 元;同款 $\dfrac13$,花 $38+60=98$ 元。$E=68\cdot\dfrac23+98\cdot\dfrac13=78$。
  3. 买 3 个:全不同 $\dfrac{6}{27}=\dfrac29$,花 57 元;恰两款 $\dfrac{\mathrm{C}_3^1\mathrm{C}_2^1\mathrm{C}_3^2}{27}=\dfrac{18}{27}=\dfrac23$,花 87 元;全相同 $\dfrac{3}{27}=\dfrac19$,花 117 元。

    恰两款:选重复的款 × 选另一款 × 重复款占哪两个位置

  4. $E=57\cdot\dfrac29+87\cdot\dfrac23+117\cdot\dfrac19=\dfrac{251}3\approx83.7$。
  5. 比较 $90,\ 79,\ 78,\ 83.7$:买 2 个盲盒期望费用最低。

答案:一次性买 2 个盲盒

易错

把“款式组合”当样本点(如 3 个盲盒的 {全同, 两款, 三款}),它们不等可能。

是否全箱检验

例 32018 新课标 I 卷

某产品每箱 200 件,交付前先从一箱中任取 20 件检验,再决定是否检验余下所有产品。检出的不合格品更换为合格品。每件产品为不合格品的概率都为 $p\ (0<p<1)$,相互独立。

(1)记 20 件中恰有 2 件不合格品的概率为 $f(p)$,求 $f(p)$ 的最大值点 $p_0$;

(2)对一箱检验了 20 件,恰有 2 件不合格品,以 $p_0$ 作为 $p$ 的值。每件检验费 2 元;不合格品进入用户手中,每件赔偿 25 元。(i) 若不检验余下产品,这一箱的检验费与赔偿费之和记为 $X$,求 $E(X)$;(ii) 以费用和的期望为依据,是否该检验余下所有产品?

建模思路

(1)“哪个 $p$ 最能解释观测到的 2/20”——求导找最大值点(极大似然的思想)。(2)两个方案各算总费用的期望,取小者。

解析

(1)$f(p)$ 的最大值点

  1. $f(p)=\mathrm{C}_{20}^2p^2(1-p)^{18}$,$0<p<1$。

  2. 求导:

    $$f'(p)=\mathrm{C}_{20}^2\big[2p(1-p)^{18}-18p^2(1-p)^{17}\big]=2\mathrm{C}_{20}^2\,p(1-p)^{17}(1-10p)$$

    提出公因式 $2p(1-p)^{17}$,剩下 $(1-p)-9p=1-10p$

  3. $0<p<0.1$ 时 $f'(p)>0$;$0.1<p<1$ 时 $f'(p)<0$。所以 $p_0=0.1$。

    恰好等于样本中的不合格率 $2/20$

答案:$p_0=0.1$

(2)(i) $E(X)$;(ii) 是否全检

  1. 余下 180 件中不合格品数 $Y\sim B(180,0.1)$,$E(Y)=18$。

  2. 不检余下产品:已检 20 件花费 40 元固定,$X=40+25Y$,

    $$E(X)=40+25E(Y)=40+450=490$$

    期望的线性性 $E(aY+b)=aE(Y)+b$;已检 20 件中的不合格品已更换,不产生赔偿

  3. 检验余下所有产品:共检 200 件,费用 $200\times2=400$ 元,且不会有赔偿。

  4. $400<490$,应该对余下所有产品作检验。

    一般地,对 180 件:全检 360 元 vs 赔偿期望 $180\cdot25p$ 元,$p>\dfrac2{25}=0.08$ 时全检更省

答案:(i) $E(X)=490$;(ii) 应该检验

易错

漏算已检 20 件的 40 元;或用 200 件计算赔偿期望(已检的 20 件已经换成合格品)。

疫苗试验的注射次数

例 42021 泰州考前练笔

一组 10 只动物进行疫苗试验。第一轮对每只动物各注射一次,若有 9 只或 10 只产生抗体,则疫苗有效,试验终止;否则对没有产生抗体的动物进行第二轮注射。每只动物是否产生抗体相互独立,两次注射互不影响,产生抗体的概率均为 $p\ (0<p<1)$。

(1)求该组试验只需第一轮注射的概率(用含 $p$ 的多项式表示);

(2)记该组动物需要注射次数 $X$ 的数学期望为 $E(X)$,求证:$10<E(X)<10(2-p)$。

建模思路

$X=10+$(第二轮补打的针数)。补打针数 = 未产生抗体的只数,但未产生抗体只有 0 或 1 只时不补打。用期望的线性性,不必列 $X$ 的分布列。

解析

(1)只需第一轮的概率

  1. 第一轮产生抗体的只数 $Y\sim B(10,p)$。只需第一轮 $\iff Y\ge9$。
  2. $$P(Y\ge9)=\mathrm{C}_{10}^9p^9(1-p)+p^{10}=10p^9-9p^{10}$$

答案:$10p^9-9p^{10}$

(2)证明 $10<E(X)<10(2-p)$

  1. 设 $m=10-Y$ 为未产生抗体的只数,$m\sim B(10,1-p)$。补打针数 $Z=\begin{cases}m,&m\ge2\\0,&m\le1\end{cases}$,$X=10+Z$。

  2. $Z=m-\mathbf{1}\{m=1\}$($m=1$ 时本该补 1 针却不补;$m=0$ 时本来就是 0),所以

    $$E(Z)=E(m)-P(m=1)=10(1-p)-10(1-p)p^9$$

    $P(m=1)=\mathrm{C}_{10}^1(1-p)p^9$

  3. $$E(X)=10+10(1-p)(1-p^9)$$

    验算:$p=0.7$ 时按分布列逐项求和得 12.8789,与公式一致

  4. $0<p<1$ 时 $(1-p)(1-p^9)>0$,故 $E(X)>10$。

  5. 又 $E(X)=10+10(1-p)-10(1-p)p^9=10(2-p)-10(1-p)p^9<10(2-p)$。证毕。

    $10(2-p)$ 是“无论如何都补打所有未产生抗体的动物”时的期望针数,终止规则只会减少针数

答案:$E(X)=10+10(1-p)(1-p^9)$,两边不等式成立

易错

把 $m=1$ 的情形也算进补打;或试图列出 $X=10,12,13,\dots,20$ 的分布列逐项求和,计算量过大。

课堂小测

课堂小测

阳性率 $p=0.1$,每 4 人混检一组(阴性检 1 次,阳性再逐个检)。一组检测次数的期望是($0.9^4=0.6561$)

查看答案与解析

答案A

解析

$E(\xi)=1\times0.6561+5\times0.3439=5-4\times0.6561=2.3756$。

辨析
  • B:阳性组共检 $1+4=5$ 次,不是 4 次,这个答案漏了最初那 1 次混检
  • C:$0.5939$ 是人均次数 $2.3756/4$,题目问的是一组
  • D:4 是逐个检测的次数,混检的期望更小。
课堂小测

第 13 题中,若以 $p=0.05$ 作为不合格率(其他条件不变),则

查看答案与解析

答案B

解析

$E(X)=40+225=265<400$;也可直接看 $p=0.05<p^*=0.08$。

辨析
  • A:$E(X)=40+25\times180\times0.05=265<400$,全检反而更贵
  • C:2 和 25 只决定切换点 $p^*=0.08$,结论还取决于 $p$
  • D:有不合格品的风险已经计入了期望赔偿 $25\times180p$,以期望为依据时不检更省。
课堂小测

方案甲、乙收益的期望都是 5 万元,方差分别为 1 和 9。下列说法正确的是

查看答案与解析

答案D

解析

期望相同时比较方差:甲的方差小,收益更稳定,风险更小。

辨析
  • A:方差大说明波动大,并不意味着平均收益更高,两者期望相同
  • B:期望相同只说明“平均”一样,风险(波动)可以完全不同
  • C:方差不能为负,也不能单独决定好坏,收益期望相同时才用方差比较稳定性。
专题 11

频率直方图与百分位数:面积就是频率

纵轴取“频率/组距”,每个矩形的面积恰好是该组的频率。平均数、中位数、百分位数都能在面积上读出来。

看见:组距可调的直方图

200 个样本数据(范围 $40\sim100$)的频率分布直方图

200 个样本数据的频率分布直方图(组距 10,共 6 组)。纵轴为“频率/组距”,每个矩形的面积等于该组频率;横轴下方的小竖线是 200 个原始数据。
图 1200 个样本数据的频率分布直方图(组距 10,共 6 组)。纵轴为“频率/组距”,每个矩形的面积等于该组频率;横轴下方的小竖线是 200 个原始数据。

图中共有 $6$ 组,组距为 $10$,所有矩形的面积之和为 $1.0000$。

为什么纵轴用“频率/组距”?

矩形面积 = 组距 × 高 = 频率,于是面积总和恒为 $1$,与组距无关。若改用“频率”作纵轴,组距变大时矩形整体变高,图的“高度”就失去了可比性。

注意

组距太小:矩形参差不齐,被偶然波动主导;组距太大:细节被抹平(例如双峰被合成一个峰)。教材建议组数一般取 $5\sim12$ 组。

数据呈双峰分布时,直方图上能看到两个高峰:

同样取组距 10,数据为双峰分布时的直方图:[50,60) 与 [80,90) 两组各成一个高峰,中间 [60,70) 一组明显低下去。
图 2同样取组距 10,数据为双峰分布时的直方图:$[50,60)$ 与 $[80,90)$ 两组各成一个高峰,中间 $[60,70)$ 一组明显低下去。

推导:由直方图估计数字特征

每一个估计都来自“组内均匀”的假设

  1. 设共有 $k$ 组,第 $i$ 组 $[t_{i-1},t_i)$ 的组中值为 $x_i$,高为 $h_i$,组距为 $w$,则频率 $$f_i=h_i\,w,\qquad \sum_{i=1}^k f_i=1$$

    纵轴是“频率/组距”,所以频率 = 高 × 组距 = 面积

  2. 平均数:原始数据丢失了,只知道每组有多少比例。用组中值代表组内每个数据: $$\bar x\approx\sum_{i=1}^k x_i f_i$$

    若组内数据均匀分布,组内平均正好是组中值,这个估计就是精确的

  3. 中位数 $m$:左右两边各占一半的数据,即竖线 $x=m$ 左侧面积为 $0.5$。设前 $j-1$ 组累计频率 $F_{j-1}<0.5\le F_j$,则 $$F_{j-1}+(m-t_{j-1})h_j=0.5\ \Rightarrow\ m=t_{j-1}+\frac{0.5-F_{j-1}}{h_j}$$

    组内均匀:在第 $j$ 组截取宽度 $m-t_{j-1}$,面积 = 宽 × 高

  4. 众数:出现最多的值所在的组 = 最高的矩形,取它底边的中点作为估计。
  5. 第 $p$ 百分位数:把第 3 步中的 $0.5$ 换成 $p\%$:左侧面积为 $p\%$ 的竖线位置。中位数 = 第 $50$ 百分位数。
  6. 方差:同样用组中值代表组内数据: $$s^2\approx\sum_{i=1}^k f_i(x_i-\bar x)^2=\sum_{i=1}^k f_ix_i^2-\bar x^2$$

    展开平方:$\sum f_i(x_i^2-2x_i\bar x+\bar x^2)=\sum f_ix_i^2-2\bar x^2+\bar x^2$,用到 $\sum f_i=1$、$\sum f_ix_i=\bar x$

  7. 三者的位置关系:对称时平均数 $\approx$ 中位数 $\approx$ 众数;右偏(长尾在右)时平均数 $>$ 中位数;左偏时平均数 $<$ 中位数。

    平均数是“重心”,会被远处的少数大值拉过去;中位数只看“排位”,不受极端值的大小影响

直方图估计 vs 原始数据的真实值

下图以第一节的数据(组距 10)为例。绿线:平均数估计;橙线:中位数估计(左侧面积 $0.5$);紫线:众数估计。

用直方图(组距 10)估计数字特征:绿线为平均数估计 70.9,橙线为中位数估计 70.31(浅黄色部分是它左侧面积 0.5),紫线为众数估计 65(最高组 [60,70) 的中点)。
图 3用直方图(组距 10)估计数字特征:绿线为平均数估计 70.9,橙线为中位数估计 70.31(浅黄色部分是它左侧面积 0.5),紫线为众数估计 65(最高组 $[60,70)$ 的中点)。
直方图估计(组距 10) 原始数据
平均数 $70.9$ $70.72$
中位数 $70.31$ $70.25$
众数 $65$(最高组 $[60,70)$ 中点) —(原始数据几乎不重复)
方差 $99.19$ $90.42$
标准差 $9.96$ $9.51$
提示

估计误差来自“组内均匀”的假设;组距越小,估计一般越接近原始数据的真实值。众数估计最依赖分组,组距一变它就可能跳动。

百分位数:定义与插值

原始数据的百分位数(高中定义)

以 $n=10$ 的一组数据为例,已按从小到大排好:

序号 $1$ $2$ $3$ $4$ $5$ $6$ $7$ $8$ $9$ $10$
数据 $50$ $52$ $58$ $69$ $73$ $73$ $83$ $84$ $90$ $94$
  1. 第一步:把数据从小到大排列:$x_{(1)}\le x_{(2)}\le\cdots\le x_{(n)}$。
  2. 第二步:计算 $i=n\times p\%$。
  3. 第三步:$i$ 不是整数,取第 $\lceil i\rceil$ 项;$i$ 是整数,取第 $i$ 项与第 $i+1$ 项的平均数。

    整数时,第 $i$ 项与第 $i+1$ 项之间“恰好”切开 $p\%$ 与 $(100-p)\%$,取中点最公平

对上面这组数据取 $p=25$:

$$i=10\times25\%=2.5\ \text{不是整数}\Rightarrow x_{25}=x_{(3)}=58$$

由直方图估计百分位数:累计面积 $=p\%$

第一节数据(组距 10)的累计频率折线:绿点为各组右端点处的累计频率;橙色虚线从纵轴 0.8 水平画到折线,再垂直落到横轴,落点 79.54 即第 80 百分位数的估计。
图 4第一节数据(组距 10)的累计频率折线:绿点为各组右端点处的累计频率;橙色虚线从纵轴 0.8 水平画到折线,再垂直落到横轴,落点 79.54 即第 80 百分位数的估计。

第 $80$ 百分位数落在 $[70,80)$ 内,于是

$$ \begin{aligned} &0.49+(x-70)\times0.0325=0.80\\ &\Rightarrow x=70+\frac{0.80-0.49}{0.0325}\approx79.54 \end{aligned} $$

(原始数据的第 $80$ 百分位数为 $79.45$。)

思路

上图是第一节数据的累计频率折线(组距 10)。组内均匀 $\Rightarrow$ 累计频率在每组内是一条直线段,所以求百分位数就是在这条折线上线性插值:从纵轴 $p\%$ 水平画过去,碰到折线再垂直落到横轴。

方差与标准差:离散程度

平均数相同,离散程度不同:甲、乙各射击 10 次

甲的 10 次成绩为 $7,7,8,8,8,8,8,8,9,9$,乙的 10 次成绩为 $5,6,7,8,8,8,9,9,10,10$。

甲、乙各射击 10 次的成绩点图(横轴为环数):绿点是甲,蓝点是乙,竖直虚线是各自的平均数 8,红色横线是每个数据到平均数的偏差。甲的点紧挨着均值,乙的点散得很开。
图 5甲、乙各射击 10 次的成绩点图(横轴为环数):绿点是甲,蓝点是乙,竖直虚线是各自的平均数 8,红色横线是每个数据到平均数的偏差。甲的点紧挨着均值,乙的点散得很开。
$\bar x$ $s^2$ $s$
甲 $8$ $0.4$ $0.632$
乙 $8$ $2.4$ $1.549$
提示

方差 $s^2=\dfrac1n\sum(x_i-\bar x)^2$ 是偏差平方的平均;标准差 $s=\sqrt{s^2}$ 与数据单位相同,可以直接说“平均偏离均值约多少环”。若作变换 $y=ax+b$,则 $\bar y=a\bar x+b$,$s_y^2=a^2s_x^2$,$s_y=|a|\,s_x$——平移不改变离散程度。

谁对极端值敏感?

同一数轴比较最后一个数据由 75 变为 150:绿色点为其余数据,红点为改变的数据;橙色竖线/方框表示中位数/四分位区间,蓝色虚线/方框表示平均数/\bar x\pm s。平均数与标准差明显增大,中位数由 72 变为 72,四分位区间由 67\sim75 变为 67\sim76;上图对应下文读数。
图 6同一数轴比较最后一个数据由 75 变为 150:绿色点为其余数据,红点为改变的数据;橙色竖线/方框表示中位数/四分位区间,蓝色虚线/方框表示平均数/$\bar x\pm s$。平均数与标准差明显增大,中位数由 72 变为 72,四分位区间由 $67\sim75$ 变为 $67\sim76$;上图对应下文读数。

此时:平均数 $71.4$,中位数 $72$,标准差 $5.03$,第 $25\sim75$ 百分位数为 $67\sim75$。

注意

最后一个数据变得很大时,平均数和标准差被明显拉动,中位数和四分位数纹丝不动。所以收入、房价这类有极端值的数据常报告中位数。

例题精讲

例 12023 全国新课标 II 卷

某疾病的患病者与未患病者某项医学指标的频率分布直方图如下(组距 5)。确定临界值 $c$:指标大于 $c$ 判为阳性,小于或等于 $c$ 判为阴性。漏诊率 $p(c)$:患病者被判阴性的概率;误诊率 $q(c)$:未患病者被判阳性的概率。假设数据在组内均匀分布,以频率作为概率。

(1)当 $p(c)=0.5\%$ 时,求 $c$ 和 $q(c)$;

(2)设 $f(c)=p(c)+q(c)$,求 $c\in[95,105]$ 时 $f(c)$ 的解析式及最小值。

患病者的指标频率分布直方图:组 [95,100),[100,105),\dots,[125,130],纵轴“频率/组距”,高依次为 0.002,0.012,0.034,0.036,0.040,0.040,0.036。
图 7患病者的指标频率分布直方图:组 $[95,100),[100,105),\dots,[125,130]$,纵轴“频率/组距”,高依次为 $0.002,0.012,0.034,0.036,0.040,0.040,0.036$。
未患病者的指标频率分布直方图:组 [70,75),[75,80),\dots,[100,105],纵轴“频率/组距”,高依次为 0.038,0.040,0.040,0.036,0.034,0.010,0.002;各矩形面积为相应组的频率。
图 8未患病者的指标频率分布直方图:组 $[70,75),[75,80),\dots,[100,105]$,纵轴“频率/组距”,高依次为 $0.038,0.040,0.040,0.036,0.034,0.010,0.002$;各矩形面积为相应组的频率。
建模思路

直方图里“概率 = 面积”。$p(c)$ 是患病者图在 $c$ 左边的面积,$q(c)$ 是未患病者图在 $c$ 右边的面积。“组内均匀分布”保证部分矩形的面积 = 高 × 截取的宽度,于是 $p,q$ 都是 $c$ 的分段一次函数。

解析

(1)求 $c$ 与 $q(c)$

  1. 患病者第一组 $[95,100)$ 面积 $0.002\times5=0.01=1\%>0.5\%$,所以 $c\in(95,100)$。

    先判断 $c$ 落在哪一组:累计面积首次超过 $0.5\%$ 的那一组

  2. $p(c)=(c-95)\times0.002=0.005\Rightarrow c=97.5$。

    组内均匀:截取的宽度 × 高 = 截取的面积

  3. $q(97.5)$ 是未患病者图在 $97.5$ 右边的面积:$[97.5,100)$ 一段加 $[100,105]$ 整组: $$q=(100-97.5)\times0.010+5\times0.002=0.025+0.010=0.035$$

答案:$c=97.5$,$q(c)=3.5\%$

(2)$f(c)$ 的解析式与最小值

  1. $95\le c\le100$:$p(c)=0.002(c-95)$;$q(c)=0.010(100-c)+0.010$。

    $q(c)$ = $[c,100)$ 这一段 + $[100,105]$ 整组面积 $0.002\times5$

  2. 于是 $$f(c)=0.002c-0.19+1.01-0.01c=-0.008c+0.82$$

    注意 $q(c)=1.01-0.01c$($0.010\times100+0.010=1.01$),不要写成 $0.01-0.01c+1.1$;最终结果正确

  3. $100<c\le105$:$p(c)=0.01+0.012(c-100)$;$q(c)=0.002(105-c)$。 $$f(c)=0.012c-1.19+0.21-0.002c=0.01c-0.98$$

    $p(c)$ 要先加上 $[95,100)$ 整组的 $0.01$

  4. $f$ 在 $[95,100]$ 上递减、在 $(100,105]$ 上递增,且 $f(100)=-0.8+0.82=0.02$。所以最小值为 $f(100)=0.02$。

    端点对照:$f(95)=0.06$,$f(105)=0.07$,都比 $0.02$ 大

答案: $$f(c)=\begin{cases}-0.008c+0.82,&95\le c\le100\\0.01c-0.98,&100<c\le105\end{cases}$$ 最小值为 $0.02$。

易错点

漏诊对应“患病者”图的左侧面积,误诊对应“未患病者”图的右侧面积,两张图不能混用;跨组时别漏掉整组面积。

例 2原创例题

随机调查 100 名学生一周课外阅读时间(单位:小时),得到频率分布直方图如下(组距 2):

100 名学生一周课外阅读时间的频率分布直方图:6 组,组距 2,纵轴“频率/组距”,高依次为 0.025,0.075,0.125,0.15,0.075,0.05;最高的 [6,8) 一组用黄色标出。
图 9100 名学生一周课外阅读时间的频率分布直方图:6 组,组距 2,纵轴“频率/组距”,高依次为 $0.025,0.075,0.125,0.15,0.075,0.05$;最高的 $[6,8)$ 一组用黄色标出。

(1)估计平均数、众数、中位数;

(2)估计第 80 百分位数;

(3)估计方差与标准差(同一组数据用组中值代替)。

建模思路

三种“中心”对应直方图上三种几何量:平均数 = 组中值以频率加权(面积的重心),中位数 = 左右面积各 $0.5$ 的竖线,众数 = 最高矩形底边中点。百分位数是中位数的推广:左边面积为 $p\%$ 的竖线。

解析

(1)平均数、众数、中位数

  1. 各组频率 = 高 × 2:$0.05,\ 0.15,\ 0.25,\ 0.30,\ 0.15,\ 0.10$,和为 $1$。

    纵轴是“频率/组距”,频率要乘组距

  2. 平均数: $$\bar x\approx1\times0.05+3\times0.15+5\times0.25+7\times0.30+9\times0.15+11\times0.10=6.3$$

    每组数据用组中值代表

  3. 众数:最高矩形 $[6,8)$ 的中点,估计为 $7$。
  4. 中位数:前三组累计 $0.05+0.15+0.25=0.45<0.5$,前四组累计 $0.75>0.5$,所以中位数 $m\in[6,8)$: $$0.45+(m-6)\times0.15=0.5\Rightarrow m=6+\frac{0.05}{0.15}=\frac{19}3\approx6.33$$

    组内均匀:在 $[6,8)$ 里再取宽度 $m-6$,面积为 $0.15(m-6)$

答案:平均数 $6.3$,众数 $7$,中位数 $\dfrac{19}{3}\approx6.33$

(2)第 80 百分位数

  1. 前四组累计 $0.75<0.8$,前五组累计 $0.90\ge0.8$,所以 $x_{80}\in[8,10)$。
  2. $$0.75+(x-8)\times0.075=0.8\Rightarrow x=8+\frac{0.05}{0.075}=\frac{26}3\approx8.67$$

答案:约 $8.67$ 小时

(3)方差与标准差

  1. $$ \begin{aligned} s^2&\approx\sum f_i(x_i-\bar x)^2\\ &=0.05(-5.3)^2+0.15(-3.3)^2+0.25(-1.3)^2\\ &\qquad+0.30(0.7)^2+0.15(2.7)^2+0.10(4.7)^2 \end{aligned} $$
  2. $=1.4045+1.6335+0.4225+0.147+1.0935+2.209=6.91$,$s\approx\sqrt{6.91}\approx2.63$。

    也可用 $s^2=\sum f_ix_i^2-\bar x^2=46.6-39.69=6.91$ 验算

答案:$s^2\approx6.91$,$s\approx2.63$

易错点

把纵轴读数 $0.15$ 当成频率(应乘组距得 $0.30$);中位数直接取“中间那组的中点”$7$(忽略了组内位置)。

课堂小测

课堂小测

频率分布直方图中某组 $[20,30)$ 的纵轴读数为 $0.03$,则该组的频率是

查看答案与解析

答案C

解析

面积 $=0.03\times10=0.3$。

辨析
  • A:$0.03$ 是“频率/组距”,不是频率本身
  • B:除以组距方向反了,频率 = 高 × 组距
  • D:没有乘组距 $10$,也不是用 $1$ 去减。
课堂小测

数据 $2,3,5,6,8,9,10,12$ 的第 $75$ 百分位数是

查看答案与解析

答案B

解析

$i=8\times75\%=6$ 为整数,取 $\dfrac{9+10}{2}=9.5$。

辨析
  • A:$i=6$ 是整数,要取第 $6$、$7$ 项的平均,不是直接取第 $6$ 项
  • C:这是第 $7$ 项,整数情形要取第 $6$、$7$ 项平均
  • D:这是中位数(第 $50$ 百分位数)$\dfrac{6+8}{2}=7$。
课堂小测

某地居民收入的直方图明显右偏(长尾在右),下列判断最合理的是

查看答案与解析

答案D

解析

平均数是“重心”,被右侧长尾拉向右边;中位数只看排位,更能代表“典型居民”。

辨析
  • A:右偏时少数高收入把平均数拉大,平均数通常大于中位数
  • B:只有近似对称时三者才接近相等
  • C:众数是最高矩形的中点,右偏时它通常在左侧,是三者中最小的。
专题 12

协方差与相关系数:把“一起变大”变成一个数

每个点到样本中心 $(\bar x,\bar y)$ 围成一个矩形,右上、左下的矩形记正面积,左上、右下的记负面积。正负面积的“净和”就是协方差的核心。

看见:偏差矩形

正负矩形与相关系数

12 个样本点的偏差矩形。橙色虚线的交点是样本中心 (\bar x,\bar y);每个蓝点与样本中心围成一个矩形。青绿色矩形(右上、左下,角上标 +)对应 (x_i-\bar x)(y_i-\bar y)>0,红色矩形(左上、右下,角上标 -)对应乘积 <0。青绿色面积明显多于红色,所以 r>0。
图 112 个样本点的偏差矩形。橙色虚线的交点是样本中心 $(\bar x,\bar y)$;每个蓝点与样本中心围成一个矩形。青绿色矩形(右上、左下,角上标 $+$)对应 $(x_i-\bar x)(y_i-\bar y)>0$,红色矩形(左上、右下,角上标 $-$)对应乘积 $<0$。青绿色面积明显多于红色,所以 $r>0$。

对图中这组 $n=12$ 的数据:正乘积之和为 $31.8$,负乘积之和为 $-5.81$,协方差 $\dfrac1n\sum(x_i-\bar x)(y_i-\bar y)\approx2.166$,相关系数 $r=0.6$:

$$r=\dfrac{S_{xy}}{\sqrt{S_{xx}S_{yy}}}=\dfrac{31.8+(-5.81)}{\sqrt{43.32\times43.32}}=0.6$$

提示

$n=12$,$r=0.6$:正相关,有一定线性相关。正面积占优。

思路

若有一个点落在右上角很远处,它的矩形面积是“偏差 × 偏差”,增长得很快,$r$ 会被这一个点明显拉动。这就是后面“离群点的影响”一节要讲的内容。

推导:$r$ 与 $|r|\le1$

从“偏差乘积”到相关系数

  1. 点 $(x_i,y_i)$ 在 $(\bar x,\bar y)$ 的右上或左下时,$(x_i-\bar x)(y_i-\bar y)>0$;左上或右下时 $<0$。求和: $$S_{xy}=\sum_{i=1}^n(x_i-\bar x)(y_i-\bar y)$$

    正相关的点云主要落在右上、左下,$S_{xy}$ 为正;负相关则为负

  2. $S_{xy}$ 会随 $n$ 增大而增大,除以 $n$ 得协方差 $\operatorname{cov}(x,y)=\dfrac1n S_{xy}$。但它有单位:身高从 cm 改成 m,协方差缩小为 $\dfrac1{100}$。

    数值大小受单位影响,不能用来比较“相关的强弱”

  3. 消去单位:把两个变量都标准化,即除以各自的标准差 $s_x=\sqrt{S_{xx}/n}$、$s_y=\sqrt{S_{yy}/n}$: $$r=\frac{\operatorname{cov}(x,y)}{s_xs_y}=\frac{\sum(x_i-\bar x)(y_i-\bar y)}{\sqrt{\sum(x_i-\bar x)^2}\sqrt{\sum(y_i-\bar y)^2}}$$

    分子分母各有一个 $\tfrac1n$,约掉。$x$ 乘正数 $k$:分子分母同乘 $k$,$r$ 不变

  4. 记 $a_i=x_i-\bar x,\ b_i=y_i-\bar y$。对任意实数 $t$: $$f(t)=\sum_{i=1}^n(a_it-b_i)^2=\Big(\sum a_i^2\Big)t^2-2\Big(\sum a_ib_i\Big)t+\sum b_i^2\ \ge0$$

    平方和非负。只要 $x$ 不全相等,$\sum a_i^2>0$,$f$ 是开口向上的二次函数

  5. 二次函数恒非负 $\iff$ 判别式 $\le0$: $$4\Big(\sum a_ib_i\Big)^2-4\sum a_i^2\sum b_i^2\le0$$ 即柯西不等式 $\left(\sum a_ib_i\right)^2\le\sum a_i^2\sum b_i^2$,所以 $$r^2\le1,\qquad |r|\le1$$
  6. 取等条件:$|r|=1\iff$ 判别式为 $0$ $\iff$ 存在 $t_0$ 使 $f(t_0)=0$ $\iff$ 对所有 $i$,$b_i=t_0a_i$,即 $y_i-\bar y=t_0(x_i-\bar x)$。

    所有点都在过 $(\bar x,\bar y)$、斜率 $t_0$ 的直线上;$t_0>0$ 时 $r=1$,$t_0<0$ 时 $r=-1$

  7. 计算用的等价形式: $$S_{xy}=\sum x_iy_i-n\bar x\bar y,\qquad S_{xx}=\sum x_i^2-n\bar x^2$$

    展开:$\sum(x_i-\bar x)(y_i-\bar y)=\sum x_iy_i-\bar x\sum y_i-\bar y\sum x_i+n\bar x\bar y=\sum x_iy_i-n\bar x\bar y$

  8. 解读:$r>0$ 正相关,$r<0$ 负相关;$|r|$ 越接近 $1$,线性相关程度越强,越接近 $0$ 越弱。

    有些题目会给出“$|r|>0.75$ 认为相关性很强”之类的约定,按题目执行

换单位:协方差变,$r$ 不变

以 6 位同学的身高、体重为例:

身高(cm) 158 163 167 170 174 180
体重(kg) 50 56 55 62 66 71

$$ \begin{aligned} &\operatorname{cov}=49.5,\quad s_x=7.157,\quad s_y=7.095\\ &r=\dfrac{\operatorname{cov}}{s_xs_y}=\dfrac{49.5}{7.157\times7.095}=0.9749 \end{aligned} $$

改变单位后,协方差与标准差随之改变,$r$ 的大小不变;若一个变量取相反数,$r$ 变号:

换法 变换后的数据 $\operatorname{cov}$ $s_x$ $s_y$ $r$
原数据(cm,kg) 身高 158, 163, 167, 170, 174, 180;体重 50, 56, 55, 62, 66, 71 $49.5$ $7.157$ $7.095$ $0.9749$
身高改为 m 身高 1.58, 1.63, 1.67, 1.7, 1.74, 1.8 $0.495$ $0.0716$ $7.095$ $0.9749$
体重改为斤 体重 100, 112, 110, 124, 132, 142 $99$ $7.157$ $14.189$ $0.9749$
体重取“比 0 kg 轻多少”($\times(-1)$) 体重 $-50,-56,-55,-62,-66,-71$ $-49.5$ $7.157$ $7.095$ $-0.9749$
线性变换对 $r$ 的影响

$x\to kx+m$,$y\to ly+q$:偏差变为 $k a_i$、$l b_i$, $$r\to\frac{kl\sum a_ib_i}{|k||l|\sqrt{\sum a_i^2\sum b_i^2}}=\operatorname{sgn}(kl)\cdot r$$ 同号伸缩不改变 $r$;一个变量取相反数,$r$ 变号。

辨析:$r$ 只看线性

几种典型散点图

课件中给出六类典型散点图,下面逐类说明。

强线性

点集中在一条直线附近,$|r|$ 接近 $1$。

弱线性

只能看出一点上升趋势,点很分散,$r$ 较小。

抛物线:$r\approx0$

抛物线型散点:30 个点沿 y\approx1+0.3(x-5)^2 排列并带有小幅噪声。左半边随 x 增大而下降,右半边上升,正负矩形抵消,样本 r=-0.01\approx0。
图 2抛物线型散点:30 个点沿 $y\approx1+0.3(x-5)^2$ 排列并带有小幅噪声。左半边随 $x$ 增大而下降,右半边上升,正负矩形抵消,样本 $r=-0.01\approx0$。

$y$ 几乎由 $x$ 完全决定(抛物线),但左半边下降、右半边上升,正负矩形抵消,$r\approx0$(图中样本 $r=-0.01$)。$r\approx0$ 只能说明“没有线性关系”。

圆

关于中心对称的圆环,x 与 y 关系明确但 r\approx0。
图 3关于中心对称的圆环,$x$ 与 $y$ 关系明确但 $r\approx0$。

关于中心对称的圆环:$x$ 与 $y$ 有明确的关系($x^2+y^2$ 几乎为常数),$r$ 却接近 $0$。

分组反向

紫、橙两组内均为负相关(r=-0.70),合并后的整体呈正相关;细实线表示组内趋势,灰虚线表示整体趋势。
图 4紫、橙两组内均为负相关($r=-0.70$),合并后的整体呈正相关;细实线表示组内趋势,灰虚线表示整体趋势。

紫、橙两组各自内部都是负相关($r$ 约 $-0.7$),合在一起整体却是正相关。只看整体 $r$ 会得出相反的结论。

混杂变量

30 个点由共同的气温因素生成:蓝色为低温,红色为高温;整体明显正相关,不能据此判断因果。
图 530 个点由共同的气温因素生成:蓝色为低温,红色为高温;整体明显正相关,不能据此判断因果。

冰淇淋销量与溺水人数高度正相关,但二者都由气温(颜色:蓝冷红热)驱动。限制在同一气温下看,这种相关几乎消失。不能说“卖冰淇淋导致溺水”。

易错

相关 $\ne$ 因果。$r$ 是对称的($x,y$ 交换,$r$ 不变),它本身无法告诉我们谁影响谁,更无法排除第三个变量同时影响两者(混杂)。要论证因果,需要控制变量的试验设计。

注意

$r\approx0$ $\ne$ 没关系。$r$ 只衡量线性相关:抛物线、圆这种确定的非线性关系,$r$ 也可能等于 $0$。先画散点图,再算 $r$。

离群点的影响

一个点能有多大影响

离群点对 r 的影响:14 个深色点为几乎不相关的主体数据,红点为离群点(图中位于 (17,17))。背景颜色表示把离群点放在该位置时全部 15 个点的 r:青绿色越深 r 越接近 1,蓝色越深 r 越接近 -1,白色附近 r\approx0。红点所在的右上区域为深青绿色,此时 r=0.85,而不含离群点时 r=0。
图 6离群点对 $r$ 的影响:14 个深色点为几乎不相关的主体数据,红点为离群点(图中位于 $(17,17)$)。背景颜色表示把离群点放在该位置时全部 15 个点的 $r$:青绿色越深 $r$ 越接近 $1$,蓝色越深 $r$ 越接近 $-1$,白色附近 $r\approx0$。红点所在的右上区域为深青绿色,此时 $r=0.85$,而不含离群点时 $r=0$。

主体数据几乎不相关时,不含离群点的 $r=0$,加入一个离群点(共 15 个点)后 $r=0.85$。课件中另一组主体数据(较强负相关)的对比如下:

主体数据 点数 不含离群点的 $r$ 含离群点的 $r$
几乎不相关 15 $0$ $0.85$
较强负相关 15 $-0.85$ $0.723$
思路

离群点到中心的偏差很大,它贡献的乘积 $(x-\bar x)(y-\bar y)$ 和平方 $(x-\bar x)^2$ 都远超其他点,几乎“独自决定”了 $r$。主体数据完全不相关时,一个远处的点就能造出 $r>0.8$ 的“强相关”。

注意

实际处理:检查离群点是不是录入错误或测量故障;若是真实数据,应分别报告含与不含它的结果,而不是悄悄删掉。

例题精讲

例 1原创例题(相关系数的计算与性质)

某商品单价 $x$(元)与日销量 $y$(百件)的 5 组数据如下:

$x$ 1 2 3 4 5
$y$ 10 8 7 4 1

(1)求样本相关系数 $r$(精确到 $0.001$),判断相关性的方向与强弱;

(2)把单价改为 $x'=-2x+3$,销量单位改为“件”($y'=100y$),新的相关系数是多少?

(3)若误录入一组数据 $(10,10)$,重新计算 $r$,说明原因。

建模思路

$r=\dfrac{\sum(x_i-\bar x)(y_i-\bar y)}{\sqrt{\sum(x_i-\bar x)^2\sum(y_i-\bar y)^2}}$:先算偏差,再算三个和。$r$ 不受单位(正倍数)影响,但对离群点非常敏感。

解析

(1)计算 $r$

  1. $\bar x=3,\ \bar y=\dfrac{30}5=6$。偏差:$x_i-\bar x=-2,-1,0,1,2$;$y_i-\bar y=4,2,1,-2,-5$。
  2. $\sum(x_i-\bar x)(y_i-\bar y)=-8-2+0-2-10=-22$;$\sum(x_i-\bar x)^2=10$;$\sum(y_i-\bar y)^2=16+4+1+4+25=50$。
  3. $$r=\frac{-22}{\sqrt{10\times50}}=\frac{-22}{10\sqrt5}\approx-0.984$$

    $|r|$ 接近 $1$:很强的线性相关;$r<0$:负相关

答案:$r\approx-0.984$,强负相关

(2)线性变换后的 $r$

  1. $x'_i-\bar x'=-2(x_i-\bar x)$,$y'_i-\bar y'=100(y_i-\bar y)$。

    加常数 $3$ 被减均值抵消,只剩倍数

  2. 分子乘 $(-2)\times100$,分母乘 $\sqrt{4\times10^4}=|{-2}|\times100$,所以 $r'=\dfrac{-200}{200}r=-r\approx0.984$。

    同号倍数不改变 $r$;一个变量乘负数,$r$ 变号

答案:$r'\approx0.984$

(3)离群点 $(10,10)$ 的影响

  1. 6 组数据:$\bar x=\dfrac{25}6,\ \bar y=\dfrac{40}6=\dfrac{20}3$。
  2. $\sum x_iy_i=10+16+21+16+5+100=168$,$\sum(x_i-\bar x)(y_i-\bar y)=168-6\cdot\dfrac{25}6\cdot\dfrac{20}3=\dfrac43$。

    用 $\sum x_iy_i-n\bar x\bar y$ 计算,避免分数偏差

  3. $\sum(x_i-\bar x)^2=155-\dfrac{625}6=\dfrac{305}6$,$\sum(y_i-\bar y)^2=330-\dfrac{800}3=\dfrac{190}3$。 $$r=\frac{4/3}{\sqrt{\frac{305}6\cdot\frac{190}3}}\approx0.023$$
  4. 一个远离主体的点贡献了巨大的正乘积 $(10-\bar x)(10-\bar y)$,几乎抵消了原来所有的负乘积。

    计算 $r$ 之前先画散点图,排查异常值

答案:$r\approx0.023$:一个离群点把强负相关“变成”几乎不相关

易错

易错点:(3) 中 $r\approx0$ 不能说明 $x,y$ 无关,只是数据被污染。另外,$|r|$ 大只说明线性相关强,不说明“降价导致销量增加”的因果。

例 2原创例题(回归方程、残差与 $R^2$)

某店广告费 $x$(万元)与销售额 $y$(万元)的数据如下:

$x$ 1 2 3 4 5
$y$ 3 4 6 7 10

(1)求 $y$ 关于 $x$ 的经验回归方程;

(2)求 $x=4$ 处的残差,并求残差平方和与 $R^2$;

(3)预测广告费为 6 万元时的销售额。

建模思路

$\hat b=\dfrac{\sum(x_i-\bar x)(y_i-\bar y)}{\sum(x_i-\bar x)^2}$,$\hat a=\bar y-\hat b\bar x$。残差 $=$ 观测值 $-$ 预测值。一元线性回归中 $R^2=r^2$。

解析

(1)经验回归方程

  1. $\bar x=3,\ \bar y=6$;偏差 $x_i-\bar x=-2,-1,0,1,2$,$y_i-\bar y=-3,-2,0,1,4$。
  2. $S_{xy}=6+2+0+1+8=17$,$S_{xx}=10$,$\hat b=\dfrac{17}{10}=1.7$。
  3. $\hat a=\bar y-\hat b\bar x=6-1.7\times3=0.9$,所以 $\hat y=1.7x+0.9$。

    回归直线一定过样本中心 $(\bar x,\bar y)=(3,6)$

答案:$\hat y=1.7x+0.9$

(2)残差、残差平方和与 $R^2$

  1. $x=4$ 时 $\hat y=7.7$,残差 $\hat e=7-7.7=-0.7$。

    残差 $=$ 观测 $-$ 预测;负数表示点在直线下方

  2. 五个残差:$0.4,\,-0.3,\,0,\,-0.7,\,0.6$(和为 $0$),$\sum\hat e_i^2=0.16+0.09+0+0.49+0.36=1.1$。

    残差之和为 $0$ 是最小二乘的必然结果,可用于检查计算

  3. $S_{yy}=9+4+0+1+16=30$, $$R^2=1-\frac{1.1}{30}=\frac{28.9}{30}\approx0.963$$
  4. 验证:$r=\dfrac{17}{\sqrt{10\times30}}\approx0.981$,$r^2=\dfrac{289}{300}\approx0.963=R^2$。

    回归模块推导中的结论:$Q_{\min}=S_{yy}(1-r^2)$

答案:残差 $-0.7$;$\sum\hat e_i^2=1.1$;$R^2\approx0.963$

(3)预测

  1. $\hat y=1.7\times6+0.9=11.1$(万元)。

    “预测值”是估计的平均水平,不是一定等于 $11.1$

答案:约 $11.1$ 万元

易错

易错点:残差写成“预测 $-$ 观测”会全部反号;预测时 $x$ 离样本范围太远(如 $x=50$),线性关系可能不再成立。

课堂小测

课堂小测

两个变量的样本相关系数 $r=-0.95$,下列说法正确的是

查看答案与解析

答案C

解析

$|r|$ 接近 $1$ 且 $r<0$:较强的负线性相关,散点图呈从左上到右下的带状。

辨析
  • A:$r$ 的绝对值衡量强弱;$-0.95$ 的线性相关很强,只是方向为负
  • B:$r$ 只描述线性相关的方向与强弱,不能说明谁导致谁
  • D:$|r|=1$ 时才所有点共线,$0.95$ 只说明点比较集中在一条直线附近。
课堂小测

把数据中所有 $x_i$ 换成 $3-2x_i$,$y_i$ 不变,相关系数由 $r$ 变为

查看答案与解析

答案A

解析

偏差变为 $-2(x_i-\bar x)$,分子乘 $-2$,分母乘 $|-2|=2$,$r$ 变为 $-r$。

辨析
  • B:乘负数会改变“同增同减”的方向,$r$ 要变号
  • C:$r$ 没有单位,分母里的 $|-2|$ 与分子的 $-2$ 抵消,只剩符号
  • D:加的常数 $3$ 在减均值时被抵消,不影响 $r$,也不会变成 $3-2r$。
课堂小测

数据点 $(x_i,y_i)$ 满足 $y_i=x_i^2$,$x_i$ 取 $-2,-1,0,1,2$。则 $r$ 等于

查看答案与解析

答案D

解析

$\bar x=0$,$S_{xy}=\sum x_i^3-2\sum x_i=0$,所以 $r=0$。这正说明 $r=0$ 只代表没有线性相关。

辨析
  • A:$y$ 由 $x$ 完全确定,但不是线性关系,$r$ 不必为 $1$
  • B:点关于 $y$ 轴对称,左半边的“负相关”与右半边的“正相关”正好抵消,不是 $-1$
  • C:$r$ 是完全确定的数,可以计算:$\sum(x_i-\bar x)(y_i-\bar y)=\sum x_i(x_i^2-2)=\sum x_i^3-2\sum x_i=0$。
专题 13

线性回归与最小二乘:让残差平方和最小的那条直线

每个点到直线的竖直距离是残差,以它为边画正方形。最小二乘直线就是让这些正方形的总面积最小的直线。

看见:残差正方形的总面积

红色正方形总面积最小的直线
9 个蓝点是样本数据,橙色实线是一条随手画的直线 y=0.056x+5.972,绿色虚线是最小二乘直线 \hat y=0.765x+1.453,空心圆圈是样本中心 (\bar x,\bar y)。红色竖线是各点到橙色直线的残差,淡红色正方形以残差为边长,面积就是残差平方 e_i^2。橙线离数据很远,正方形又大又多;虚线穿过点群中央,同样的作图会使正方形总面积最小。
图 19 个蓝点是样本数据,橙色实线是一条随手画的直线 $y=0.056x+5.972$,绿色虚线是最小二乘直线 $\hat y=0.765x+1.453$,空心圆圈是样本中心 $(\bar x,\bar y)$。红色竖线是各点到橙色直线的残差,淡红色正方形以残差为边长,面积就是残差平方 $e_i^2$。橙线离数据很远,正方形又大又多;虚线穿过点群中央,同样的作图会使正方形总面积最小。

残差平方和 $Q(a,b)$

上图中橙色直线 $y=0.056x+5.972$ 的残差平方和 $Q=40.288$;最小二乘直线 $\hat y=0.765x+1.453$ 的最小值 $Q_{\min}=1.582$。前者是后者的 $25.47$ 倍。

$$ \begin{aligned} \text{橙色直线:}\ & y=0.056x+5.972\\ \text{最小二乘直线:}\ & \hat y=0.765x+1.453 \end{aligned} $$

橙色直线在各个 $x$ 处的残差 $e$ 为:

$x$ 1 2 3 4 5 6 7 8 9
$e$ $-3.83$ $-2.68$ $-3.04$ $-1.59$ $-0.35$ $-0.91$ $0.64$ $0.88$ $2.13$

这条直线的残差之和为 $-8.75$;而最小二乘直线的残差之和恒为 $0$。

思路

为什么用竖直距离?回归是“已知 $x$ 预测 $y$”,误差出现在 $y$ 方向。为什么用平方?绝对值不好求导配方;平方和能直接配方得到唯一的最小点,而且大残差被放大,直线不会对远离的点置之不理。

推导:配方求 $\hat a$、$\hat b$

对 $a$ 配方,再对 $b$ 配方

  1. 目标:选 $a,b$ 使 $$Q(a,b)=\sum_{i=1}^n\big(y_i-bx_i-a\big)^2$$ 最小。

    $Q$ 是残差平方和:第一节里红色正方形的总面积

  2. 先固定 $b$,把 $Q$ 看成 $a$ 的二次函数。记 $u_i=y_i-bx_i$,$\bar u=\bar y-b\bar x$: $$Q=\sum(u_i-a)^2=\sum(u_i-\bar u)^2+n(\bar u-a)^2$$

    交叉项 $2(\bar u-a)\sum(u_i-\bar u)=0$,因为偏差之和为 0

  3. 所以对每个 $b$,最优的 $a$ 是 $$\hat a=\bar u=\bar y-b\bar x\iff \bar y=b\bar x+\hat a$$ 回归直线必过样本中心 $(\bar x,\bar y)$。

    也可以求导:$\dfrac{\partial Q}{\partial a}=-2\sum(y_i-bx_i-a)=0\Rightarrow a=\bar y-b\bar x$

  4. 代回:$u_i-\bar u=(y_i-\bar y)-b(x_i-\bar x)$,于是只剩 $b$: $$Q(b)=\sum\big[(y_i-\bar y)-b(x_i-\bar x)\big]^2=S_{xx}b^2-2S_{xy}b+S_{yy}$$

    $S_{xx}=\sum(x_i-\bar x)^2$,$S_{xy}=\sum(x_i-\bar x)(y_i-\bar y)$,$S_{yy}=\sum(y_i-\bar y)^2$

  5. 开口向上的二次函数,对称轴处最小: $$\hat b=\frac{S_{xy}}{S_{xx}}=\frac{\sum(x_i-\bar x)(y_i-\bar y)}{\sum(x_i-\bar x)^2}=\frac{\sum x_iy_i-n\bar x\bar y}{\sum x_i^2-n\bar x^2}$$
  6. 最小值: $$Q_{\min}=S_{yy}-\frac{S_{xy}^2}{S_{xx}}=S_{yy}\Big(1-\frac{S_{xy}^2}{S_{xx}S_{yy}}\Big)=S_{yy}(1-r^2)$$

    与上一模块的 $r$ 联系起来:$|r|$ 越接近 1,残差平方和越小,拟合越好;$|r|=1$ 时 $Q_{\min}=0$,点全在直线上

  7. 两个副产品:$\hat b$ 与 $r$ 同号(分子都是 $S_{xy}$);残差之和 $$\sum\hat e_i=\sum(y_i-\hat b x_i-\hat a)=n(\bar y-\hat b\bar x-\hat a)=0$$

    $\hat b=r\cdot\dfrac{s_y}{s_x}$:$r$ 决定方向,标准差之比决定陡峭程度

$Q$ 只看 $b$ 时是一条抛物线($a$ 已取最优)
按显示的多项式 Q(b)=60b^2-91.8b+36.7 作图;绿色实心点为最低点 b=0.765,橙点为 b=0.30。按该多项式计算 Q_{\min}=1.5865、Q(0.30)=14.560;与正文原始样本所报数值存在舍入差异。
图 2按显示的多项式 $Q(b)=60b^2-91.8b+36.7$ 作图;绿色实心点为最低点 $b=0.765$,橙点为 $b=0.30$。按该多项式计算 $Q_{\min}=1.5865$、$Q(0.30)=14.560$;与正文原始样本所报数值存在舍入差异。

数据与第一节相同,计算如下:

$$ \begin{aligned} &S_{xx}=60,\quad S_{xy}=45.9,\quad S_{yy}=36.7\\ &Q(b)=60b^2-91.8b+36.7,\qquad Q(0.30)=14.556\\ &\hat b=\frac{S_{xy}}{S_{xx}}=0.765\\ &Q_{\min}=S_{yy}(1-r^2)=36.7\times(1-0.9569)=1.582 \end{aligned} $$

$R^2$ 与残差分析

拟合效果:散点图与残差图

下面两张图的数据由真实关系 $y=2+0.8x$ 加随机噪声($\sigma=0.8$)生成。
散点图:蓝点为样本,橙色实线是最小二乘直线 \hat y=0.771x+2.032,灰色虚线是 y=\bar y。点均匀地落在直线两侧。
图 3散点图:蓝点为样本,橙色实线是最小二乘直线 $\hat y=0.771x+2.032$,灰色虚线是 $y=\bar y$。点均匀地落在直线两侧。
残差图:红点是各样本点的残差 \hat e,橙色水平线是 \hat e=0。残差在 0 两侧无规律地、均匀地分布在一条水平带内,说明线性模型合适。
图 4残差图:红点是各样本点的残差 $\hat e$,橙色水平线是 $\hat e=0$。残差在 0 两侧无规律地、均匀地分布在一条水平带内,说明线性模型合适。

总偏差 = 回归解释的部分 + 残差
三条横条对应同一组数据的三个平方和:灰色是总偏差 S_{yy}=109.4,绿色是回归平方和 \sum(\hat y_i-\bar y)^2=99.3,红色是残差平方和 \sum(y_i-\hat y_i)^2=10.1。总偏差等于后两者之和。
图 5三条横条对应同一组数据的三个平方和:灰色是总偏差 $S_{yy}=109.4$,绿色是回归平方和 $\sum(\hat y_i-\bar y)^2=99.3$,红色是残差平方和 $\sum(y_i-\hat y_i)^2=10.1$。总偏差等于后两者之和。

$$ \begin{aligned} &\hat y=0.771x+2.032\\ &R^2=1-\frac{10.09}{109.38}=0.9078,\qquad r^2=0.9078 \end{aligned} $$

总偏差分解与 $R^2$

$$\underbrace{\sum(y_i-\bar y)^2}_{S_{yy}\ \text{总偏差平方和}}=\underbrace{\sum(\hat y_i-\bar y)^2}_{\text{回归平方和}}+\underbrace{\sum(y_i-\hat y_i)^2}_{\text{残差平方和}}$$ $$R^2=1-\frac{\sum(y_i-\hat y_i)^2}{\sum(y_i-\bar y)^2}$$ $R^2$ 表示 $y$ 的波动中能被 $x$ 的线性关系解释的比例;一元线性回归中 $R^2=r^2$(由推导一节 $Q_{\min}=S_{yy}(1-r^2)$)。

注意

若真实关系是“弯曲”的(见下一小节)且噪声为 0,$R^2$ 仍然很高,但残差图呈明显的 U 形——$R^2$ 高不等于模型选对了。残差应当在 0 两侧无规律、均匀地分布在一条水平带内。

真实关系为弯曲 $y=1+0.12x^2$ 时
无噪声对照:20 个等距点来自 y=1+0.12x^2;左图蓝点与灰色真实曲线、橙色最小二乘直线 \hat y=1.2x-0.8947 和灰色虚线 y=\bar y;右图为同一组数据的残差,清晰呈 U 形。此图为独立无噪声示意,下面的系数与平方和仍来自课件原始样本。
图 6无噪声对照:20 个等距点来自 $y=1+0.12x^2$;左图蓝点与灰色真实曲线、橙色最小二乘直线 $\hat y=1.2x-0.8947$ 和灰色虚线 $y=\bar y$;右图为同一组数据的残差,清晰呈 U 形。此图为独立无噪声示意,下面的系数与平方和仍来自课件原始样本。

$$ \begin{aligned} &\hat y=1.18x-1.009\\ &R^2=1-\frac{23.2}{255.55}=0.9092,\qquad r^2=0.9092 \end{aligned} $$

此时总偏差平方和为 $255.6$,回归平方和为 $232.3$,残差平方和为 $23.2$。$R^2$ 高达 $0.9092$,但残差图已显示出弯曲的规律。

非线性回归:换元

换元:把曲线拉直,再用最小二乘

先用换元把非线性关系化成线性关系,再对新变量做最小二乘;最后把结果还原。下面分别看指数、对数、反比例三种常见模型。

指数模型 $y=c\,e^{dx}$
原始坐标:蓝点是样本,橙色曲线是还原后的 \hat y=2.069\,e^{0.3491x},灰色虚线是直接用直线拟合的结果,曲线明显更贴合。
图 7原始坐标:蓝点是样本,橙色曲线是还原后的 $\hat y=2.069\,e^{0.3491x}$,灰色虚线是直接用直线拟合的结果,曲线明显更贴合。
换元后坐标:横轴 x、纵轴 z=\ln y,蓝点几乎排成一条直线,橙色直线是 \hat z=0.3491x+0.7269。
图 8换元后坐标:横轴 $x$、纵轴 $z=\ln y$,蓝点几乎排成一条直线,橙色直线是 $\hat z=0.3491x+0.7269$。

原式 $y=c\,e^{dx}$ 两边取自然对数:$\ln y=\ln c+dx$。令 $z=\ln y$:

$$z=dx+\ln c\quad(\text{关于 }x\text{ 的线性函数})$$

对 $(x_i,z_i)$ 做最小二乘:$\hat z=0.3491x+0.7269$。还原:$\hat d=0.3491$,$\hat c=e^{0.7269}\approx2.069$,

$$\hat y=2.069\,e^{0.3491x}$$

换元后线性回归的 $R^2=0.9942$;直接用直线 $y=bx+a$ 的 $R^2=0.8606$。

注意

指数模型取对数后,最小二乘是对 $\ln y$ 做的,它让 $\sum(\ln y_i-\widehat{\ln y_i})^2$ 最小,不是让原始的 $\sum(y_i-\hat y_i)^2$ 最小。高中题目都按换元后的线性回归计算即可。

对数模型 $y=b\ln x+a$(例 2 的数据)
蓝点是例 2 的 8 组数据(x 为投入,y 为收益),橙色曲线是 \hat y=5.568\ln x-0.075,灰色虚线是直接用直线拟合的结果。数据“先快后慢”,曲线比直线贴合得更好。
图 9蓝点是例 2 的 8 组数据($x$ 为投入,$y$ 为收益),橙色曲线是 $\hat y=5.568\ln x-0.075$,灰色虚线是直接用直线拟合的结果。数据“先快后慢”,曲线比直线贴合得更好。

令 $v=\ln x$,$y=bv+a$ 就是关于 $v$ 的线性回归。用真实的 $\ln x_i$ 计算:$\hat y=5.568\ln x-0.075$。例 2 按附表的近似和($\sum v_i=29$ 等)算得 $\hat y=5\ln x+2$;两者的差别来自附表的四舍五入,见例 2 的“易错点”。

换元后线性回归的 $R^2=0.9778$;直接用直线 $y=bx+a$ 的 $R^2=0.9162$。

反比例模型 $y=a+\dfrac bx$
蓝点是样本,橙色曲线是 \hat y=1.936+\dfrac{6.171}{x},灰色虚线是直接用直线拟合的结果。数据先陡降后趋于平缓,直线明显拟合不了。
图 10蓝点是样本,橙色曲线是 $\hat y=1.936+\dfrac{6.171}{x}$,灰色虚线是直接用直线拟合的结果。数据先陡降后趋于平缓,直线明显拟合不了。

令 $t=\dfrac1x$,则 $y=a+bt$ 是关于 $t$ 的线性函数。对 $(t_i,y_i)$ 做最小二乘:$\hat y=1.936+6.171t$,即

$$\hat y=1.936+\frac{6.171}{x}$$

换元后线性回归的 $R^2=0.9954$;直接用直线 $y=bx+a$ 的 $R^2=0.5518$。

例题精讲

例 1原创例题

某店广告费 $x$(万元)与销售额 $y$(万元)的数据如下:

$x$ 1 2 3 4 5
$y$ 3 4 6 7 10

(1)求 $y$ 关于 $x$ 的经验回归方程;(2)求 $x=4$ 处的残差,并求残差平方和与 $R^2$;(3)预测广告费为 6 万元时的销售额。

建模思路

$\hat b=\dfrac{\sum(x_i-\bar x)(y_i-\bar y)}{\sum(x_i-\bar x)^2}$,$\hat a=\bar y-\hat b\bar x$。残差 = 观测值 − 预测值。一元线性回归中 $R^2=r^2$。

解析

(1)经验回归方程

  1. $\bar x=3,\ \bar y=6$;偏差 $x_i-\bar x=-2,-1,0,1,2$,$y_i-\bar y=-3,-2,0,1,4$。
  2. $S_{xy}=6+2+0+1+8=17$,$S_{xx}=10$,$\hat b=\dfrac{17}{10}=1.7$。
  3. $\hat a=\bar y-\hat b\bar x=6-1.7\times3=0.9$,所以 $\hat y=1.7x+0.9$。

    回归直线一定过样本中心 $(\bar x,\bar y)=(3,6)$

答案:$\hat y=1.7x+0.9$

(2)残差、残差平方和与 $R^2$

  1. $x=4$ 时 $\hat y=7.7$,残差 $\hat e=7-7.7=-0.7$。

    残差 = 观测 − 预测;负数表示点在直线下方

  2. 五个残差:$0.4,\,-0.3,\,0,\,-0.7,\,0.6$(和为 0),$\sum\hat e_i^2=0.16+0.09+0+0.49+0.36=1.1$。

    残差之和为 0 是最小二乘的必然结果,可用于检查计算

  3. $S_{yy}=9+4+0+1+16=30$, $$R^2=1-\frac{1.1}{30}=\frac{28.9}{30}\approx0.963$$
  4. 验证:$r=\dfrac{17}{\sqrt{10\times30}}\approx0.981$,$r^2=\dfrac{289}{300}\approx0.963=R^2$。

    推导一节:$Q_{\min}=S_{yy}(1-r^2)$

答案:残差 $-0.7$;$\sum\hat e_i^2=1.1$;$R^2\approx0.963$

(3)预测

  1. $\hat y=1.7\times6+0.9=11.1$(万元)。

    “预测值”是估计的平均水平,不是一定等于 $11.1$

答案:约 $11.1$ 万元

易错点

残差写成“预测 − 观测”会全部反号;预测时 $x$ 离样本范围太远(如 $x=50$),线性关系可能不再成立。

例 22024 温州二模

年投入资金 $x$(万元)与年收益 $y$(万元)的 8 组数据:

$x$ 10 20 30 40 50 60 70 80
$y$ 12.8 16.5 19 20.9 21.5 21.9 23 25.4

附:$\sum y_i=161,\ \sum\ln x_i=29,\ \sum x_i^2=20400,\ \sum(\ln x_i)^2=109,\ \sum y_i\ln x_i=603$;$\ln2\approx0.7,\ \ln5\approx1.6$。

(1)用 $y=b\ln x+a$ 拟合,求回归方程;

(2)新研发药用淀粉,收益为投入的 10%。计划共投入 200 万元生产两种淀粉,求年收益的最大值(精确到 0.1 万元)。

建模思路

散点“先快后慢”增长,像对数曲线。换元 $v=\ln x$,$y=bv+a$ 就是关于 $v$ 的线性回归,直接套最小二乘公式。

解析

(1)求回归方程

  1. 令 $v_i=\ln x_i$,则 $\bar v=\dfrac{29}8$,$\bar y=\dfrac{161}8$,$n=8$。

    附表里 $\sum(\ln x_i)^2$ 与 $\sum y_i\ln x_i$ 就是 $\sum v_i^2$ 与 $\sum v_iy_i$;$\sum x_i^2$ 是干扰项

  2. $$\hat b=\frac{\sum v_iy_i-n\bar v\bar y}{\sum v_i^2-n\bar v^2}=\frac{603-\frac{29\times161}8}{109-\frac{29^2}8}=\frac{4824-4669}{872-841}=\frac{155}{31}=5$$

    分子分母同乘 8 化成整数再算

  3. $\hat a=\bar y-\hat b\bar v=\dfrac{161-145}8=2$,所以 $\hat y=5\ln x+2$。

答案:$\hat y=5\ln x+2$

(2)收益最大值

  1. 设食品淀粉投入 $x$ 万元,药用淀粉 $200-x$ 万元($0<x\le200$): $$f(x)=5\ln x+2+0.1(200-x)=5\ln x-0.1x+22$$
  2. $f'(x)=\dfrac5x-0.1=\dfrac{50-x}{10x}$:$(0,50)$ 上 $f'>0$,$(50,200)$ 上 $f'<0$。
  3. $$f(50)=5\ln50+17=5(2\ln5+\ln2)+17\approx5\times3.9+17=36.5$$

    按题给 $\ln2\approx0.7$、$\ln5\approx1.6$ 计算。若用真实值 $\ln50\approx3.912$,则 $f(50)\approx36.6$:题目约定的近似值决定了答案

答案:投入食品淀粉 50 万元时年收益最大,约 $36.5$ 万元

易错点

附表中的和是四舍五入的(真实 $\sum\ln x_i\approx29.03$,$\sum(\ln x_i)^2\approx108.77$)。分母 $\sum v_i^2-n\bar v^2$ 是两个相近大数之差,对舍入极敏感:用真实值算得 $\hat b\approx5.57$。考试中必须按附表数据计算,但这提醒我们:分母本质是 $\sum(v_i-\bar v)^2$,计算时尽量少做“大数相减”。

课堂小测

课堂小测

已知 $\bar x=4,\ \bar y=10$,经验回归方程 $\hat y=\hat bx+3$,则 $\hat b$ 为

查看答案与解析

答案B

解析

回归直线过 $(\bar x,\bar y)$:$10=4\hat b+3\Rightarrow\hat b=\dfrac74$。

辨析
  • A:把 $\bar x$、$\bar y$ 位置弄反了,应为 $10=4\hat b+3$
  • C:$\dfrac{10}4$ 忽略了截距 3
  • D:条件足够,样本中心一定在回归直线上。
课堂小测

关于最小二乘直线,下列说法错误的是

查看答案与解析

答案D

解析

最小二乘只保证残差平方和最小,并不要求直线经过任何一个样本点;它一定经过的是样本中心 $(\bar x,\bar y)$,而样本中心通常不是样本点。

辨析
  • A:正确,由 $\sum\hat e_i=n(\bar y-\hat b\bar x-\hat a)=0$
  • B:正确,$\hat b$ 与 $r$ 的分子都是 $S_{xy}$
  • C:正确,$Q_{\min}=S_{yy}(1-r^2)$。
课堂小测

用 $y=c\,e^{dx}$ 拟合数据,令 $z=\ln y$ 得 $\hat z=0.3x+1.2$,则

查看答案与解析

答案A

解析

$\ln y=1.2+0.3x\Rightarrow y=e^{1.2}\cdot e^{0.3x}$,所以 $c=e^{1.2}$,$d=0.3$。

辨析
  • B:截距 $1.2$ 是 $\ln c$,要取指数才是 $c$
  • C:斜率对应 $d$,截距对应 $\ln c$,位置弄反了
  • D:斜率 $0.3$ 本身就是 $d$,不需要再取对数。
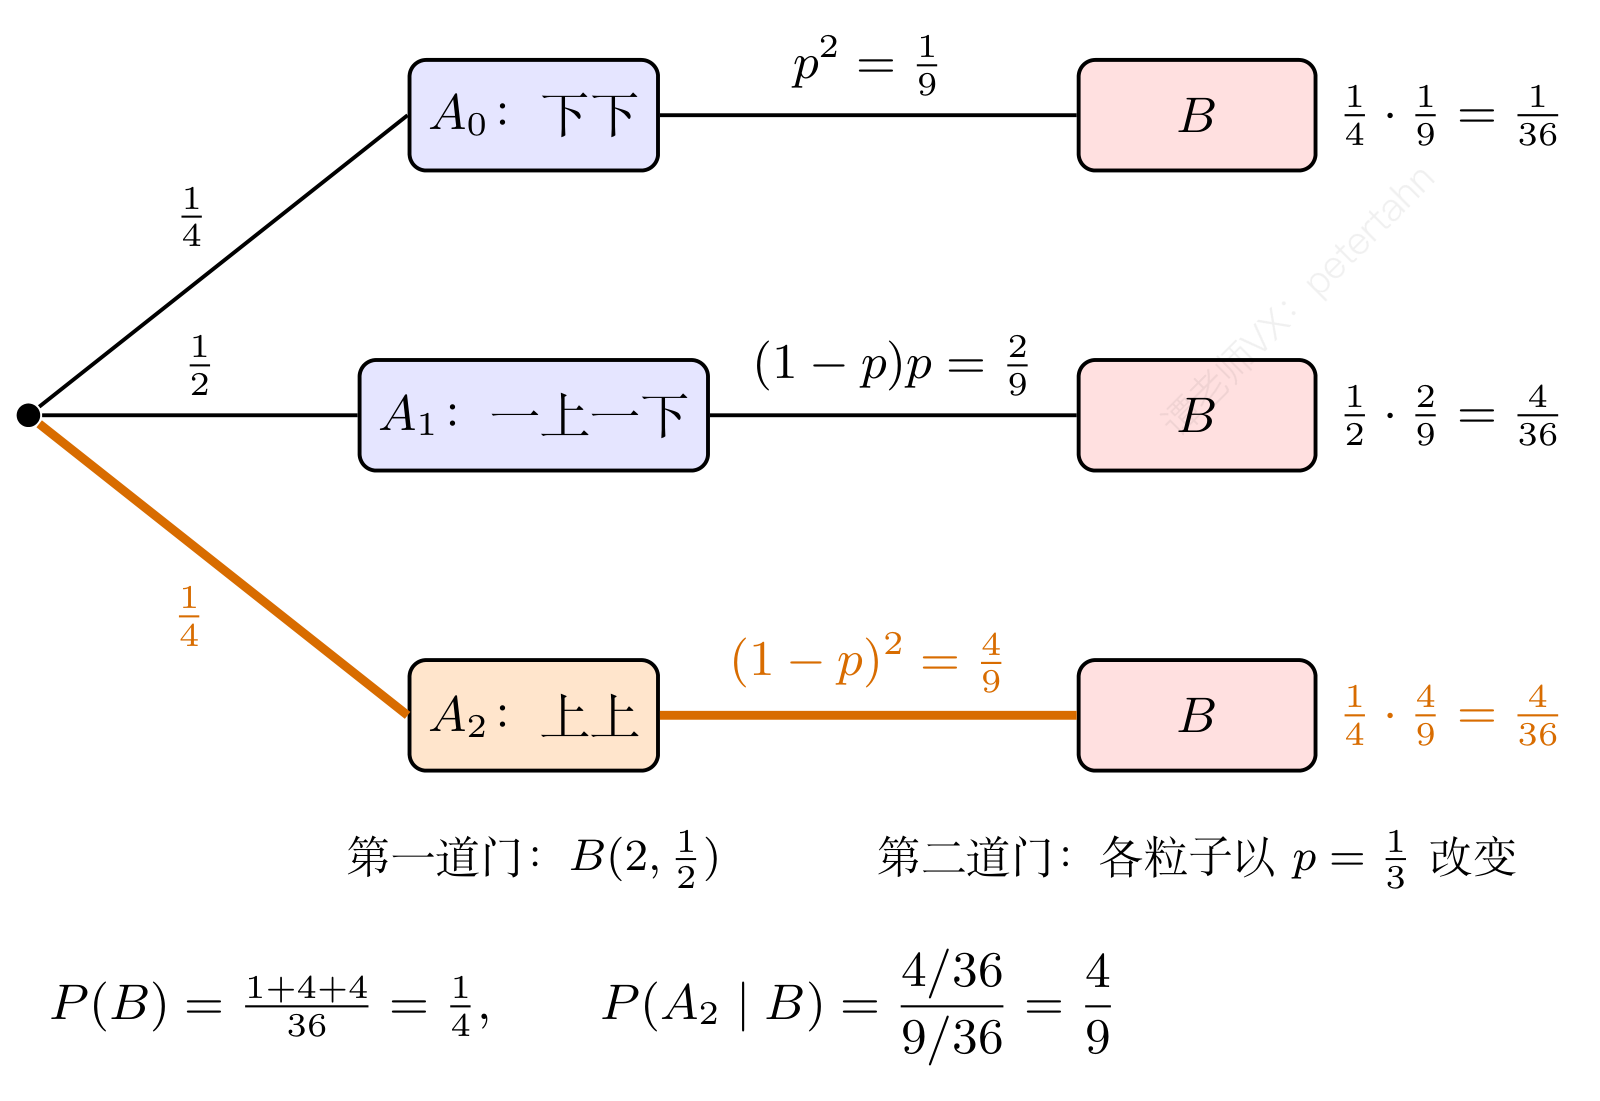
专题 14

独立性检验:实际频数离“独立时的期望频数”有多远

先假设两个分类变量无关,算出每格“应该有”多少;再用 $\chi^2$ 衡量观测与期望的总偏差。偏差大到“独立时很少见”,就拒绝无关的假设。

看见:观测 vs 期望

2×2 列联表

以“预防药 Φ 与感染”的数据为例(共 100 只动物)。每格先写观测频数,括号内是 $H_0$(独立)成立时的期望频数 $\dfrac{\text{行和}\times\text{列和}}{n}$。

感染 未感染 合计
未使用 Φ 22(期望 17.10) 23(期望 27.90) 45
使用 Φ 16(期望 20.90) 39(期望 34.10) 55
合计 38 62 100

“未使用 Φ·感染”与“使用 Φ·未感染”两格的观测频数高于期望(偏多),另两格低于期望(偏少)。

马赛克图:两条横条分别是“未使用 Φ”“使用 Φ”两行,橙色部分为感染所占比例(48.9%、29.1%),浅蓝部分为未感染;黑色虚线是合并后的总体感染比例 38.0%。若两变量独立,两行的橙色部分都应与虚线对齐,图中明显偏离。
图 1马赛克图:两条横条分别是“未使用 Φ”“使用 Φ”两行,橙色部分为感染所占比例(48.9%、29.1%),浅蓝部分为未感染;黑色虚线是合并后的总体感染比例 38.0%。若两变量独立,两行的橙色部分都应与虚线对齐,图中明显偏离。

计算

$$ \begin{aligned} \chi^2&=\frac{n(ad-bc)^2}{(a+b)(c+d)(a+c)(b+d)}\\ &=\frac{100\times(22\times39-23\times16)^2}{45\times55\times38\times62}\\ &=\frac{100\times490^2}{5831100}\approx4.118 \end{aligned} $$

对应的 $p$ 值 $P(\chi^2\ge4.118)\approx0.0424$。

$4.118\ge3.841$:拒绝 $H_0$,认为有关联(犯错误概率不超过 $0.05$)。

自由度为 1 的 \chi^2 密度曲线(绿色;曲线在 0 附近趋于无穷,纵轴已截断)。橙色虚线是 \alpha=0.05 的临界值 3.841,其右侧红色阴影为拒绝域,面积 0.050;红色竖线是观测值 4.118,落在拒绝域内。
图 2自由度为 1 的 $\chi^2$ 密度曲线(绿色;曲线在 0 附近趋于无穷,纵轴已截断)。橙色虚线是 $\alpha=0.05$ 的临界值 3.841,其右侧红色阴影为拒绝域,面积 0.050;红色竖线是观测值 4.118,落在拒绝域内。

换一个显著性水平

同一个观测值 $\chi^2\approx4.118$,换不同的显著性水平 $\alpha$,与之对应的临界值 $x_\alpha$ 和结论如下:

$\alpha$ 临界值 $x_\alpha$ 比较 结论
0.1 2.706 $4.118\ge2.706$ 拒绝 $H_0$,认为有关联(犯错误概率不超过 0.1)
0.05 3.841 $4.118\ge3.841$ 拒绝 $H_0$,认为有关联(犯错误概率不超过 0.05)
0.01 6.635 $4.118<6.635$ 没有充分证据推断有关联
0.005 7.879 $4.118<7.879$ 没有充分证据推断有关联
0.001 10.828 $4.118<10.828$ 没有充分证据推断有关联

另外两组数据的对照

性别与打结快慢(即例 3 的数据,$n=200$):

快 慢 合计
男生 65(期望 55.00) 35(期望 45.00) 100
女生 45(期望 55.00) 55(期望 45.00) 100
合计 110 90 200

$$ \chi^2=\frac{200\times(65\times55-35\times45)^2}{100\times100\times110\times90}=\frac{200\times2000^2}{99000000}\approx8.081,\qquad p\approx0.0045 $$

$8.081\ge3.841$:拒绝 $H_0$,认为有关联(犯错误概率不超过 $0.05$)。

接近独立的一组数据($n=150$):

是 否 合计
A 组 30(期望 29.40) 40(期望 40.60) 70
B 组 33(期望 33.60) 47(期望 46.40) 80
合计 63 87 150

$$ \chi^2=\frac{150\times(30\times47-40\times33)^2}{70\times80\times63\times87}=\frac{150\times90^2}{30693600}\approx0.040,\qquad p\approx0.8423 $$

$0.040<3.841$:没有充分证据推断有关联。

接近独立数据的马赛克图:A 组“是”的比例 42.9%,B 组 41.3%,两行的橙色部分都几乎落在总体比例 42.0% 的黑色虚线上,与上一组 Φ 数据中两行明显分开形成对照。
图 3接近独立数据的马赛克图:A 组“是”的比例 42.9%,B 组 41.3%,两行的橙色部分都几乎落在总体比例 42.0% 的黑色虚线上,与上一组 Φ 数据中两行明显分开形成对照。

推导:$\chi^2$ 公式

从“期望频数”推出教材公式

  1. 记表格 $\begin{smallmatrix}a&b\\c&d\end{smallmatrix}$,$n=a+b+c+d$。零假设 $H_0$:$X$ 与 $Y$ 相互独立。
  2. $H_0$ 下 $P(X=x_i,Y=y_j)=P(X=x_i)P(Y=y_j)$,用频率估计:左上格的期望频数 $$E_{11}=n\cdot\frac{a+b}n\cdot\frac{a+c}n=\frac{(a+b)(a+c)}{n}$$

    独立 $\Rightarrow$ 联合概率 = 边缘概率之积

  3. 左上格偏差: $$a-E_{11}=\frac{an-(a+b)(a+c)}{n}=\frac{ad-bc}{n}$$

    $an-(a+b)(a+c)$ 展开后只剩 $ad-bc$

  4. 四格偏差的绝对值相同、符号交替:$O_{ij}-E_{ij}=\pm\dfrac{ad-bc}{n}$。

    每行、每列偏差之和为 $0$(行和、列和固定)

  5. 皮尔逊统计量:每格偏差平方再除以期望(相对偏差),四格相加: $$\chi^2=\sum_{i,j}\frac{(O_{ij}-E_{ij})^2}{E_{ij}}=\frac{(ad-bc)^2}{n^2}\sum_{i,j}\frac1{E_{ij}}$$

    除以 $E$:期望 1000 时差 10 不算大,期望 5 时差 10 就很大

  6. $\displaystyle\sum\frac1{E_{ij}}=\frac{n}{(a+b)(a+c)}+\cdots=\frac{n^3}{(a+b)(c+d)(a+c)(b+d)}$,代入得 $$\boxed{\chi^2=\frac{n(ad-bc)^2}{(a+b)(c+d)(a+c)(b+d)}}$$

    四个分数通分,分子 $(c+d)(b+d)+(c+d)(a+c)+(a+b)(b+d)+(a+b)(a+c)=n^2$

  7. 新教材记作 $\chi^2$,旧教材记作 $K^2$,公式相同。$H_0$ 成立且样本量较大时,$\chi^2$ 近似服从自由度为 1 的 $\chi^2$ 分布,临界值 $x_\alpha$ 满足 $P(\chi^2\ge x_\alpha)=\alpha$。
  8. 判断规则:$\chi^2\ge x_\alpha$ 时拒绝 $H_0$,认为 $X$ 与 $Y$ 有关联,此推断犯错误的概率不超过 $\alpha$;否则没有充分证据推断有关联。

验证:四格偏差相同、$\chi^2$ 两种算法一致

仍用 Φ 的数据,四格的 $O-E$ 如下:

感染 未感染
未使用 Φ $O-E=22-17.10=\mathbf{+4.90}$ $O-E=23-27.90=\mathbf{-4.90}$
使用 Φ $O-E=16-20.90=\mathbf{-4.90}$ $O-E=39-34.10=\mathbf{+4.90}$

$$ \begin{aligned} \frac{ad-bc}{n}&=\frac{490}{100}=4.90\\ \sum\frac{(O-E)^2}{E}&\approx4.118,\quad\text{公式}\approx4.118 \end{aligned} $$

样本量的作用

各格频数都乘 $k$,比例不变,但 $\chi^2$ 也乘 $k$。同样的比例差异,样本越大越能确认“不是偶然”。

分布:独立时 $\chi^2$ 长什么样

在 $H_0$ 成立的世界里反复调查,$\chi^2$ 的取值分布

按上文列联表的行和与列比例,在两变量真的独立的条件下随机生成样本,计算每次的 $\chi^2$。重复 2000 次调查,结果如下图。

蓝色直方图是 H_0 成立时 2000 次模拟所得 \chi^2 的频率分布,绿色曲线是自由度为 1 的 \chi^2 密度,二者吻合;橙色虚线为临界值 3.841,红色阴影为其右侧的拒绝域(面积 0.050),红色竖线为观测值 4.118。
图 4蓝色直方图是 $H_0$ 成立时 2000 次模拟所得 $\chi^2$ 的频率分布,绿色曲线是自由度为 1 的 $\chi^2$ 密度,二者吻合;橙色虚线为临界值 3.841,红色阴影为其右侧的拒绝域(面积 0.050),红色竖线为观测值 4.118。

读数

  • 模拟次数:2000
  • $\chi^2\ge3.841$ 的频率:0.0575(理论 $\alpha=0.05$)
  • $\chi^2\ge$ 观测值 4.118 的频率:0.0455
提示

直方图(蓝)与自由度 1 的 $\chi^2$ 密度曲线(绿)吻合。橙色竖线 3.841 右侧的面积约 5%:即使两变量真的无关,每 20 次调查约有 1 次会得到 $\chi^2\ge3.841$。这就是“犯错误的概率不超过 $0.05$”。

注意

“小概率事件在一次试验中几乎不会发生”:如果观测到的 $\chi^2$ 落在右侧尾部,我们宁可怀疑 $H_0$,而不是相信自己碰上了小概率事件。

辨析:结论怎么写

标准五步与规范表述

  1. 提出假设:$H_0$:$X$ 与 $Y$ 独立(无关)。
  2. 列表:补全 2×2 列联表,写出 $a,b,c,d,n$。
  3. 计算:$\chi^2=\dfrac{n(ad-bc)^2}{(a+b)(c+d)(a+c)(b+d)}$,保留三位小数。
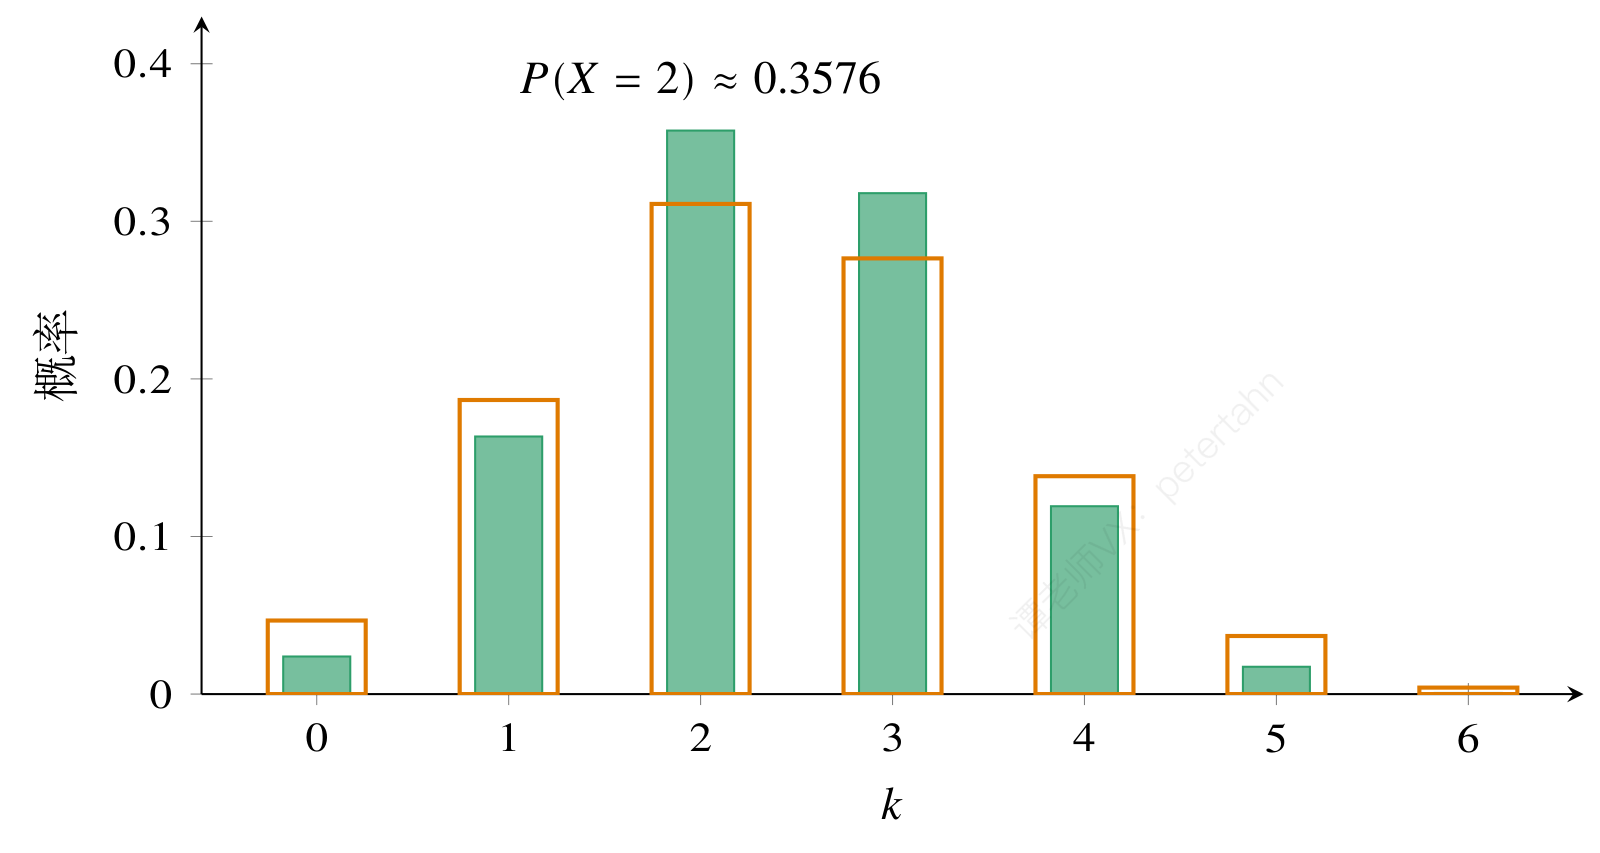
  4. 比较:与给定 $\alpha$ 的临界值 $x_\alpha$ 比较。
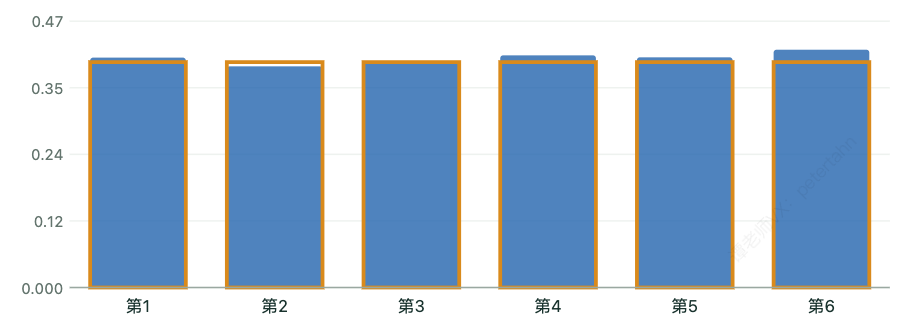
  5. 结论:
    • $\chi^2\ge x_\alpha$:“根据小概率值 $\alpha=\underline{\quad\ }$ 的独立性检验,推断 $H_0$ 不成立,即认为 $X$ 与 $Y$ 有关联,该推断犯错误的概率不超过 $\alpha$”。
    • $\chi^2<x_\alpha$:“没有充分证据推断 $H_0$ 不成立,可以认为 $X$ 与 $Y$ 独立”。

常见错误表述

易错

“有 95% 的概率 $X$ 与 $Y$ 有关”——错。$\alpha$ 控制的是“$H_0$ 成立时却被拒绝”的概率,不是“有关”这个结论本身的概率。

易错

“$\chi^2$ 小于临界值,所以证明了 $X$ 与 $Y$ 无关”——错。只能说证据不足;样本太小时,真实存在的关联也可能检验不出来(见例 3(2))。

易错

“有关联,所以 $X$ 导致 $Y$”——错。独立性检验只说明关联,不说明因果;“有效”还要结合偏差方向(例如用药组感染偏少)。

注意

计算时最常见的错误:$ad-bc$ 写成 $ac-bd$;分母漏乘某个和;最后没有和题目给定的 $\alpha$ 对应的临界值比较。

例题精讲

例 12022 全国新高考 I 卷

病例组 100 例、对照组 100 人的卫生习惯调查如下表。

(1)能否有 99% 的把握认为两组卫生习惯有差异?

(2)任选一人,$A$:卫生习惯不够良好,$B$:患该疾病。记 $$R=\frac{P(B\mid A)}{P(\bar B\mid A)}\Big/\frac{P(B\mid\bar A)}{P(\bar B\mid\bar A)}$$

(i) 证明 $R=\dfrac{P(A\mid B)}{P(\bar A\mid B)}\cdot\dfrac{P(\bar A\mid\bar B)}{P(A\mid\bar B)}$;

(ii) 估计 $P(A\mid B)$、$P(A\mid\bar B)$ 与 $R$。

原题数据:病例组中卫生习惯不够良好 40 例、良好 60 例;对照组中不够良好 10 人、良好 90 人。
图 5原题数据:病例组中卫生习惯不够良好 40 例、良好 60 例;对照组中不够良好 10 人、良好 90 人。
建模思路

调查是“按病分组”抽样的:能估计的是 $P(A\mid B)$(病例组里习惯差的比例),不能直接估计 $P(B\mid A)$。(i) 的恒等式正是把“想要的” $R$ 换成“能估计的”量——这是贝叶斯思想的典型应用。

解析

(1)独立性检验

  1. $a=40,\ b=60,\ c=10,\ d=90,\ n=200$。
  2. $$K^2=\frac{200(40\times90-60\times10)^2}{100\times100\times50\times150}=\frac{200\times3000^2}{7.5\times10^7}=24$$
  3. $24>6.635$,所以有 99% 的把握认为两组卫生习惯有差异。

    “有差异”= 拒绝“无关”的原假设

答案:有 99% 的把握认为有差异。

(2)(i) 证明恒等式

  1. 同一条件下的比值,分母 $P(A)$ 约掉: $$\frac{P(B\mid A)}{P(\bar B\mid A)}=\frac{P(AB)/P(A)}{P(A\bar B)/P(A)}=\frac{P(AB)}{P(A\bar B)}$$

    核心技巧:同条件的两个条件概率之比 = 交事件概率之比

  2. 同理 $\dfrac{P(B\mid\bar A)}{P(\bar B\mid\bar A)}=\dfrac{P(\bar AB)}{P(\bar A\bar B)}$,所以 $$R=\frac{P(AB)\,P(\bar A\bar B)}{P(A\bar B)\,P(\bar AB)}$$

    这个对称形式就是“交叉乘积比”,即统计中的优势比 OR

  3. 重新分组,按条件 $B$、$\bar B$ 引入分母: $$R=\frac{P(AB)/P(B)}{P(\bar AB)/P(B)}\cdot\frac{P(\bar A\bar B)/P(\bar B)}{P(A\bar B)/P(\bar B)}=\frac{P(A\mid B)}{P(\bar A\mid B)}\cdot\frac{P(\bar A\mid\bar B)}{P(A\mid\bar B)}$$

答案:证毕。

(2)(ii) 估计 $R$

  1. 病例组中习惯不够良好的频率估计 $P(A\mid B)=\dfrac{40}{100}=0.4$;对照组中估计 $P(A\mid\bar B)=\dfrac{10}{100}=0.1$。
  2. 补集:$P(\bar A\mid B)=0.6$,$P(\bar A\mid\bar B)=0.9$。
  3. $$R=\frac{0.4}{0.6}\times\frac{0.9}{0.1}=6$$ 也等于交叉乘积比 $\dfrac{ad}{bc}=\dfrac{40\times90}{60\times10}=6$。

    $R$ 与列联表的 $ad/bc$ 一致,可作检验

答案:$P(A\mid B)=0.4,\ P(A\mid\bar B)=0.1,\ R=6$。

易错点

用 $\dfrac{40}{50}$ 去估计 $P(B\mid A)$——这里病例组、对照组人数是人为定的各 100 人,表中纵向比例不能代表人群患病率。

例 22024 东北三省押题(二)

随机选取 100 个动物试验样本,得到列联表:

预防药品 Φ 感染 未感染 合计
未使用 22 23 45
使用 16 39 55
合计 38 62 100

(1)根据 $\alpha=0.05$ 的独立性检验,分析预防药品 Φ 对预防甲流的有效性;

(2)用频率估计概率(保留一位有效数字)。从已感染动物中每次随机选 1 只,用治疗药品 Ψ 治疗:对未用过 Φ 的治愈率 0.5,用过 Φ 的治愈率 0.75。共选 3 只(相互独立),记治愈只数为 $X$,求 $X$ 的分布列与期望。

附:$x_{0.05}=3.841$。

建模思路

(1) 是标准的五步:零假设 → 算 $\chi^2$ → 与临界值比较 → 下结论(带上犯错概率)。(2) 先用全概率求“一只被治愈”的概率,再识别二项分布。

解析

(1)独立性检验

  1. 零假设 $H_0$:使用 Φ 与是否感染相互独立(即 Φ 无效)。
  2. $a=22,b=23,c=16,d=39,n=100$: $$\chi^2=\frac{100\times(22\times39-23\times16)^2}{45\times55\times38\times62}=\frac{100\times490^2}{5831100}\approx4.118$$

    $ad-bc=858-368=490$

  3. 期望频数对照:若独立,未使用组中应有 $45\times\dfrac{38}{100}=17.1$ 只感染,实际 22 只,偏多;使用组应有 20.9 只,实际 16 只,偏少。

    看偏差方向,才能说“有效”而不只是“有关”

  4. $4.118>3.841=x_{0.05}$,拒绝 $H_0$。认为 Φ 与感染有关联,此推断犯错误的概率不超过 0.05;结合偏差方向,可认为 Φ 有预防效果。

答案:$\chi^2\approx4.118>3.841$,认为预防药品 Φ 有效(犯错概率不超过 0.05)。

(2)$X$ 的分布列与期望

  1. 已感染的 38 只中:未用 Φ 的频率 $\dfrac{22}{38}\approx0.6$,用过 Φ 的 $\dfrac{16}{38}\approx0.4$。

    分母是已感染的 38 只,不是 100

  2. 全概率:$p=0.6\times0.5+0.4\times0.75=0.6$。

    若不舍入,$p=0.6053$;题目要求保留一位有效数字,所以取 $0.6$

  3. $X\sim B(3,0.6)$:$P(X=k)=\mathrm{C}_3^k\,0.6^k\,0.4^{3-k}$,即 $$P(X=0)=\tfrac{8}{125},\ P(X=1)=\tfrac{36}{125},\ P(X=2)=\tfrac{54}{125},\ P(X=3)=\tfrac{27}{125}$$
  4. $E(X)=3\times0.6=\dfrac95$。

答案:$X\sim B(3,0.6)$,$E(X)=\dfrac95$。

易错点

结论不能写“Φ 一定有效”或“有 95% 的概率有效”:独立性检验控制的是“$H_0$ 成立却被拒绝”的概率不超过 $\alpha$。

例 32024 宁波高考模拟(节选第 1 问)

随机抽取 200 名学生参加绳子打结计时比赛,分析性别与打结速度快慢的关系。部分数据如下表:

性别 快 慢 合计
男生 65
女生 55
合计 110 200

(1)补全列联表,判断能否有 99% 的把握认为性别与打结速度快慢有关($x_{0.01}=6.635$);

(2)(追问)若只调查 20 人且各格频数都按比例缩小为原来的 $\tfrac1{10}$,结论如何?

建模思路

补表只用“行和、列和”两个约束;$\chi^2$ 的公式分子有 $n$,同比例放大样本,$\chi^2$ 同倍放大——同样的比例差异,样本越大越“显著”。

解析

(1)补全列联表并检验

  1. 女快 $=110-65=45$,慢合计 $=200-110=90$,男慢 $=90-55=35$;男合计 $65+35=100$,女合计 $45+55=100$。
  2. $H_0$:性别与打结速度无关。 $$\chi^2=\frac{200\times(65\times55-35\times45)^2}{100\times100\times110\times90}=\frac{200\times2000^2}{9.9\times10^7}=\frac{800}{99}\approx8.081$$

    $ad-bc=3575-1575=2000$

  3. $8.081>6.635$,拒绝 $H_0$:有 99% 的把握认为性别与打结速度有关(犯错概率不超过 0.01)。

答案:$\chi^2=\dfrac{800}{99}\approx8.081>6.635$,有 99% 的把握认为有关。

(2)样本缩小为 $\tfrac1{10}$

  1. 各格变为 $6.5,3.5,4.5,5.5$。设各频数都乘 $k$:分子 $kn\cdot(k^2)^2(ad-bc)^2$,分母 $k^4(a+b)(c+d)(a+c)(b+d)$,所以 $\chi^2$ 乘 $k$。

    比例不变时,$\chi^2$ 与样本量成正比

  2. $\chi^2=\dfrac{8.081}{10}\approx0.808<2.706$,在 $\alpha=0.1$ 下都不能拒绝 $H_0$。

    小样本时同样的差异可能只是偶然,证据不足

答案:$\chi^2\approx0.808$,没有充分证据认为有关。

易错点

“没有充分证据认为有关”不等于“证明了无关”。另外,频数太小时 $\chi^2$ 近似不可靠(教材要求各格期望频数不宜太小),(2)只用来说明 $\chi^2$ 与 $n$ 的关系。

课堂小测

课堂小测

根据列联表算得 $\chi^2\approx5.02$,下列结论正确的是($x_{0.05}=3.841,\ x_{0.01}=6.635$)

查看答案与解析

答案C

解析

$5.02\ge3.841$,在 $\alpha=0.05$ 下拒绝 $H_0$;犯错误的概率不超过 $0.05$。

辨析
  • A:$5.02<6.635$,在 $\alpha=0.01$ 下不能拒绝 $H_0$
  • B:$\alpha$ 不是“有关”这个结论的概率
  • D:$\chi^2$ 未超过 $6.635$ 只说明 $\alpha=0.01$ 下证据不足,不能“证明无关”。
课堂小测

2×2 列联表中 $a=20,b=30,c=30,d=20$,则左上格的期望频数为

查看答案与解析

答案A

解析

$E_{11}=\dfrac{(a+b)(a+c)}n=\dfrac{50\times50}{100}=25$。

辨析
  • B:$20$ 是观测频数,不是期望频数
  • C:期望频数用行和 × 列和 ÷ $n$,不是行和的一半再加偏差
  • D:$ad-bc=400-900=-500$,偏差为 $-500/100=-5$,期望为 $25$,不是 $-5$。
课堂小测

列联表各格频数都扩大为原来的 3 倍,则 $\chi^2$

查看答案与解析

答案D

解析

分子 $3^5$、分母 $3^4$,$\chi^2$ 变为原来的 3 倍。

辨析
  • A:比例不变,但 $\chi^2$ 与样本量成正比,不会保持不变
  • B:分子 $n(ad-bc)^2$ 是 $3\cdot3^4=243$ 倍,分母是 $3^4=81$ 倍,比值为 $3$,不是 $9$
  • C:样本越大,相同比例差异越显著,$\chi^2$ 变大,不会变小。
专题 15

大数定律与中心极限定理:频率为什么稳定,均值为什么像正态

大数定律说“样本均值会靠近总体均值”;中心极限定理进一步说“靠近时的偏差长成正态的样子,宽度按 $1/\sqrt n$ 缩小”。(拓展内容,超出高中要求)

看见:频率随 $n$ 稳定

多条频率轨迹:每条线是一个人独立地做 $n$ 次伯努利试验

成功概率 p=0.3,6 个人各自独立地做伯努利试验,横轴为试验次数 n(对数刻度,最大取到 10^4),纵轴为频率 m/n。彩色折线是 6 条频率轨迹;黑色水平线是真实概率 p;绿色虚线围成的浅绿带是包络 p\pm2\sqrt{p(1-p)/n}。开头几步轨迹大幅乱跳,随 n 增大全部被“夹”向 p。
图 1成功概率 $p=0.3$,6 个人各自独立地做伯努利试验,横轴为试验次数 $n$(对数刻度,最大取到 $10^4$),纵轴为频率 $m/n$。彩色折线是 6 条频率轨迹;黑色水平线是真实概率 $p$;绿色虚线围成的浅绿带是包络 $p\pm2\sqrt{p(1-p)/n}$。开头几步轨迹大幅乱跳,随 $n$ 增大全部被“夹”向 $p$。

包络的半宽随 $n$ 缩小。以 $p=0.3$ 为例:

$$p\pm\frac{2\sqrt{p(1-p)}}{\sqrt n}\ \xrightarrow{\ n=10000\ }\ 0.30\pm0.0092$$

最大试验次数 $n$ $10^3$ $10^4$ $10^5$
包络半宽 $2\sqrt{p(1-p)/n}$ $0.0290$ $0.0092$ $0.0029$
思路

横轴是对数刻度:$n$ 每乘 $100$,包络宽度缩成 $\dfrac1{10}$。开头几步轨迹乱跳,越往后越被“夹”向 $p$,这就是频率的稳定性。

提示

包络为什么是 $2\sqrt{p(1-p)/n}$?因为 $m\sim B(n,p)$,频率 $\dfrac mn$ 的方差是 $\dfrac{p(1-p)}{n}$,标准差按 $\dfrac1{\sqrt n}$ 缩小。下一步用切比雪夫不等式把这一点说严谨。

注意

“前面正面多了,后面反面就会多一些来补”是赌徒谬误。各次独立,过去的偏差不会被“补回来”,只是被后来大量的试验稀释了:偏离次数 $|m-np|$ 往往还会变大(约 $\sqrt n$ 量级),但除以 $n$ 后趋于 $0$。

推导:切比雪夫与大数定律

从方差的定义推出切比雪夫不等式,再推出大数定律

  1. 设离散型随机变量 $X$ 取值 $x_i$ 的概率为 $p_i$,$E(X)=\mu$。由方差定义 $$D(X)=\sum_i (x_i-\mu)^2p_i$$

    方差是“偏差平方”的加权平均,每一项都非负

  2. 只保留偏差较大($|x_i-\mu|\ge\varepsilon$)的项,和会变小或不变: $$D(X)\ge\sum_{|x_i-\mu|\ge\varepsilon}(x_i-\mu)^2p_i$$

    丢掉的都是非负项

  3. 这些项里 $(x_i-\mu)^2\ge\varepsilon^2$,再缩小一次: $$D(X)\ge\varepsilon^2\sum_{|x_i-\mu|\ge\varepsilon}p_i=\varepsilon^2P(|X-\mu|\ge\varepsilon)$$
  4. 切比雪夫不等式: $$\begin{aligned} P(|X-\mu|\ge\varepsilon)&\le\frac{D(X)}{\varepsilon^2}\\ P(|X-\mu|<\varepsilon)&\ge1-\frac{D(X)}{\varepsilon^2} \end{aligned}$$

    只用到期望和方差,对任何分布都成立;代价是界很“松”(见下面的图对照)

  5. 用于频率:$m\sim B(n,p)$, $$E\!\left(\frac mn\right)=p,\qquad D\!\left(\frac mn\right)=\frac{np(1-p)}{n^2}=\frac{p(1-p)}{n}$$

    $D(aX)=a^2D(X)$,二项分布方差 $np(1-p)$

  6. 代入: $$P\!\left(\left|\frac mn-p\right|\ge\varepsilon\right)\le\frac{p(1-p)}{n\varepsilon^2}\le\frac{1}{4n\varepsilon^2}$$

    $p(1-p)\le\dfrac14$(二次函数在 $p=\dfrac12$ 取最大)

  7. 无论 $\varepsilon$ 多小,$n\to\infty$ 时右边 $\to0$: $$\lim_{n\to\infty}P\!\left(\left|\frac mn-p\right|<\varepsilon\right)=1$$ 这就是伯努利大数定律:频率依概率收敛于概率。
  8. 一般地,$X_1,\dots,X_n$ 独立同分布、$E(X_i)=\mu$、$D(X_i)=\sigma^2$,则 $D(\bar X)=\dfrac{\sigma^2}{n}$,同理 $P(|\bar X-\mu|\ge\varepsilon)\le\dfrac{\sigma^2}{n\varepsilon^2}\to0$。

    独立才有 $D(X_1+\cdots+X_n)=n\sigma^2$;这就是“多次测量取平均”更准的理由

切比雪夫上界 vs 精确概率:频率 $m/n$ 的分布

n=100、p=0.5、\varepsilon=0.1 时频率 m/n 的二项分布柱状图。红色柱是尾部 |m/n-p|\ge\varepsilon,蓝色柱是 |m/n-p|<\varepsilon;橙色虚线标出 p\pm\varepsilon(0.4 与 0.6),黑色竖线是 p=0.5。红色尾部的总面积远小于切比雪夫给出的上界。
图 2$n=100$、$p=0.5$、$\varepsilon=0.1$ 时频率 $m/n$ 的二项分布柱状图。红色柱是尾部 $|m/n-p|\ge\varepsilon$,蓝色柱是 $|m/n-p|<\varepsilon$;橙色虚线标出 $p\pm\varepsilon$($0.4$ 与 $0.6$),黑色竖线是 $p=0.5$。红色尾部的总面积远小于切比雪夫给出的上界。

取 $n=100$,$p=0.5$,$\varepsilon=0.1$:精确尾概率(二项分布)为 $0.0569$;切比雪夫上界为

$$P\!\left(\left|\frac mn-0.50\right|\ge0.10\right)\le\frac{0.50\times0.50}{100\times0.10^2}=0.2500$$

提示

后面例 1 中 $n=1250$:切比雪夫只保证尾概率 $\le0.02$,而精确值几乎为 $0$。实际上 $n=132$ 就已经够了。切比雪夫“偏保守”,但它对任何分布都对,用来证明极限足够了。

模拟:样本均值的分布

每次抽 $n$ 个求平均,重复 4000 次,看 $\bar x$ 的直方图

总体为 \mathrm{Exp}(1),四格分别取 n=1,5,20,50,每格重复 4000 次抽样求均值。蓝色密度直方图对照红色 N(1,1/n) 密度,黑色虚线为均值 1;n 越大越对称、越窄、越贴近红线。
图 3总体为 $\mathrm{Exp}(1)$,四格分别取 $n=1,5,20,50$,每格重复 4000 次抽样求均值。蓝色密度直方图对照红色 $N(1,1/n)$ 密度,黑色虚线为均值 1;$n$ 越大越对称、越窄、越贴近红线。

总体分布(原始的“一个”观测值)

下面考察四种总体。每种总体的单个观测值分布如下(左上:指数 $\mathrm{Exp}(1)$;右上:均匀 $U(0,1)$;左下:二项 $B(5,0.2)$;右下:偏态离散,取值 $0,1,2,10$):

指数总体 \mathrm{Exp}(1) 的密度 e^{-x}(x\ge0),右偏,\mu=\sigma=1。
图 4指数总体 $\mathrm{Exp}(1)$ 的密度 $e^{-x}$($x\ge0$),右偏,$\mu=\sigma=1$。
均匀总体 U(0,1) 的密度:区间 [0,1] 上恒为 1,对称,\mu=0.5。
图 5均匀总体 $U(0,1)$ 的密度:区间 $[0,1]$ 上恒为 $1$,对称,$\mu=0.5$。
二项总体 B(5,0.2) 的概率分布:取值 0,1,2,3,4,5,集中在 0,1,2,轻度右偏。
图 6二项总体 $B(5,0.2)$ 的概率分布:取值 $0,1,2,3,4,5$,集中在 $0,1,2$,轻度右偏。
偏态离散总体的概率分布:取值 0,1,2,10,概率依次为 0.5,0.3,0.15,0.05,极端右偏。
图 7偏态离散总体的概率分布:取值 $0,1,2,10$,概率依次为 $0.5,0.3,0.15,0.05$,极端右偏。

样本均值 $\bar X$ 的均值、标准差、偏度的理论值依次为 $\mu$、$\dfrac{\sigma}{\sqrt n}$、$\dfrac{\gamma}{\sqrt n}$($\gamma$ 为总体偏度)。$n=1$ 时就是总体本身:

总体 $\mu$ $\sigma$ 偏度 $\gamma$
均匀 $U(0,1)$ $0.5000$ $0.2887$ $0.000$
指数 $\mathrm{Exp}(1)$ $1.0000$ $1.0000$ $2.000$
二项 $B(5,0.2)$ $1.0000$ $0.8944$ $0.671$
偏态离散 $\{0,1,2,10\}$ $1.1000$ $2.1656$ $3.416$

$$\bar X\ \dot\sim\ N\!\left(\mu,\frac{\sigma^2}{n}\right)$$

$n=1$ 时,四种总体对应的正态近似依次为 $N(0.5,\ 0.2887^2)$、$N(1,\ 1.0000^2)$、$N(1,\ 0.8944^2)$、$N(1.1,\ 2.1656^2)$。

中心极限定理

独立同分布、方差有限,则 $n$ 较大时 $\bar X$ 近似服从 $N\!\left(\mu,\dfrac{\sigma^2}{n}\right)$,不管总体长什么样。

$n$ 从 $1$ 增大到 $50$:均匀总体 $n\approx5$ 就很像正态,指数总体要 $20$ 左右,偏态离散总体更慢。

提示

偏度(衡量不对称)按 $\gamma/\sqrt n$ 衰减:总体越偏,需要的 $n$ 越大。高中“二项分布近似正态”是它的特例:$B(n,p)$ 就是 $n$ 个两点分布之和。

标准化:与 $N(0,1)$ 对照

标准化:$Z=\dfrac{\bar x-\mu}{\sigma/\sqrt n}$,所有总体都对照同一条 $N(0,1)$

偏态离散总体(取值 0,1,2,10)、n=5 时,4000 个标准化样本均值 Z 的直方图(蓝色柱)与标准正态密度 \varphi(z)(红色曲线)。直方图呈“一根根”的格点状、明显右偏,与红线差得很远。
图 8偏态离散总体(取值 $0,1,2,10$)、$n=5$ 时,4000 个标准化样本均值 $Z$ 的直方图(蓝色柱)与标准正态密度 $\varphi(z)$(红色曲线)。直方图呈“一根根”的格点状、明显右偏,与红线差得很远。
同一偏态离散总体在 n=50 时的标准化样本均值:4000 次模拟的蓝色密度直方图与红色标准正态密度对照;分箱与离散格点对齐。
图 9同一偏态离散总体在 $n=50$ 时的标准化样本均值:4000 次模拟的蓝色密度直方图与红色标准正态密度对照;分箱与离散格点对齐。
均匀总体 U(0,1)、n=5 时,4000 个标准化样本均值 Z 的直方图(蓝色柱)与标准正态密度 \varphi(z)(红色曲线)。此时已与红线相当贴合。
图 10均匀总体 $U(0,1)$、$n=5$ 时,4000 个标准化样本均值 $Z$ 的直方图(蓝色柱)与标准正态密度 $\varphi(z)$(红色曲线)。此时已与红线相当贴合。

$3\sigma$ 原则还成立吗

取 $n=5$,对四种总体各模拟 $4000$ 次,$|Z|$ 落在不同范围内的频率与 $N(0,1)$ 的理论值对照:

均匀 $U(0,1)$ 指数 $\mathrm{Exp}(1)$ 二项 $B(5,0.2)$ 偏态离散 $N(0,1)$
$P(\lvert Z\rvert \le 1)$ $0.6697$ $0.7065$ $0.7940$ $0.7625$ $0.6827$
$P(\lvert Z\rvert \le 1.96)$ $0.9533$ $0.9527$ $0.9290$ $0.9520$ $0.9500$
$P(\lvert Z\rvert \le 3)$ $0.9982$ $0.9890$ $0.9985$ $0.9788$ $0.9973$
  1. 为什么要标准化:$E(\bar X)=\mu$,$D(\bar X)=\dfrac{\sigma^2}{n}$,所以 $Z=\dfrac{\bar X-\mu}{\sigma/\sqrt n}$ 满足 $E(Z)=0$,$D(Z)=1$。

    先把“位置”和“宽度”统一掉,剩下的差别只有“形状”

  2. 中心极限定理说的正是形状:$n\to\infty$ 时 $P(Z\le z)\to\Phi(z)$。

    大数定律管“集中到 $\mu$”,中心极限定理管“集中时的形状”

  3. 于是 $P\!\left(|\bar X-\mu|\le1.96\,\dfrac{\sigma}{\sqrt n}\right)\approx0.95$——这一句就是下一模块“置信区间”的出发点。
注意

偏态离散总体 $n$ 小时,上表的模拟值与 $N(0,1)$ 差得明显,且直方图是“一根根”的($\bar x$ 只能取格点值)。$n$ 增大到 $50$ 以上才比较贴合。用正态近似前要掂量 $n$ 够不够大。

例题精讲

例 12024 重庆七中高三 12 月月考

在数字通信中,信号由数字“0”和“1”组成。连续发射信号 $n$ 次,每次发射“0”和“1”等可能,记发射信号 1 的次数为 $X$。

(1)当 $n=6$ 时,求 $P(X\le2)$;

(2)已知切比雪夫不等式:对随机变量 $Y$,若 $E(Y)$、$D(Y)$ 存在,则对任意正数 $a$,$P(|Y-E(Y)|\lt a)\ge1-\dfrac{D(Y)}{a^2}$。为了至少有 $98\%$ 的把握使发射信号“1”的频率在 $0.4$ 与 $0.6$ 之间,试估计发射次数 $n$ 的最小值。

建模思路

每次发射是一次伯努利试验,$X\sim B\!\left(n,\tfrac12\right)$。第(2)问把“频率在 $0.4$ 与 $0.6$ 之间”改写成 $|X-E(X)|\lt a$ 的形式,再让切比雪夫给出的下限 $\ge0.98$。

解析

(1)$n=6$ 时求 $P(X\le2)$

  1. 各次发射相互独立,且每次发“1”的概率为 $\tfrac12$,所以 $X\sim B\!\left(6,\tfrac12\right)$,$P(X=k)=\mathrm{C}_6^k\left(\tfrac12\right)^6$。
  2. $$P(X\le2)=\frac{\mathrm{C}_6^0+\mathrm{C}_6^1+\mathrm{C}_6^2}{2^6}=\frac{1+6+15}{64}=\frac{22}{64}=\frac{11}{32}$$

    $p=\dfrac12$ 时每个结果概率都是 $\dfrac1{64}$,只需数组合数

答案:$\dfrac{11}{32}$

(2)用切比雪夫不等式估计 $n$ 的最小值

  1. $X\sim B\!\left(n,\tfrac12\right)$:$E(X)=\tfrac n2$,$D(X)=n\cdot\tfrac12\cdot\tfrac12=\tfrac n4$。
  2. 频率 $\dfrac Xn\in(0.4,0.6)\iff 0.4n\lt X<0.6n\iff |X-0.5n|<0.1n$。

    两边同时减去 $E(X)=0.5n$,区间关于期望对称,正好是 $|Y-E(Y)|\lt a$ 的形式,$a=0.1n$

  3. 代入切比雪夫不等式($Y=X$,$a=0.1n$): $$P(|X-0.5n|<0.1n)\ge1-\frac{n/4}{(0.1n)^2}=1-\frac{25}{n}$$
  4. 要“至少有 $98\%$ 的把握”,只需下限 $1-\dfrac{25}{n}\ge0.98$,即 $\dfrac{25}{n}\le0.02$,$n\ge1250$。

    题目要求用不等式作估计:保证下限达到 $0.98$,实际概率自然不低于 $0.98$

  5. 所以 $n$ 的最小值估计为 $1250$。

    拓展:直接用二项分布精确计算,$n=132$ 时概率已达 $0.9816$。切比雪夫对任何分布都成立,代价是偏保守

答案:$1250$

易错

易错点:“频率”是 $X/n$,不是 $X$:偏离半径是 $a=0.1n$ 而不是 $0.1$。另外切比雪夫给的是概率的下限,不能说“概率等于 $1-\tfrac{25}{n}$”。

例 22024 杭州二模

在概率统计中常用频率估计概率。袋中有若干红球和白球,有放回地随机摸球 $n$ 次,红球出现 $m$ 次。设每次摸出红球的概率为 $p$,根据频率估计概率的思想,$p$ 的估计值为 $\hat p=\dfrac mn$。

(1)若袋中两种颜色球的个数之比为 $1:3$,不知道哪种颜色的球多。有放回地摸取 $3$ 个球,摸出红球的次数为 $Y$,则 $Y\sim B(3,p)$。$P_p(Y=k)$ 表示每次摸出红球概率为 $p$ 时摸出红球 $k$ 次的概率。

(i) 完成下表:

$k$ $0$ $1$ $2$ $3$
$P_{1/4}(Y=k)$ $\frac{27}{64}$ $\frac1{64}$
$P_{3/4}(Y=k)$ $\frac9{64}$ $\frac{27}{64}$

(ii) 把使 $P_p(Y=k)$ 最大的 $p$ 作为 $p$ 的估计值 $\hat p$,写出 $\hat p$。

(2)(最大似然估计)已知参数 $p$ 的对数似然函数为 $l(p)=\sum_{i=1}^nX_i\ln p+\sum_{i=1}^n(1-X_i)\ln(1-p)$,其中第 $i$ 次摸出红球 $X_i=1$,白球 $X_i=0$。求 $p$ 的估计值,并说明频率估计概率的合理性。

建模思路

(1)是“只有两个候选值”的最大似然:看到数据后,比较哪个 $p$ 让这组数据更可能出现。(2)是连续候选值:对数似然求导。

解析

(1)(i) 填表

  1. 比例 $1:3$ 且不知谁多,所以 $p=\tfrac14$ 或 $p=\tfrac34$。$P_p(Y=k)=\mathrm{C}_3^kp^k(1-p)^{3-k}$。

  2. $p=\tfrac14$:$P(Y=1)=3\cdot\tfrac14\cdot\tfrac9{16}=\tfrac{27}{64}$,$P(Y=2)=3\cdot\tfrac1{16}\cdot\tfrac34=\tfrac9{64}$。

  3. $p=\tfrac34$:$P(Y=0)=\left(\tfrac14\right)^3=\tfrac1{64}$,$P(Y=2)=3\cdot\tfrac9{16}\cdot\tfrac14=\tfrac{27}{64}$。

    对称性:$P_{3/4}(Y=k)=P_{1/4}(Y=3-k)$

  4. 填完的表:

    $k$ $0$ $1$ $2$ $3$
    $P_{1/4}(Y=k)$ $\frac{27}{64}$ $\frac{27}{64}$ $\frac9{64}$ $\frac1{64}$
    $P_{3/4}(Y=k)$ $\frac1{64}$ $\frac9{64}$ $\frac{27}{64}$ $\frac{27}{64}$

答案:见上表。

(1)(ii) 写出 $\hat p$

  1. 按列比较:$k=0,1$ 时 $p=\tfrac14$ 那一行更大;$k=2,3$ 时 $p=\tfrac34$ 那一行更大。

    “已经发生的结果,应当是在真实参数下比较容易发生的”

  2. $$\hat p=\begin{cases}\dfrac14,&Y=0,1\\[4pt]\dfrac34,&Y=2,3\end{cases}$$

答案:$Y=0,1$ 时 $\hat p=\tfrac14$;$Y=2,3$ 时 $\hat p=\tfrac34$。

(2)求 $p$ 的估计值,说明频率估计概率的合理性

  1. 记 $m=\sum_{i=1}^nX_i$(红球次数),则 $\sum(1-X_i)=n-m$,$l(p)=m\ln p+(n-m)\ln(1-p)$,$0\lt p<1$。

    对 $p$ 求导时,数据 $X_i$ 已经观测到,是常数

  2. $$l'(p)=\frac mp-\frac{n-m}{1-p}=\frac{m(1-p)-(n-m)p}{p(1-p)}=\frac{m-np}{p(1-p)}$$
  3. 当 $0\lt m\lt n$ 时:$p<\tfrac mn$ 时 $l'(p)>0$,$p>\tfrac mn$ 时 $l'(p)<0$,所以 $l(p)$ 在 $p=\tfrac mn$ 处取最大值,$\hat p=\dfrac mn=\dfrac1n\sum_{i=1}^nX_i$。

    分母 $p(1-p)>0$,符号只看分子 $m-np$

  4. (补充)$m=0$ 时 $l(p)=n\ln(1-p)$ 递减,$m=n$ 时 $l(p)=n\ln p$ 递增,最大值趋向端点,自然地取 $\hat p=0$ 或 $1$,仍等于 $\tfrac mn$。

    原参考解析没有讨论端点情形,这里补充

  5. 合理性:最大似然估计 $\hat p$ 恰好等于频率 $\tfrac mn$。也就是说,用频率估计概率,就是选择“让已观测到的数据出现的可能性最大”的那个 $p$。再加上大数定律(频率随 $n$ 增大稳定于 $p$),频率估计概率既有原理依据,也有极限保证。

答案:$\hat p=\dfrac mn=\dfrac1n\sum_{i=1}^nX_i$,与频率一致。

易错

易错点:第(1)问的 $\hat p$ 是随 $Y$ 变化的,要分情况写,不是一个固定数。第(2)问求导时把 $X_i$ 当常数、$p$ 当自变量。

课堂小测

课堂小测

抛一枚均匀硬币,前 $10$ 次出现了 $8$ 次正面。关于此后的抛掷,正确的是

查看答案与解析

答案C

解析

前 $10$ 次的偏差 $+3$ 是固定的,后面大量试验让它在频率中被稀释:$\dfrac{8+0.5n'}{10+n'}\to0.5$。

辨析
  • A:赌徒谬误,各次独立,第 $11$ 次正面的概率仍是 $\dfrac12$,硬币没有“记忆”
  • B:前面的结果不影响后面,下一次正面的概率仍是 $\dfrac12$,不会“越抛越正”
  • D:大数定律只说频率依概率趋近 $0.5$,任何有限次时都不保证等于 $0.5$(奇数次时甚至不可能等于)。
课堂小测

总体服从指数分布 $\mathrm{Exp}(1)$(右偏,$\mu=\sigma=1$)。抽 $n=40$ 个求平均,$\bar x$ 的分布

查看答案与解析

答案B

解析

由中心极限定理,$\bar x$ 近似 $N\!\left(1,\dfrac1{40}\right)$,标准差 $\dfrac1{\sqrt{40}}\approx0.158$。偏度约 $\dfrac2{\sqrt{40}}\approx0.32$,仍略有右偏。

辨析
  • A:中心极限定理说形状会趋近正态,而不是保持总体的形状
  • C:标准差应为 $\sigma/\sqrt n$,不是 $\sigma$,平均会“抵消”一部分波动
  • D:$\bar x$ 的均值等于总体均值 $\mu=1$,与 $n$ 无关。
课堂小测

$X\sim B(100,0.5)$。用切比雪夫不等式可以断言 $P(40<X<60)$ 至少为

查看答案与解析

答案A

解析

$E(X)=50$,$D(X)=25$,$P(|X-50|<10)\ge1-\dfrac{25}{10^2}=0.75$。精确值约 $0.943$,切比雪夫偏保守。

辨析
  • B:$0.25$ 是 $\dfrac{D(X)}{a^2}$,是尾部 $P(|X-50|\ge10)$ 的上界,不是所求概率的下界
  • C:$0.943$ 是精确值,切比雪夫只给出一个下界,不会给出这么准的数
  • D:把 $a$ 当成 $0.1$(频率的半径)代入 $D(X)=25$ 才会得到负数,次数 $X$ 的半径应为 $10$。
专题 16

矩估计与极大似然:从数据倒推参数

概率论是“已知 $p$,问数据会怎样”;统计是反过来:“看到了数据,$p$ 最可能是多少”。极大似然给出的答案恰好就是频率 $\dfrac mn$。(拓展内容,高考题 21、22 正是这个主题)

看见:似然函数 $L(p)$

有放回摸球 $n$ 次,摸到红球 $m$ 次。$p$ 取多少时,“这组数据”最可能出现?

相对似然 L(p)/L(\hat p)(n=3,m=1)在红点 \hat p=1/3 处达到最大值 1;橙色竖线与点标出 p=1/4 和 p=3/4 的相对似然。
图 1相对似然 $L(p)/L(\hat p)$($n=3,m=1$)在红点 $\hat p=1/3$ 处达到最大值 1;橙色竖线与点标出 $p=1/4$ 和 $p=3/4$ 的相对似然。

似然函数与数据积累:数据越多,曲线越尖

以 $n=3,\ m=1$ 为例,似然函数为

$$L(p)=\mathrm{C}_{3}^{1}\,p^{1}(1-p)^{2}$$

极大似然估计 $\hat p=\dfrac mn=\dfrac13$。

注意

只有两个候选值(如第 22 题中的 $p=\tfrac14$ 或 $\tfrac34$)时,不用求导,直接比较哪个 $L$ 更大:

$$L\!\left(\tfrac14\right)=0.4219,\qquad L\!\left(\tfrac34\right)=0.1406\ \Rightarrow\ \text{选 }\hat p=\tfrac14$$

思路

似然 $L(p)$ 与概率是同一个式子 $\mathrm{C}_n^mp^m(1-p)^{n-m}$,但角色互换:数据 $m$ 已经固定,$p$ 当自变量。“已经发生的事,应当是在真实参数下比较容易发生的”,于是取使 $L(p)$ 最大的 $p$ 作为估计。

提示

保持 $m/n$ 不变而增大 $n$(如 $3/10\to30/100$),峰的位置不变、宽度按 $1/\sqrt n$ 变窄:数据越多,对 $p$ 的“把握”越大。

推导:对数似然求导

极大似然估计 $\hat p=\dfrac mn$ 的推导

  1. 第 $i$ 次摸球记 $X_i=1$(红)或 $0$(白),$P(X_i=x_i)=p^{x_i}(1-p)^{1-x_i}$。

    两点分布的一个统一写法:$x=1$ 时为 $p$,$x=0$ 时为 $1-p$

  2. 各次独立,观测到这一串结果的概率(似然函数): $$L(p)=\prod_{i=1}^np^{x_i}(1-p)^{1-x_i}=p^{m}(1-p)^{n-m},\quad m=\sum x_i$$

    若只记录总数 $m$,再乘 $\mathrm{C}_n^m$;常数因子不改变最大值点

  3. 取对数: $$\ell(p)=\ln L(p)=m\ln p+(n-m)\ln(1-p)$$

    $\ln$ 单调递增,$L$ 与 $\ln L$ 的最大值点相同;乘积变成和,好求导

  4. 求导: $$\ell'(p)=\frac mp-\frac{n-m}{1-p}=\frac{m(1-p)-(n-m)p}{p(1-p)}=\frac{m-np}{p(1-p)}$$
  5. 当 $0<m<n$:$p<\tfrac mn$ 时 $\ell'>0$,$p>\tfrac mn$ 时 $\ell'<0$,所以 $$\hat p=\frac mn$$

    分母 $p(1-p)>0$,符号由 $m-np$ 决定;下方图中切线斜率在 $\hat p$ 左侧为正、右侧为负

  6. 端点:$m=0$ 时 $\ell=n\ln(1-p)$ 递减,取 $\hat p=0$;$m=n$ 时取 $\hat p=1$,仍有 $\hat p=\tfrac mn$。
  7. 一般步骤:写似然 $L(\theta)$ → 取对数 $\ell(\theta)$ → 解似然方程 $\ell'(\theta)=0$ → 用单调性确认是最大值,并检查解是否在参数范围内。

    第 21 题的关键就在最后一句:解要落在模型允许的范围里

对数似然 $\ell(p)$ 与切线:斜率在 $\hat p$ 处变号

对数似然 \ell(p)=m\ln p+(n-m)\ln(1-p)(取 n=3,\ m=1):紫色曲线为 \ell(p),红色虚线在 p=\hat p=\tfrac13 处,是曲线的最高点;黑点为切点 p=0.6,红色短线是该点的切线,斜率为负,说明此处 p 偏大,向左走 \ell 会增大。
图 2对数似然 $\ell(p)=m\ln p+(n-m)\ln(1-p)$(取 $n=3,\ m=1$):紫色曲线为 $\ell(p)$,红色虚线在 $p=\hat p=\tfrac13$ 处,是曲线的最高点;黑点为切点 $p=0.6$,红色短线是该点的切线,斜率为负,说明此处 $p$ 偏大,向左走 $\ell$ 会增大。

在切点 $p=0.60$ 处:

$$\ell'(0.60)=\frac{m-np}{p(1-p)}=\frac{1-3\times0.60}{0.60\times0.40}\approx-3.33$$

斜率 $<0$:$p$ 偏大,往左走似然会增大。

矩估计 vs 极大似然

总体 $U(0,\theta)$:用 $2\bar x$(矩估计)还是 $\max x_i$(极大似然)估计 $\theta$?

总体 U(0,\theta) 取 \theta=4、样本量 n=5,重复抽样 2000 次得到的两种估计的分布:蓝色为 2\bar x(矩估计),红色为 \max x_i(极大似然),深绿竖线为真值 \theta=4。蓝色以 \theta 为中心左右散开,红色全部落在 \theta 的左侧并向 \theta 堆积。
图 3总体 $U(0,\theta)$ 取 $\theta=4$、样本量 $n=5$,重复抽样 2000 次得到的两种估计的分布:蓝色为 $2\bar x$(矩估计),红色为 $\max x_i$(极大似然),深绿竖线为真值 $\theta=4$。蓝色以 $\theta$ 为中心左右散开,红色全部落在 $\theta$ 的左侧并向 $\theta$ 堆积。

两种思路

  1. 矩估计:用样本矩代替总体矩。$U(0,\theta)$ 的 $E(X)=\dfrac\theta2$,令 $\bar x=\dfrac{\hat\theta}{2}$,得 $\hat\theta_{\text{矩}}=2\bar x$。

    依据是大数定律:$\bar x$ 靠近 $E(X)$

  2. 两点分布 $E(X)=p$,令 $\bar x=\hat p$ 得 $\hat p=\bar x=\tfrac mn$——矩估计与极大似然一致,都是频率。
  3. 极大似然:$f(x)=\tfrac1\theta\ (0\le x\le\theta)$, $$L(\theta)=\begin{cases}\theta^{-n},&\theta\ge\max x_i\\0,&\theta<\max x_i\end{cases}$$ $L$ 在 $\theta\ge\max x_i$ 上递减,所以 $\hat\theta_{\text{MLE}}=\max x_i$。

    这里不能求导令其为 0:最大值在边界上。$\theta$ 不能小于任何一个观测值

两种估计的理论均值与均方误差($\theta=4,\ n=5$):

理论均值 理论均方误差
$2\bar x$ $4.000$ $1.067$
$\max x_i$ $3.333$ $0.762$
提示

理论值:$E(2\bar X)=\theta$(无偏),均方误差 $\dfrac{\theta^2}{3n}$;$E(\max)=\dfrac{n}{n+1}\theta$(略偏小),均方误差 $\dfrac{2\theta^2}{(n+1)(n+2)}$,$n\ge3$ 时比矩估计小得多。不同方法给出不同估计,要用“偏差”和“均方误差”来比较好坏。

提示

矩估计 $2\bar x$ 有时会小于样本最大值 $\max x_i$,这时估计值与数据自相矛盾(见课堂小测第 3 题)。

频率估计概率的合理性

频率估计概率为什么合理:重复做 2000 次“摸 $n$ 次球”

真实 p=0.3、每次摸 n=50 次,重复 2000 次得到的频率 \hat p=\tfrac mn 的分布:蓝色柱为 \hat p 的分布,深绿竖线为真值 p=0.3,浅绿带为 p\pm2\times标准误。频率集中在真值附近,几乎都落在浅绿带内。
图 4真实 $p=0.3$、每次摸 $n=50$ 次,重复 2000 次得到的频率 $\hat p=\tfrac mn$ 的分布:蓝色柱为 $\hat p$ 的分布,深绿竖线为真值 $p=0.3$,浅绿带为 $p\pm2\times$标准误。频率集中在真值附近,几乎都落在浅绿带内。

改变每次实验的摸球次数 $n$($p=0.3$,各重复 2000 次),频率 $\hat p$ 的波动随 $n$ 增大而变小:

$n$ $\sqrt{p(1-p)/n}$ $\hat p$ 的标准差(模拟) $\lvert\hat p-p\rvert<0.05$ 的比例
10 0.1449 0.1438 26.0%
50 0.0648 0.0639 58.3%
200 0.0324 0.0321 90.0%
1000 0.0145 0.0148 99.8%
思路

三重理由:① 无偏:$E(\hat p)=p$,平均而言不偏不倚;② 相合:大数定律,$n\to\infty$ 时 $\hat p\to p$;③ 极大似然:$\hat p=\tfrac mn$ 是让已观测数据最可能出现的 $p$(第 22 题第 2 问)。

第 21 题:$p$ 由模型 $p=f(\theta)$ 决定时

紫色 A 为 p=\ln(1+\theta)-\tfrac23\theta^2,最高点 (0.5,0.2388);蓝色 B 为 p=(1-e^{-\theta})/2,与橙色水平虚线 \hat p=1/4 相交于 (\ln2,1/4)。实心点只标示这两个关键位置。
图 5紫色 A 为 $p=\ln(1+\theta)-\tfrac23\theta^2$,最高点 $(0.5,0.2388)$;蓝色 B 为 $p=(1-e^{-\theta})/2$,与橙色水平虚线 $\hat p=1/4$ 相交于 $(\ln2,1/4)$。实心点只标示这两个关键位置。

以 $\theta=0.300$ 为例,两个模型对应的 $p$ 与相对似然(以 $L(1/4)$ 为基准)为:

$$\begin{aligned}&p_A=0.2024,\ \ \tfrac{L(p_A)}{L(1/4)}=0.5136\\&p_B=0.1296,\ \ \tfrac{L(p_B)}{L(1/4)}=0.0052\end{aligned}$$

提示

数据给出 $\hat p=\tfrac{25}{100}=\tfrac14$。模型 B 的曲线穿过 $p=\tfrac14$($\theta=\ln2$),似然比达到 1;模型 A 的最高点 $0.2388$ 够不着 $\tfrac14$,似然方程无解。

注意

细节:模型 A 下似然在 $\theta=\tfrac12$ 仍然取得最大(相对似然约 0.97),严格说也有最大值点,只是它“顶在模型的天花板上”。命题意图是“似然方程有解的模型 B”。

例题精讲

例 12024 长沙雅礼中学月考(五)

某病毒通过病鼠与白鼠的接触传染。现有 $n$ 只白鼠,每只接触病鼠后被感染的概率为 $\tfrac12$,被感染的白鼠数为 $X$,各白鼠是否被感染相互独立。

(1)若 $P(X=5)=P(X=95)$,求 $E(X)$;

(2)接种疫苗后白鼠被感染的概率为 $p$,$p$ 与参数 $\theta\ (0<\theta<1)$ 有关。团队 A 的模型为 $p=\ln(1+\theta)-\tfrac23\theta^2$,团队 B 的模型为 $p=\tfrac12\left(1-\mathrm e^{-\theta}\right)$。将 100 只接种后的白鼠分成 10 组,每组 10 只,$X_i$ 表示第 $i$ 组被感染的白鼠数,实验结果 $x_i$ 如图。

(i) 写出事件“$X_1=x_1,X_2=x_2,\cdots,X_{10}=x_{10}$”的概率表达式(用 $p$ 表示,组合数不必计算);

(ii) 若 $\theta=\theta_0$ 时上述概率最大,称 $\theta_0$ 为 $\theta$ 的最大似然估计。判断哪个团队的模型可以求出 $\theta$ 的最大似然估计,并求出。参考数据:$\ln\tfrac32\approx0.4055$。

各组感染只数的条形图:第 1~10 组依次为 3, 1, 4, 1, 2, 2, 1, 3, 6, 2。
图 6各组感染只数的条形图:第 1~10 组依次为 3, 1, 4, 1, 2, 2, 1, 3, 6, 2。
建模思路

先对 $p$ 做最大似然(似然只通过 $p$ 依赖 $\theta$),得到 $\hat p=\dfrac{25}{100}=\dfrac14$;再看哪个模型能让 $p(\theta)=\tfrac14$ 在 $(0,1)$ 内成立。上一节“第 21 题”的图中给出了两个模型的 $p=f(\theta)$ 曲线,可以对照。

解析

(1)由 $P(X=5)=P(X=95)$ 求 $E(X)$

  1. $X\sim B\!\left(n,\tfrac12\right)$,$P(X=k)=\mathrm{C}_n^k\left(\tfrac12\right)^n$。
  2. $P(X=5)=P(X=95)\Rightarrow \mathrm{C}_n^5=\mathrm{C}_n^{95}$。

    $p=\tfrac12$ 时幂次部分都是 $\left(\tfrac12\right)^n$,可以约去

  3. $5\ne95$,由 $\mathrm{C}_n^k=\mathrm{C}_n^{n-k}$ 得 $n=5+95=100$,$E(X)=100\times\tfrac12=50$。

答案:$E(X)=50$

(2)(i) 写出观测结果的概率(似然函数)

  1. 读图:10 组的感染数依次为 $3,1,4,1,2,2,1,3,6,2$。即感染 1 只的 3 组,2 只的 3 组,3 只的 2 组,4 只的 1 组,6 只的 1 组。

    有的参考解析把“4 只的”写成 2 组,与图不符(按它算 $p$ 的指数是 23);按图实际是 $3+6+6+4+6=25$。因 $\mathrm{C}_{10}^6=\mathrm{C}_{10}^4$,组合数部分写法相同

  2. 每组 $X_i\sim B(10,p)$,各组独立: $$\begin{aligned}P&=\prod_{i=1}^{10}\mathrm{C}_{10}^{x_i}p^{x_i}(1-p)^{10-x_i}\\&=\left(\mathrm{C}_{10}^1\right)^3\left(\mathrm{C}_{10}^2\right)^3\left(\mathrm{C}_{10}^3\right)^2\mathrm{C}_{10}^4\,\mathrm{C}_{10}^6\cdot p^{25}(1-p)^{75}\end{aligned}$$

    $p$ 的指数 = 感染总数 $3+1+4+1+2+2+1+3+6+2=25$;$1-p$ 的指数 $=100-25=75$

答案:

$$\left(\mathrm{C}_{10}^1\right)^3\left(\mathrm{C}_{10}^2\right)^3\left(\mathrm{C}_{10}^3\right)^2\mathrm{C}_{10}^4\mathrm{C}_{10}^6\,p^{25}(1-p)^{75}$$

($\mathrm{C}_{10}^6=\mathrm{C}_{10}^4$,也可写成 $\left(\mathrm{C}_{10}^4\right)^2$)

(2)(ii) 哪个模型可以求出 $\theta$ 的最大似然估计

  1. 记 $L(p)=Cp^{25}(1-p)^{75}$,取对数 $\ell(p)=\ln C+25\ln p+75\ln(1-p)$。
  2. $$\ell'(p)=\frac{25}{p}-\frac{75}{1-p}=\frac{25-100p}{p(1-p)}$$ 在 $\left(0,\tfrac14\right)$ 为正、$\left(\tfrac14,1\right)$ 为负,$p=\tfrac14$ 时 $L$ 最大。

    正是“频率估计概率”:$25/100$

  3. 团队 A:$f(\theta)=\ln(1+\theta)-\tfrac23\theta^2$, $$f'(\theta)=\frac1{1+\theta}-\frac43\theta=\frac{-(2\theta+3)(2\theta-1)}{3(1+\theta)}$$ $f$ 在 $\left(0,\tfrac12\right)$ 增、$\left(\tfrac12,1\right)$ 减,最大值 $f\!\left(\tfrac12\right)=\ln\tfrac32-\tfrac16\approx0.2388<\tfrac14$。

    $3-4\theta-4\theta^2=-(2\theta+3)(2\theta-1)$

  4. 所以模型 A 下 $p$ 取不到 $\tfrac14$,似然方程在 $(0,1)$ 内无解,按题意的方法求不出 $\theta$ 的估计。

    严格地说:$p<\tfrac14$ 时 $L(p)$ 关于 $p$ 递增,$L$ 在 $\theta=\tfrac12$($p$ 最接近 $\tfrac14$ 处)取最大,所以 A 也有最大值点 $\theta=\tfrac12$,只是这个估计“顶到模型的天花板”。命题意图是 B

  5. 团队 B:$g(\theta)=\tfrac12\left(1-\mathrm e^{-\theta}\right)$ 在 $(0,1)$ 单调递增,值域 $\left(0,\tfrac12\left(1-\tfrac1{\mathrm e}\right)\right)\approx(0,0.316)$,包含 $\tfrac14$。
  6. 令 $\tfrac12\left(1-\mathrm e^{-\theta}\right)=\tfrac14\Rightarrow \mathrm e^{-\theta}=\tfrac12\Rightarrow\theta_0=\ln2\approx0.693\in(0,1)$。

    $g$ 单调,$p=\tfrac14\iff\theta=\ln2$,而 $p=\tfrac14$ 使 $L$ 最大,所以 $\theta_0=\ln2$ 使 $L$ 最大

答案:团队 B 的模型,$\theta$ 的最大似然估计为 $\theta_0=\ln2$

易错

易错点:对 $\theta$ 求最大似然时不必把 $p(\theta)$ 代进去对 $\theta$ 求导:似然只通过 $p$ 依赖 $\theta$,先求 $\hat p$,再解 $p(\theta)=\hat p$ 即可(但要检查解是否在定义域内)。

例 22024 杭州二模

在概率统计中常用频率估计概率。袋中有若干红球和白球,有放回地随机摸球 $n$ 次,红球出现 $m$ 次。设每次摸出红球的概率为 $p$,根据频率估计概率的思想,$p$ 的估计值为 $\hat p=\dfrac mn$。

(1)若袋中两种颜色球的个数之比为 $1:3$,不知道哪种颜色的球多。有放回地摸取 3 个球,摸出红球的次数为 $Y$,则 $Y\sim B(3,p)$。$P_p(Y=k)$ 表示每次摸出红球概率为 $p$ 时摸出红球 $k$ 次的概率。

(i) 完成下表:

$k$ 0 1 2 3
$P_{1/4}(Y=k)$ $\frac{27}{64}$ $\frac1{64}$
$P_{3/4}(Y=k)$ $\frac9{64}$ $\frac{27}{64}$

(ii) 把使 $P_p(Y=k)$ 最大的 $p$ 作为 $p$ 的估计值 $\hat p$,写出 $\hat p$。

(2)(最大似然估计)已知参数 $p$ 的对数似然函数为 $l(p)=\sum_{i=1}^nX_i\ln p+\sum_{i=1}^n(1-X_i)\ln(1-p)$,其中第 $i$ 次摸出红球 $X_i=1$,白球 $X_i=0$。求 $p$ 的估计值,并说明频率估计概率的合理性。

建模思路

(1)是“只有两个候选值”的最大似然:看到数据后,比较哪个 $p$ 让这组数据更可能出现。(2)是连续候选值:对数似然求导。第一节的似然曲线可以对照。

解析

(1)(i) 填表

  1. 比例 $1:3$ 且不知谁多,所以 $p=\tfrac14$ 或 $p=\tfrac34$。$P_p(Y=k)=\mathrm{C}_3^kp^k(1-p)^{3-k}$。

  2. $p=\tfrac14$:$P(Y=1)=3\cdot\tfrac14\cdot\tfrac9{16}=\tfrac{27}{64}$,$P(Y=2)=3\cdot\tfrac1{16}\cdot\tfrac34=\tfrac9{64}$。

  3. $p=\tfrac34$:$P(Y=0)=\left(\tfrac14\right)^3=\tfrac1{64}$,$P(Y=2)=3\cdot\tfrac9{16}\cdot\tfrac14=\tfrac{27}{64}$。

    对称性:$P_{3/4}(Y=k)=P_{1/4}(Y=3-k)$

  4. 填好的表:

    $k$ 0 1 2 3
    $P_{1/4}(Y=k)$ $\frac{27}{64}$ $\frac{27}{64}$ $\frac9{64}$ $\frac1{64}$
    $P_{3/4}(Y=k)$ $\frac1{64}$ $\frac9{64}$ $\frac{27}{64}$ $\frac{27}{64}$

答案:见上表

(1)(ii) 写出 $\hat p$

  1. 按列比较:$k=0,1$ 时 $p=\tfrac14$ 那一行更大;$k=2,3$ 时 $p=\tfrac34$ 那一行更大。

    “已经发生的结果,应当是在真实参数下比较容易发生的”

  2. $$\hat p=\begin{cases}\dfrac14,&Y=0,1\\[4pt]\dfrac34,&Y=2,3\end{cases}$$

答案:$Y=0,1$ 时 $\hat p=\tfrac14$;$Y=2,3$ 时 $\hat p=\tfrac34$

(2)求 $p$ 的估计值,说明频率估计概率的合理性

  1. 记 $m=\sum_{i=1}^nX_i$(红球次数),则 $\sum(1-X_i)=n-m$,$l(p)=m\ln p+(n-m)\ln(1-p)$,$0<p<1$。

    对 $p$ 求导时,数据 $X_i$ 已经观测到,是常数

  2. $$l'(p)=\frac mp-\frac{n-m}{1-p}=\frac{m(1-p)-(n-m)p}{p(1-p)}=\frac{m-np}{p(1-p)}$$
  3. 当 $0<m<n$ 时:$p<\tfrac mn$ 时 $l'(p)>0$,$p>\tfrac mn$ 时 $l'(p)<0$,所以 $l(p)$ 在 $p=\tfrac mn$ 处取最大值,$\hat p=\dfrac mn=\dfrac1n\sum_{i=1}^nX_i$。

    分母 $p(1-p)>0$,符号只看分子 $m-np$

  4. (补充)$m=0$ 时 $l(p)=n\ln(1-p)$ 递减,$m=n$ 时 $l(p)=n\ln p$ 递增,最大值趋向端点,自然地取 $\hat p=0$ 或 $1$,仍等于 $\tfrac mn$。

    原解析没有讨论端点情形

  5. 合理性:最大似然估计 $\hat p$ 恰好等于频率 $\tfrac mn$。也就是说,用频率估计概率,就是选择“让已观测到的数据出现的可能性最大”的那个 $p$。再加上大数定律(频率随 $n$ 增大稳定于 $p$),频率估计概率既有原理依据,也有极限保证。

答案:$\hat p=\dfrac mn=\dfrac1n\sum_{i=1}^nX_i$,与频率一致

易错

易错点:第(1)问的 $\hat p$ 是随 $Y$ 变化的,要分情况写,不是一个固定数。第(2)问求导时把 $X_i$ 当常数、$p$ 当自变量。

课堂小测

课堂小测

一枚硬币抛 10 次出现 7 次正面。正面概率 $p$ 的极大似然估计是

查看答案与解析

答案C

解析

$\ell'(p)=\dfrac{7-10p}{p(1-p)}$,在 $p=0.7$ 处变号,$\hat p=\dfrac mn=0.7$。

辨析
  • A:$0.5$ 是“先验印象”,不是由数据得到的估计,$L(0.5)$ 比 $L(0.7)$ 小
  • B:$0.3$ 是反面的频率
  • D:$7$ 是次数,概率的估计要除以 $n$。
课堂小测

关于似然函数 $L(p)=\mathrm{C}_{10}^7p^7(1-p)^3$,正确的是

查看答案与解析

答案B

解析

同一个式子,固定 $p$ 看 $m$ 是概率;固定数据 $m$ 看 $p$ 就是似然。

辨析
  • A:$L(p)$ 关于 $p$ 的积分是 $\tfrac1{11}$,不是 1,它不是 $p$ 的概率分布,$p$ 是固定未知数,不是随机变量
  • C:取对数不改变最大值点,但函数值变了,$\ell=\ln L$,两者最大值点相同而最大值不同
  • D:组合数 $\mathrm{C}_{10}^7$ 是常数因子,去掉它最大值点不变。
课堂小测

总体 $U(0,\theta)$,样本为 $1,2,9$。下列说法正确的是

查看答案与解析

答案D

解析

$\theta$ 必须 $\ge$ 每个观测值,$L(\theta)=\theta^{-3}$ 在 $[9,+\infty)$ 递减,$\hat\theta=9$;矩估计 $8<9$ 自相矛盾。

辨析
  • A:$\bar x=4$,矩估计 $2\bar x=8$,但它小于观测值 $9$,不合理
  • B:$L(\theta)=\theta^{-3}$($\theta\ge9$)递减,不是在 $\bar x$ 处取最大
  • C:$L(\theta)=\theta^{-3}$ 在 $\theta\ge9$ 上没有导数为 0 的点,最大值在边界 $\theta=9$ 处,不能靠解似然方程。
专题 17

置信区间:不只给一个估计值,还给出“误差范围”和“把握”

点估计 $\bar x$ 几乎不会恰好等于 $\mu$。置信区间 $\bar x\pm z\cdot\sigma/\sqrt n$ 给出一个范围,并说明“这种方法”有多大比例能盖住 $\mu$。(拓展内容,超出高中要求)

看见:100 个区间

100 位同学各抽一个样本,各算一个区间

总体 N(50,10^2)、n=25、置信水平 95\%:100 位同学各抽一个样本,各画一条区间。蓝色横线是盖住 \mu 的区间(圆点为各自的 \bar x),红色粗线是没盖住 \mu 的区间(本批 100 个中有 2 个),绿色竖线是固定不动的真值 \mu=50。
图 1总体 $N(50,10^2)$、$n=25$、置信水平 $95\%$:100 位同学各抽一个样本,各画一条区间。蓝色横线是盖住 $\mu$ 的区间(圆点为各自的 $\bar x$),红色粗线是没盖住 $\mu$ 的区间(本批 100 个中有 2 个),绿色竖线是固定不动的真值 $\mu=50$。

所有区间等长,宽度为

$$\bar x\pm z_{\alpha/2}\frac{\sigma}{\sqrt n}=\bar x\pm1.960\times\frac{10}{\sqrt{25}}=\bar x\pm3.920,\qquad\text{宽度 }7.840$$

思路

动的是区间,不动的是 $\mu$。每个区间要么盖住 $\mu$、要么没盖住;“$95\%$”说的是:用这个办法造很多区间,长期来看约 $95\%$ 能盖住 $\mu$。

提示

同一批样本下,改变置信水平,所有区间同时变长或变短,没盖住 $\mu$ 的(红色)区间个数随之变化;只改变 $n$,区间整体变窄,但盖住的比例不变,因为置信水平没变。

注意

$\sigma$ 已知时区间宽度 $2z\sigma/\sqrt n$ 与样本无关,所以 100 个区间一样长;$\sigma$ 未知时要用 $s$ 和 $t$ 分布(下一模块),区间长短也会随样本变化。

推导:从 Z 解出 μ

正态总体、σ 已知:均值 μ 的置信区间

  1. 总体 $X\sim N(\mu,\sigma^2)$,样本 $X_1,\dots,X_n$ 独立同分布,则 $$\bar X\sim N\!\left(\mu,\frac{\sigma^2}{n}\right)$$

    $E(\bar X)=\mu$,$D(\bar X)=\sigma^2/n$;正态的线性组合仍是正态(非正态总体 $n$ 大时由中心极限定理近似成立)

  2. 标准化,得到一个分布完全已知的量(枢轴量): $$Z=\frac{\bar X-\mu}{\sigma/\sqrt n}\sim N(0,1)$$

    $Z$ 里含有未知的 $\mu$,但它的分布不含任何未知数——这是能“反解”的关键

  3. 取 $z_{\alpha/2}$ 使 $P(|Z|\le z_{\alpha/2})=1-\alpha$,例如 $1-\alpha=0.95$ 时 $z_{0.025}=1.96$: $$P\!\left(-1.96\le\frac{\bar X-\mu}{\sigma/\sqrt n}\le1.96\right)=0.95$$

    见下方图:中间阴影面积 = 置信水平

  4. 把括号里的不等式对 $\mu$ 解出来(事件不变,只是改写): $$P\!\left(\bar X-1.96\frac{\sigma}{\sqrt n}\le\mu\le\bar X+1.96\frac{\sigma}{\sqrt n}\right)=0.95$$

    $|\bar x-\mu|\le1.96\cdot\mathrm{SE}$ 既可以读成“$\bar x$ 离 $\mu$ 不远”,也可以读成“$\mu$ 离 $\bar x$ 不远”

  5. 这里随机的是区间的端点(含 $\bar X$)。代入观测值 $\bar x$ 得到置信区间 $$\left[\bar x-z_{\alpha/2}\frac{\sigma}{\sqrt n},\ \bar x+z_{\alpha/2}\frac{\sigma}{\sqrt n}\right]$$
  6. 宽度 $2z_{\alpha/2}\dfrac{\sigma}{\sqrt n}$:置信水平越高越宽,$n$ 越大越窄($\propto1/\sqrt n$),总体越分散越宽。
  7. 推广:$\sigma$ 未知时用 $s$ 代替 $\sigma$,$z$ 换成 $t_{\alpha/2}(n-1)$;大样本下比例 $p$ 的近似区间为 $\hat p\pm z_{\alpha/2}\sqrt{\hat p(1-\hat p)/n}$。

    都是同一个套路:找枢轴量 → 写概率等式 → 解出参数

“x̄ 在 μ 附近”与“区间盖住 μ”是同一件事

绿色曲线是 \bar x 的抽样分布,横轴以 \mathrm{SE}=\sigma/\sqrt n 标准化;阴影 [-1.960,+1.960] 面积为 95\%。顶部蓝色区间中心为 \bar x=\mu+1.2\,\mathrm{SE},端点为 \bar x\pm1.96\,\mathrm{SE},覆盖黑色竖线 \mu。
图 2绿色曲线是 $\bar x$ 的抽样分布,横轴以 $\mathrm{SE}=\sigma/\sqrt n$ 标准化;阴影 $[-1.960,+1.960]$ 面积为 $95\%$。顶部蓝色区间中心为 $\bar x=\mu+1.2\,\mathrm{SE}$,端点为 $\bar x\pm1.96\,\mathrm{SE}$,覆盖黑色竖线 $\mu$。

$$P\!\left(-1.960\le Z\le 1.960\right)=0.950$$

$\bar x$ 落在中间阴影里 $\iff$ 区间 $\bar x\pm z\cdot\mathrm{SE}$ 盖住 $\mu$。

图中上方横线是以 $\bar x$ 为中心、半宽 $z\cdot\mathrm{SE}$ 的区间;若 $\bar x$ 落在阴影之外,区间就够不着 $\mu$ 了。

辨析:“95%”的含义

判断对错:抽 25 个零件,算得 μ 的 95% 置信区间为 [9.92, 10.32]

  • ① $\mu$ 落在 $[9.92,\,10.32]$ 中的概率是 $95\%$。错。 抽样后区间 $[9.92,\,10.32]$ 是两个确定的数,$\mu$ 也是确定的数(只是未知),“$\mu$ 在区间里”要么成立要么不成立,没有 $95\%$ 的概率可言。$95\%$ 是“造区间的方法”的成功率。
  • ② 重复抽样、每次按同样方法造区间,长期看约 $95\%$ 的区间包含 $\mu$。对。 这正是置信水平的频率解释,上一节的 100 个区间就是演示。
  • ③ 抽样之前,随机区间 $\bar X\pm1.96\sigma/\sqrt n$ 包含 $\mu$ 的概率是 $95\%$。对。 抽样之前 $\bar X$ 是随机变量,区间端点随机,“随机区间盖住 $\mu$”是一个事件,概率为 $0.95$。①与③的差别就在“抽样前 / 抽样后”。
  • ④ 约 $95\%$ 的零件长度落在 $[9.92,\,10.32]$ 中。错。 区间估计的是均值 $\mu$,宽度按 $\sigma/\sqrt n$ 计算;单个数据的波动是 $\sigma$,大得多。下面的模拟中 $n=25$ 时只有约 $30\%$ 的单个数据落在区间里。
  • ⑤ 再抽一个同样大小的样本,它的均值有 $95\%$ 的概率落在这个区间里。错。 新样本均值 $\bar x_2$ 与原来的 $\bar x_1$ 都在波动:$\bar x_2-\bar x_1\sim N(0,2\sigma^2/n)$,平均只有 $P\!\left(|Z|\le1.96/\sqrt2\right)\approx83.4\%$。
  • ⑥ 用同一个样本算 $99\%$ 置信区间,会比 $95\%$ 的更宽。对。 $z_{0.005}=2.576>1.96$,宽度按 $2z\sigma/\sqrt n$ 变为约 $1.31$ 倍。要更有把握,就得把范围说得更宽。

用模拟检验:总体 N(50, 10²),n = 25,95% 区间

抽一个样本并固定它的区间,例如 $[46.40,\ 54.24]$(盖住了 $\mu=50$),再对这个固定区间重复模拟 4000 次,考察三个比例:

比例 对应说法 结果
新抽样本的区间盖住 $\mu$ ② 稳定在 $95\%$ 附近
新样本均值落入固定区间 ⑤ 取决于固定的区间,平均约 $83.4\%$
单个数据落入固定区间 ④ 取决于固定的区间,平均约 $30\%$
提示

第一个比例稳定在 $95\%$ 附近;后两个比例取决于固定的区间(多抽几个样本、固定不同的区间可以看到),平均分别约为 $83.4\%$ 与 $30\%$,都不是 $95\%$。

思路

口诀:抽样前谈概率,抽样后谈置信。“$95\%$ 置信”是对方法的信任程度,不是对某个具体区间的概率断言。

探索:n 与置信水平

区间宽度 2zσ/√n 随 n 和置信水平的变化

区间宽度 2z\sigma/\sqrt n 随样本量 n 变化的曲线(\sigma=10):红色为 99\%,绿色粗线为 95\%,蓝色为 90\%;黑点标出 n=25、95\% 时的宽度 7.840。同一 n 下置信水平越高曲线越高,且都随 n 增大而下降。
图 3区间宽度 $2z\sigma/\sqrt n$ 随样本量 $n$ 变化的曲线($\sigma=10$):红色为 $99\%$,绿色粗线为 $95\%$,蓝色为 $90\%$;黑点标出 $n=25$、$95\%$ 时的宽度 $7.840$。同一 $n$ 下置信水平越高曲线越高,且都随 $n$ 增大而下降。

$\sigma=10$、$n=25$、$95\%$ 时:$z=1.960$,宽度 $7.840$。

反过来:要达到精度 E,至少要多少样本

$$z\frac{\sigma}{\sqrt n}\le E\iff n\ge\left(\frac{z\sigma}{E}\right)^2=\left(\frac{1.960\times10}{2}\right)^2=96.04$$

所以($\sigma=10$,$E=2$,$95\%$)最少样本量 $n=97$。三种置信水平对照如下(宽度取 $\sigma=10$、$n=25$):

置信水平 $z$ 值 区间宽度 要使 $E=2$ 所需 $n\ge(z\sigma/E)^2$ 最少样本量 $n$
$90\%$ $1.645$ $6.579$ $\left(\dfrac{1.645\times10}{2}\right)^2=67.64$ $68$
$95\%$ $1.960$ $7.840$ $\left(\dfrac{1.960\times10}{2}\right)^2=96.04$ $97$
$99\%$ $2.576$ $10.303$ $\left(\dfrac{2.576\times10}{2}\right)^2=165.87$ $166$
思路

平方关系:误差减半,样本量要变成 $4$ 倍;误差变为 $1/10$,样本量要变成 $100$ 倍。这就是民意调查通常抽 1000 人左右的原因:再多,精度提升很有限。

注意

“置信水平高”和“区间窄”不能兼得($n$ 固定时)。想两者都要,只能加大样本量。

例题精讲

例 1原创例题

零件长度的 95% 置信区间

某车床加工的零件长度 $X$(单位:mm)服从正态分布 $N(\mu,0.5^2)$,$\mu$ 未知。随机抽取 25 个零件,测得样本均值 $\bar x=10.12$。

(1)求 $\mu$ 的置信水平为 $95\%$ 的置信区间($z_{0.025}=1.96$);

(2)若希望 $95\%$ 置信区间的长度不超过 $0.2$,至少需要抽取多少个零件?

解析
建模思路

$\sigma$ 已知,用枢轴量 $Z=\dfrac{\bar X-\mu}{\sigma/\sqrt n}\sim N(0,1)$。区间长度 $2z\sigma/\sqrt n$ 只与 $n$、$\sigma$、置信水平有关,与样本均值无关。

(1)$\mu$ 的 95% 置信区间

  1. $\bar X\sim N\!\left(\mu,\dfrac{\sigma^2}{n}\right)$,标准误 $\dfrac{\sigma}{\sqrt n}=\dfrac{0.5}{5}=0.1$。
  2. $P\!\left(\left|\dfrac{\bar X-\mu}{0.1}\right|\le1.96\right)=0.95$,解出 $\mu$:$\bar X-0.196\le\mu\le\bar X+0.196$。
  3. 代入 $\bar x=10.12$: $$[10.12-0.196,\ 10.12+0.196]=[9.924,\ 10.316]$$

答案:$[9.924,\ 10.316]$

(2)区间长度不超过 0.2 的最小样本量

  1. 区间长度 $=2\times1.96\times\dfrac{0.5}{\sqrt n}=\dfrac{1.96}{\sqrt n}$。
  2. $\dfrac{1.96}{\sqrt n}\le0.2\iff\sqrt n\ge9.8\iff n\ge96.04$。

    长度减半($0.392\to0.2$ 约一半)样本量约要变为 $4$ 倍

  3. $n$ 为整数,最少取 $97$。

    $96$ 不满足 $n\ge96.04$,不能四舍五入

答案:至少 $97$ 个

易错

不能说“$\mu$ 有 $95\%$ 的概率落在 $[9.924,10.316]$ 中”:$\mu$ 是固定的数,算出的区间也是固定的,它要么包含 $\mu$ 要么不包含。$95\%$ 描述的是“这种造区间的方法”。

例 2原创例题

灌装量:置信水平与区间宽度

饮料灌装线的灌装量 $X$(单位:mL)服从 $N(\mu,4^2)$。质检员随机抽取 16 瓶,测得平均灌装量 $\bar x=498$。

(1)分别求 $\mu$ 的 $90\%$ 与 $99\%$ 置信区间($z_{0.05}=1.645$,$z_{0.005}=2.576$),并比较两者宽度;

(2)标签标称 500 mL。根据两个区间分别能得到什么结论?

(3)若该质检员每天独立地做一次这样的 $90\%$ 置信区间,连续 20 天都包含真实 $\mu$ 的概率是多少?(结果保留两位小数)

解析
建模思路

置信水平越高,$z$ 越大,区间越宽:“更有把握”的代价是“说得更粗”。(2)为下一模块的假设检验做铺垫:区间是否包含 $500$ 等价于双侧检验是否拒绝 $\mu=500$。

(1)90% 与 99% 置信区间

  1. 标准误 $\dfrac{\sigma}{\sqrt n}=\dfrac44=1$。
  2. $90\%$:$498\pm1.645\times1=[496.355,\ 499.645]$,宽度 $3.29$。
  3. $99\%$:$498\pm2.576\times1=[495.424,\ 500.576]$,宽度 $5.152$。

    宽度之比 $2.576/1.645\approx1.57$,与样本无关

答案:$90\%$:$[496.355,\,499.645]$;$99\%$:$[495.424,\,500.576]$;后者更宽

(2)与标称值 500 mL 比较

  1. $90\%$ 区间不包含 $500$:在 $90\%$ 置信水平下,可以认为平均灌装量低于 $500$ mL。

    等价于显著性水平 $\alpha=0.10$ 的双侧检验拒绝 $\mu=500$

  2. $99\%$ 区间包含 $500$:在 $99\%$ 置信水平下,数据还不足以否定 $\mu=500$。

    “不能否定”不等于“证明了 $\mu=500$”

  3. 结论依赖置信水平:要求越严格($99\%$),越不轻易下“偏少”的结论。

答案:$90\%$ 下认为偏少;$99\%$ 下不能否定 $\mu=500$

(3)连续 20 天都包含 $\mu$ 的概率

  1. 每天的区间(抽样前)包含 $\mu$ 的概率为 $0.9$,各天独立。

    “包含 $\mu$”是关于随机区间的事件,抽样前才有概率可言

  2. 20 天都包含:$0.9^{20}\approx0.12$。也就是说,20 天里至少有一天“漏掉” $\mu$ 的概率约 $0.88$。

    包含次数 $\sim B(20,\,0.9)$,平均有 2 天漏掉

答案:$0.9^{20}\approx0.12$

易错

“$90\%$ 区间”不是说“$90\%$ 的瓶子灌装量在这个区间里”。区间估计的是均值 $\mu$,单瓶灌装量的波动要大得多($\sigma=4$)。

课堂小测

课堂小测

某次抽样得到 $\mu$ 的 $95\%$ 置信区间 $[9.92,\,10.32]$。最恰当的解释是

查看答案与解析

答案B

解析

$95\%$ 描述的是方法:重复抽样造区间,长期约 $95\%$ 包含 $\mu$。这一个区间是否包含 $\mu$,我们不知道。

辨析
  • A:抽样后区间与 $\mu$ 都是确定的数,“$\mu$ 在区间里”不是随机事件,谈不上 $95\%$ 的概率
  • C:区间估计的是均值,不是单个数据的范围,单个数据的波动是 $\sigma$,比 $\sigma/\sqrt n$ 大得多
  • D:$\mu$ 是固定值,并不在“区间里随机移动”,且区间可能根本没盖住 $\mu$。
课堂小测

$\sigma$ 已知,其他条件不变,把样本量从 $n$ 变为 $4n$,区间宽度变为原来的

查看答案与解析

答案C

解析

宽度 $2z\sigma/\sqrt n$,$\sqrt{4n}=2\sqrt n$,宽度减半。

辨析
  • A:宽度与 $\sqrt n$ 成反比,不是与 $n$ 成反比
  • B:宽度与 $\sqrt n$ 成反比,$n$ 变大宽度应变小
  • D:宽度依赖 $n$,样本越多,$\bar x$ 越集中,区间越窄。
课堂小测

同一组数据,把置信水平从 $95\%$ 提高到 $99\%$,则

查看答案与解析

答案A

解析

$z$ 从 $1.96$ 变为 $2.576$,宽度约变为 $1.31$ 倍。把握更大,代价是说得更粗。

辨析
  • B:置信水平越高,需要的 $z$ 越大,区间越宽而不是越窄
  • C:中心 $\bar x$ 由数据决定,与置信水平无关,变化的是半宽
  • D:宽度 $2z\sigma/\sqrt n$ 中 $z$ 随置信水平变化。
专题 18

t 检验与假设检验:用数据“反驳”一个说法

先假设一个说法成立(原假设),再看数据在这个假设下是不是“太罕见”。罕见到一定程度就拒绝它。$\sigma$ 未知时,衡量“罕见”要用 $t$ 分布。(拓展内容,超出高中要求)

看见:拒绝域与两类错误

机床直径 $X\sim N(\mu,0.3^2)$,每天抽 $n$ 根看 $\bar x$:$H_0:\mu=10$(正常)

双侧检验(n=9,\alpha=0.05,真实 \mu=10.3),横轴为样本均值 \bar x(mm)。绿色实线是 H_0:\mu=10 下 \bar x 的分布,紫色虚线是真实 \mu=10.3 下 \bar x 的分布;浅红底色为拒绝域(\bar x\le9.804 或 \bar x\ge10.196);绿线下的深红面积是 \alpha(H_0 真却拒绝),两条红线之间紫色虚线下的浅紫面积是 \beta(H_0 假却接受)。
图 1双侧检验($n=9$,$\alpha=0.05$,真实 $\mu=10.3$),横轴为样本均值 $\bar x$(mm)。绿色实线是 $H_0:\mu=10$ 下 $\bar x$ 的分布,紫色虚线是真实 $\mu=10.3$ 下 $\bar x$ 的分布;浅红底色为拒绝域($\bar x\le9.804$ 或 $\bar x\ge10.196$);绿线下的深红面积是 $\alpha$($H_0$ 真却拒绝),两条红线之间紫色虚线下的浅紫面积是 $\beta$($H_0$ 假却接受)。

取 $n=9$、$\alpha=0.05$、双侧检验、真实 $\mu=10.3$ 时:

临界偏差 $c$ 第一类错误 $\alpha$ 第二类错误 $\beta$ 功效 $1-\beta$(发现异常)
$\pm0.1960$ $0.050$ $0.1492$ $0.8508$

拒绝域为

$$ \begin{aligned} |\bar x-10|&\ge z_{\alpha/2}\tfrac{\sigma}{\sqrt n}\\ &=1.960\times\tfrac{0.3}{\sqrt{9}}=0.1960 \end{aligned} $$

两类错误的含义:

$H_0$ 真(机床正常) $H_0$ 假(机床异常)
拒绝 $H_0$ 第一类错误(弃真),概率 $\alpha$ 正确:发现异常
不拒绝 $H_0$ 正确 第二类错误(取伪),概率 $\beta$
思路

两类错误的变化规律:① 把 $\alpha$ 调小,红线外移,$\beta$ 变大:两类错误此消彼长;② $\alpha$ 固定、把 $n$ 调大,两条曲线都变瘦,$\beta$ 明显变小;③ 真实 $\mu$ 越接近 $10$,越难发现,$\beta$ 越大。

注意

检验先控制 $\alpha$(“冤枉好人”的概率),$\beta$ 通常不知道,因为真实 $\mu$ 未知。所以“不拒绝 $H_0$”的说服力很弱,只能说“证据不足”。

右侧检验 $H_1:\mu>10$

右侧检验(n=9,\alpha=0.05,真实 \mu=10.3)。拒绝域只在右侧(\bar x\ge10.164,浅红底色);绿线下的深红面积为 \alpha,红线左侧紫色虚线下的浅紫面积为 \beta。
图 2右侧检验($n=9$,$\alpha=0.05$,真实 $\mu=10.3$)。拒绝域只在右侧($\bar x\ge10.164$,浅红底色);绿线下的深红面积为 $\alpha$,红线左侧紫色虚线下的浅紫面积为 $\beta$。

临界偏差 $c=0.1645$,第一类错误 $\alpha=0.050$,第二类错误 $\beta=0.0877$,功效 $1-\beta=0.9123$。拒绝域为

$$ \begin{aligned} \bar x-10&\ge z_{\alpha}\tfrac{\sigma}{\sqrt n}\\ &=1.645\times\tfrac{0.3}{\sqrt{9}}=0.1645 \end{aligned} $$

左侧检验 $H_1:\mu<10$

左侧检验(n=9,\alpha=0.05,真实 \mu=10.3)。拒绝域只在左侧(\bar x\le9.836,浅红底色);真实分布(紫色虚线)几乎全部落在接受域内,浅紫面积即 \beta,约为 1:方向选反时几乎发现不了异常。
图 3左侧检验($n=9$,$\alpha=0.05$,真实 $\mu=10.3$)。拒绝域只在左侧($\bar x\le9.836$,浅红底色);真实分布(紫色虚线)几乎全部落在接受域内,浅紫面积即 $\beta$,约为 $1$:方向选反时几乎发现不了异常。

临界偏差 $c=0.1645$,第一类错误 $\alpha=0.050$,第二类错误 $\beta=1.0000$,功效 $1-\beta=0.0000$。拒绝域为

$$ \begin{aligned} \bar x-10&\le -z_{\alpha}\tfrac{\sigma}{\sqrt n}\\ &=1.645\times\tfrac{0.3}{\sqrt{9}}=0.1645 \end{aligned} $$

推导:检验的逻辑与 $p$ 值

假设检验的推理:带概率的“反证法”

  1. 提出假设:原假设 $H_0:\mu=\mu_0$(要检验的“现状”说法),备择假设 $H_1:\mu\ne\mu_0$(或 $>$、$<$)。

    $H_0$ 是被“审判”的一方,默认无罪;只有证据足够强才推翻它

  2. 选检验统计量:它的分布在 $H_0$ 下完全已知。$\sigma$ 已知时 $$Z=\frac{\bar X-\mu_0}{\sigma/\sqrt n}\overset{H_0}{\sim}N(0,1)$$

    与置信区间用的是同一个枢轴量,只是把 $\mu$ 换成了假设值 $\mu_0$

  3. 小概率原理:小概率事件在一次试验中几乎不会发生。给定显著性水平 $\alpha$(如 $0.05$),$P_{H_0}(|Z|\ge z_{\alpha/2})=\alpha$。
  4. 拒绝域:$|z|\ge z_{\alpha/2}$。若观测值落入拒绝域,说明“若 $H_0$ 真,就发生了小概率事件”,于是拒绝 $H_0$。

    反证法:假设成立推出“几乎不可能的事”,所以假设不成立。只不过这里的“矛盾”是概率意义上的,所以会以 $\alpha$ 的概率犯错

  5. $p$ 值:在 $H_0$ 下出现“与观测一样极端或更极端”结果的概率: $$p=P_{H_0}(|Z|\ge|z_{\text{obs}}|)=2\big(1-\Phi(|z_{\text{obs}}|)\big)$$ $p\le\alpha\iff$ 观测值落入拒绝域。

    $p$ 值越小,数据与 $H_0$ 越不相容;它不是“$H_0$ 为真的概率”

  6. $\sigma$ 未知:用样本标准差 $s=\sqrt{\tfrac1{n-1}\sum(x_i-\bar x)^2}$ 代替 $\sigma$,统计量 $$T=\frac{\bar X-\mu_0}{s/\sqrt n}\overset{H_0}{\sim}t(n-1)$$

    $s$ 本身也在波动,分母可能偶尔偏小,使 $T$ 比 $Z$ 更容易出现大值,所以 $t$ 分布尾部更厚(见下一节“$t$ 分布 vs 正态”)

  7. 与置信区间等价:双侧水平 $\alpha$ 的检验拒绝 $H_0:\mu=\mu_0$ $\iff$ $\mu_0$ 不在 $1-\alpha$ 置信区间 $\bar x\pm t_{\alpha/2}(n-1)\dfrac{s}{\sqrt n}$ 内。

    两者都由 $|\bar x-\mu_0|\ge t\cdot s/\sqrt n$ 这一个不等式给出

  8. 与 $\chi^2$ 独立性检验同一思想:$H_0$:两个分类变量独立 → 统计量 $\chi^2=\dfrac{n(ad-bc)^2}{(a+b)(c+d)(a+c)(b+d)}$ → 若 $\chi^2\ge x_\alpha$(如 $3.841$)则拒绝 $H_0$。高中所说“犯错误的概率不超过 $0.05$”就是第一类错误概率 $\alpha$。

    只是统计量、分布换了:$t$ 检验比较均值,$\chi^2$ 检验比较“观测频数与独立时的期望频数”

检验步骤对照表

步骤 单样本 $t$ 检验 $\chi^2$ 独立性检验(高中)
$H_0$ $\mu=\mu_0$ 两个分类变量独立
统计量 $t=\dfrac{\bar x-\mu_0}{s/\sqrt n}$ $\chi^2=\dfrac{n(ad-bc)^2}{(a+b)(c+d)(a+c)(b+d)}$
$H_0$ 下的分布 $t(n-1)$ 近似 $\chi^2(1)$
拒绝域 $|t|\ge t_{\alpha/2}(n-1)$(双侧) $\chi^2\ge x_\alpha$(只看右侧)
$\alpha=0.05$ 临界值 $n=9$:$2.306$;$n\to\infty$:$1.96$ $3.841$($=1.96^2$)

两种检验的结论措辞相同:拒绝 $H_0$,即在 $\alpha$ 水平下认为有显著差异 / 有关联;不拒绝 $H_0$,是证据不足,不能说“证明了 $H_0$”。

提示

$3.841=1.96^2$ 不是巧合:$2\times2$ 表的 $\chi^2$ 统计量就是“两个比例之差”的 $z$ 统计量的平方,所以 $\chi^2$ 只看右尾,等价于 $z$ 的双侧检验。

易错

常见误解:“$p=0.03$ 说明 $H_0$ 为真的概率是 $3\%$”。错。$p$ 值是假设 $H_0$ 为真时得到这么极端数据的概率,方向是“数据 $\mid H_0$”,不是“$H_0\mid$ 数据”。

$t$ 分布 vs 正态

$t(\nu)$ 密度与标准正态:自由度越小,尾部越厚

\nu=4 的 t(4) 密度(紫实线)与 N(0,1) 密度(绿虚线);浅蓝柱为 5000 次模拟 T 的密度直方图。紫色短线标出 \pm2.776,绿色短线标出 \pm1.96;t 分布峰更低、尾更厚。
图 4$\nu=4$ 的 $t(4)$ 密度(紫实线)与 $N(0,1)$ 密度(绿虚线);浅蓝柱为 5000 次模拟 $T$ 的密度直方图。紫色短线标出 $\pm2.776$,绿色短线标出 $\pm1.96$;$t$ 分布峰更低、尾更厚。

取 $\nu=4$ 时:

临界值 $t_{0.025}(\nu)$ $P(\lvert T\rvert>1.96)$ 理论值 $P(\lvert T\rvert>1.96)$ 模拟值 $D(T)=\dfrac{\nu}{\nu-2}$
$2.776$ $0.1216$ $0.1224$ $2.000$

不同自由度下的临界值:

$\nu$ 1 2 5 10 30 60 $\infty$
$t_{0.025}$ 12.71 4.30 2.57 2.23 2.04 2.00 1.96
思路

小样本时若误用 $1.96$ 作临界值,实际第一类错误概率会超过 $5\%$:$\nu=4$ 时约为 $12\%$。这就是 $\sigma$ 未知时必须用 $t$ 分布的原因(统计学家戈塞特以笔名 Student 发表,所以也叫 Student $t$ 分布)。

提示

$\nu\ge30$ 左右时 $t$ 与正态已经很接近,所以大样本时常直接用 $z$ 近似。$t$ 分布要求总体近似正态;样本很小且总体明显偏态时要慎用。

单样本 $t$ 检验演示

逐步完成单样本 $t$ 检验

t(11) 分布(紫色曲线)与统计量观测值 t=1.228(黑色竖线)。红色阴影是双侧 p 值,即 |T|\ge1.228 的两侧尾部面积之和。
图 5$t(11)$ 分布(紫色曲线)与统计量观测值 $t=1.228$(黑色竖线)。红色阴影是双侧 $p$ 值,即 $|T|\ge1.228$ 的两侧尾部面积之和。

以一组 $n=12$ 的样本、$\mu_0=500$ 为例,计算过程如下。

  1. 假设:$H_0:\mu=500$,$H_1:\mu\ne500$,显著性水平 $\alpha=0.05$。
  2. 样本:$n=12$,$\bar x=501.575$,$\sum(x_i-\bar x)^2=217.1425$,$s=\sqrt{\dfrac{217.1425}{11}}=4.443$。
  3. 统计量: $$t=\frac{\bar x-\mu_0}{s/\sqrt n}=\frac{501.575-500}{4.443/\sqrt{12}}=1.228$$
  4. 拒绝域(自由度 $11$):$|t|\ge t_{\alpha/2}(11)=2.201$。
  5. $p$ 值 $=0.2451$ $>\alpha$:不拒绝 $H_0$。
  6. 对照:若误用 $N(0,1)$(把 $s$ 当成 $\sigma$),$p$ 值为 $0.2195$。

    小样本时 $t$ 分布尾部更厚,$z$ 检验会低估 $p$ 值

改变显著性水平或备择假设,其余步骤不变,只有拒绝域和 $p$ 值随之改变:

备择假设 $H_1$ $\alpha$ 拒绝域(自由度 $11$) $p$ 值 误用 $N(0,1)$ 的 $p$ 值 结论
$\mu\ne500$ $0.05$ $\lvert t\rvert\ge t_{\alpha/2}(11)=2.201$ $0.2451$ $0.2195$ 不拒绝 $H_0$
$\mu\ne500$ $0.1$ $\lvert t\rvert\ge t_{\alpha/2}(11)=1.796$ $0.2451$ $0.2195$ 不拒绝 $H_0$
$\mu\ne500$ $0.01$ $\lvert t\rvert\ge t_{\alpha/2}(11)=3.106$ $0.2451$ $0.2195$ 不拒绝 $H_0$
$\mu>500$ $0.05$ $t\ge t_{\alpha}(11)=1.796$ $0.1225$ $0.1097$ 不拒绝 $H_0$
$\mu<500$ $0.05$ $t\le -t_{\alpha}(11)=-1.796$ $0.8775$ $0.8903$ 不拒绝 $H_0$
注意

例 1 中,$\alpha=0.05$ 时结论是“拒绝”,改为 $\alpha=0.01$ 就变为“不拒绝”。结论依赖事先选定的 $\alpha$,所以 $\alpha$ 必须在看数据之前确定,不能看了 $p$ 值再挑。

例题精讲

包装重量的单样本 $t$ 检验

例 1原创例题

某品牌大米标注每袋 $500\text{ g}$。市场监管部门随机抽取 $9$ 袋,称得重量(单位:$\text{g}$)为 $493,\ 494,\ 495,\ 495,\ 497,\ 498,\ 499,\ 500,\ 502$。假设每袋重量服从正态分布 $N(\mu,\sigma^2)$,$\sigma$ 未知。

(1)求样本均值 $\bar x$ 与样本标准差 $s$;

(2)在显著性水平 $\alpha=0.05$ 下检验 $H_0:\mu=500$,$H_1:\mu\ne500$($t_{0.025}(8)=2.306$);

(3)在 $\alpha=0.01$ 下结论如何($t_{0.005}(8)=3.355$)?若误把 $s$ 当作已知的 $\sigma$ 用 $z$ 检验,$p$ 值会有什么变化?

建模思路

$\sigma$ 未知,用 $s$ 代替,统计量 $T=\dfrac{\bar X-\mu_0}{s/\sqrt n}$ 在 $H_0$ 下服从 $t(n-1)$。计算流程与上一节“单样本 $t$ 检验演示”完全相同。

解析

(1)样本均值与样本标准差

  1. 以 $497$ 为基准,偏差为 $-4,-3,-2,-2,0,1,2,3,5$,和为 $0$,所以 $\bar x=497$。

    减去一个“中间数”再算,计算量小

  2. 偏差平方和 $16+9+4+4+0+1+4+9+25=72$, $$s^2=\frac{1}{n-1}\sum(x_i-\bar x)^2=\frac{72}{8}=9,\quad s=3$$

    样本方差除以 $n-1$,这是 $t$ 检验所用的 $s$

答案:$\bar x=497$,$s=3$

(2)$\alpha=0.05$ 下的双侧检验

  1. $H_0:\mu=500$。检验统计量 $$t=\frac{\bar x-500}{s/\sqrt n}=\frac{497-500}{3/3}=-3$$
  2. 自由度 $n-1=8$,拒绝域 $|t|\ge t_{0.025}(8)=2.306$。
  3. $|t|=3>2.306$,落入拒绝域,拒绝 $H_0$:在 $\alpha=0.05$ 下认为平均重量与 $500\text{ g}$ 有显著差异(偏少)。

    $p$ 值 $=2P(T_8\ge3)\approx0.017<0.05$

答案:$t=-3$,拒绝 $H_0$

(3)$\alpha=0.01$ 时;误用 $z$ 检验

  1. $|t|=3<3.355$,不拒绝 $H_0$:在 $\alpha=0.01$ 下证据还不够。

    $p\approx0.017$ 介于 $0.01$ 与 $0.05$ 之间,所以两个水平下结论不同

  2. 若误用 $z$ 检验:$p=2P(Z\ge3)\approx0.0027<0.01$,会在 $\alpha=0.01$ 下也拒绝。
  3. 原因:$s$ 本身是随机的,小样本时 $t(8)$ 比 $N(0,1)$ 尾部更厚,同样的统计量 $3$ 在 $t(8)$ 下没那么“极端”。误用 $z$ 会低估 $p$ 值,更容易犯第一类错误。

答案:$\alpha=0.01$ 下不拒绝 $H_0$;误用 $z$ 检验会把 $p$ 值从约 $0.017$ 低估到约 $0.0027$

易错

“不拒绝 $H_0$”不等于“证明了 $\mu=500$”,只是说现有数据不足以推翻它。样本标准差要除以 $n-1$。

拒绝域与两类错误

例 2原创例题

某机床正常时加工的轴直径 $X\sim N(10,0.3^2)$(单位:$\text{mm}$)。质检规则:每天抽 $9$ 根测平均直径 $\bar x$,若 $|\bar x-10|\ge c$ 就判定“机床异常”并停机检修。

(1)要使机床正常时被误判为异常的概率为 $0.05$,求 $c$;

(2)若机床实际已偏移到 $\mu=10.3$($\sigma$ 不变),按(1)的规则,没能发现异常的概率是多少?

(3)把每天抽样数改为 $16$ 根,保持第一类错误概率 $0.05$,重新求 $c$ 与(2)中的概率。

参考数据:$\Phi(1.04)\approx0.8508$,$\Phi(2.04)\approx0.9793$,$z_{0.025}=1.96$。

建模思路

$H_0:\mu=10$。“正常时误判异常”是第一类错误 $\alpha$,“异常时没发现”是第二类错误 $\beta$。两者都由 $\bar X$ 的分布算出,只是一个在 $H_0$ 下算,一个在真实的 $\mu=10.3$ 下算。

解析

(1)由 $\alpha=0.05$ 求 $c$

  1. $H_0$ 下 $\bar X\sim N\!\left(10,\left(\tfrac{0.3}{3}\right)^2\right)=N(10,0.1^2)$。
  2. 由 $$P(|\bar X-10|\ge c)=0.05\iff P\!\left(\left|\dfrac{\bar X-10}{0.1}\right|\ge\dfrac c{0.1}\right)=0.05\iff\dfrac c{0.1}=1.96$$ 得 $c=0.196$。

答案:$c=0.196$

(2)$\mu=10.3$ 时漏检的概率 $\beta$

  1. 漏检 $\iff$ 没有落入拒绝域 $\iff 9.804<\bar X<10.196$。此时 $\bar X\sim N(10.3,0.1^2)$。

    第二类错误:$H_0$ 假,却没有拒绝 $H_0$

  2. 标准化:$\dfrac{9.804-10.3}{0.1}=-4.96$,$\dfrac{10.196-10.3}{0.1}=-1.04$。
  3. $$\beta=\Phi(-1.04)-\Phi(-4.96)\approx(1-0.8508)-0\approx0.149$$

    $\Phi(-4.96)$ 约 $3.5\times10^{-7}$,可忽略

答案:$\beta\approx0.149$

(3)样本量改为 $16$

  1. 标准误 $\dfrac{0.3}{4}=0.075$,$c=1.96\times0.075=0.147$。

    样本多了,$\bar x$ 更集中,阈值可以收紧

  2. 漏检区间 $9.853<\bar X<10.147$,在 $\bar X\sim N(10.3,0.075^2)$ 下标准化:$\dfrac{10.147-10.3}{0.075}=-2.04$,$\dfrac{9.853-10.3}{0.075}\approx-5.96$。
  3. $$\beta\approx\Phi(-2.04)=1-0.9793=0.0207$$
  4. 结论:$\alpha$ 固定时,增大样本量能显著减小 $\beta$;样本量固定时,减小 $\alpha$($c$ 变大)会使 $\beta$ 增大。

答案:$c=0.147$,$\beta\approx0.021$

易错

$\alpha+\beta\ne1$:$\alpha$ 在 $H_0$ 成立时算,$\beta$ 在某个具体的备择 $\mu$ 下算,它们是两个不同分布下的概率。

课堂小测

课堂小测

对 $H_0:\mu=500$ 做检验,得 $p=0.03$。正确的说法是

查看答案与解析

答案C

解析

$p=0.03\le0.05$,拒绝 $H_0$;$p=0.03>0.01$,不拒绝 $H_0$。

辨析
  • A:$p$ 值是在 $H_0$ 为真的前提下算出的概率,不是 $H_0$ 为真的概率
  • B:$p$ 值不是“结论正确的概率”,在 $\alpha=0.05$ 下拒绝 $H_0$,犯第一类错误的概率由 $\alpha$ 控制
  • D:$p$ 值小只说明数据与 $H_0$ 不相容,不能说明差异大小(样本量大时极小的差异也会很显著)。
课堂小测

其他条件不变,只把显著性水平 $\alpha$ 从 $0.05$ 降到 $0.01$,则

查看答案与解析

答案A

解析

拒绝域缩小:更难拒绝 $H_0$,第一类错误概率下降,但 $H_0$ 假时更容易漏判,$\beta$ 增大。

辨析
  • B:$n$ 固定时两类错误此消彼长,要同时减小,需要增大样本量
  • C:$\alpha+\beta\ne1$,两者在不同的分布下计算($H_0$ 下与某个具体备择下)
  • D:拒绝域由 $\alpha$ 决定,$\alpha$ 变小,临界值变大,拒绝域变小,不会不变。
课堂小测

正态总体、$\sigma$ 未知,$n=9$。检验 $H_0:\mu=\mu_0$(双侧,$\alpha=0.05$)时应采用的拒绝域是

查看答案与解析

答案D

解析

$\sigma$ 未知用 $T=\dfrac{\bar x-\mu_0}{s/\sqrt n}\sim t(n-1)$,双侧取 $\alpha/2$。

辨析
  • A:$\sigma$ 未知不能用 $z$,用 $s$ 代替 $\sigma$ 后统计量服从 $t(8)$,临界值 $2.306$,比 $1.96$ 大
  • B:自由度是 $n-1=8$,不是 $9$
  • C:双侧检验要用 $\alpha/2=0.025$ 的分位数,$t_{0.05}(8)=1.860$ 是单侧的。
交互动图单独打开 ↗